
AutoScreen: AI Co-Scientist System for Target Discovery in Functional Genomics
原文链接:全文
作者:Yuanhao Qu, Xufeng Liu, Xiaotong Wang, …, Le Cong
bioRxiv,2026 年 9 月 10 日
导读
CRISPR 筛选可以一次产出成百上千个候选基因,但决定”先验证谁”仍是高度依赖文献整合和专家经验的耗时环节。AutoScreen 构建了一套由五个专门 AI Agent 组成的流水线,能够自动检索 26 个生物医学数据库、动态去除大模型对”明星基因”的偏好、并通过多配置融合给出可追踪的候选基因排序。在 320 个 CRISPR 筛选基准上,它的命中恢复率比通用大模型提高约 19%;在 NK 细胞杀伤实验中,成功将 MUC1、PDPN 和 LRRC15 从低排名提升至优先验证位置,并经湿实验确认。
一、研究问题
高通量功能基因组学技术——CRISPR 筛选、RNA-seq、GWAS——的瓶颈已经从”获得数据”转向”从数据中选对基因”。一次全基因组 CRISPR 筛选往往产出几百个统计显著的候选,研究者还需要逐一查文献、看通路、检查表达与药物可及性,才能决定后续验证顺序。
直接让大语言模型推荐基因会遇到一个根本问题:LLM 倾向于反复推荐 TP53、AKT1、MTOR 等”明星基因”,这些枢纽基因确实重要,但未必与当前实验的具体表型直接相关。这就是所谓的 fame bias。
AutoScreen 试图同时解决两个问题:实验前(Pre-screen)根据研究目标设计 focused 候选库——适用于无法做全基因组筛选、原代细胞数量有限或需要设计组合扰动实验的场景;以及实验后(Post-screen)结合统计结果与外部知识重新排序命中基因——在固定的已测基因范围内,把 MAGeCK 等工具给出的 P 值和 fold change 与文献证据、通路信息和临床数据相结合,重新确定后续验证顺序。
二、方法核心:系统架构:五个 Agent 的流水线
AutoScreen 的核心思路是把”让一个模型猜基因”拆解为一条结构化的证据整合管线。
Agent 1(Deep Research)把用户的研究描述改写为检索查询,并行获取 Google Scholar 文献、Web 信息和模型内部知识。它会分别总结各来源、合并为研究背景,并对总结中的句子进行证据核查,保存题目、URL、作者和发表日期等来源信息。这一阶段的目标是理解实验的生物学语境,而非直接输出基因。
Agent 2(Information Restructure)将自由文本拆解为八类标准化生物学实体——细胞系、基因、通路、GO 术语、疾病、表型、药物和细胞组分。例如,”黑色素瘤细胞抵抗 NK 细胞杀伤”会被拆解为生物系统 A375 melanoma、表型 NK-cell resistance、通路 immune evasion 和 cell-surface signaling 等,并映射到 HGNC、Reactome、KEGG、MONDO、EFO 等标准标识符。系统默认还进行两轮批评和修正。
Agent 3(Knowledge Base Search)是外部知识检索层,运行 26 个子 Agent 并行查询:通路和本体类(KEGG、Reactome、WikiPathways、MSigDB Hallmark、Gene Ontology),分子互作类(STRING、Ensembl paralogs、COXPRESdb),疾病与临床证据类(OMIM、ClinGen、ClinVar、Open Targets、TCGA),癌症驱动类(IntOGen)和药物信息类(PubChem、RxGrid)等数据库。在 Post-screen 模式下,还会整合用户自己的 CRISPR 筛选结果和 RNA-seq 差异表达数据。每个基因的最终输出都保留具体来源、对应术语、原始分数和元数据,而非只标记”模型认为重要”。
Agent 4(Information Synthesis)是最关键的创新环节。它首先为当前任务动态生成一组”反枢纽锚点”(anti-hub anchor):识别大模型可能过度推荐、但对当前实验不够特异的经典枢纽基因,作为软约束放入提示中。系统分别使用三种 anchor 长度(Hub 5、Hub 10、Hub 20)独立生成候选基因排名,再通过逆排名融合(inverse-rank fusion)合并为最终列表。
Agent 5(Target Review)对候选基因补充实验可操作性注释:目标细胞系表达、DepMap 细胞依赖性、DGIdb 药物可及性和文献支持。这些信息是标记而非硬过滤,最终报告保留完整证据链。
三、看图说话
Figure 1 · 五个 Agent 的协作流程
这张图想回答:AutoScreen 的五个 Agent 怎样从文献解读一路协作到靶点排名?
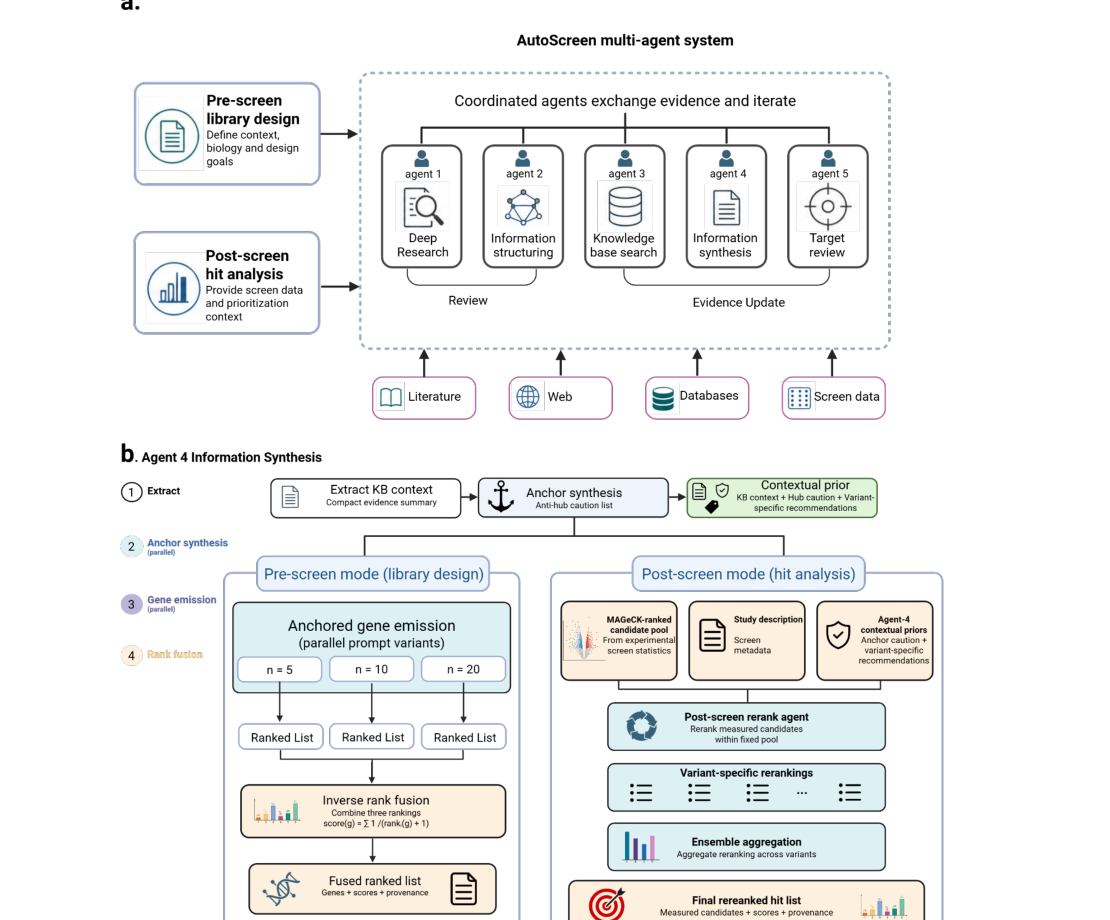
Figure 1. AutoScreen 系统架构。(a) 五个 Agent 的协作流程,支持 pre-screen 库设计与 post-screen 重排序两种模式;(b) Agent 4 通过多 anchor 配置生成排名并融合的工作流。
- Panel a:把「让一个模型猜基因」拆成一条流水线——Agent 1 把研究描述改写成检索查询、并行抓文献和网络;Agent 2 把自由文本拆成细胞系、基因、通路等八类标准化实体;Agent 3 并行跑 26 个子 Agent 查 KEGG、STRING、Open Targets 等数据库;Agent 5 补充表达、依赖性、药物可及性等可操作性注释。
- Panel b 是最关键的 Agent 4:它先动态生成一组「反枢纽锚点」(anti-hub anchor),把 LLM 爱反复推荐的明星基因(TP53、AKT1、MTOR)作为软约束压一压。效果很直接:自噬筛选里它把真正的执行机器 WIPI2、ATG2A、ATG9A 提到前 15,而不是泛泛的 MTOR;白喉毒素筛选里把 DPH1–DPH7 这组关键酶排到第 3–19 位。
Figure 2 · 320 个 CRISPR 筛选的基准
这张图想回答:在 320 个 CRISPR 筛选上,AutoScreen 的命中恢复率和排序精度如何?
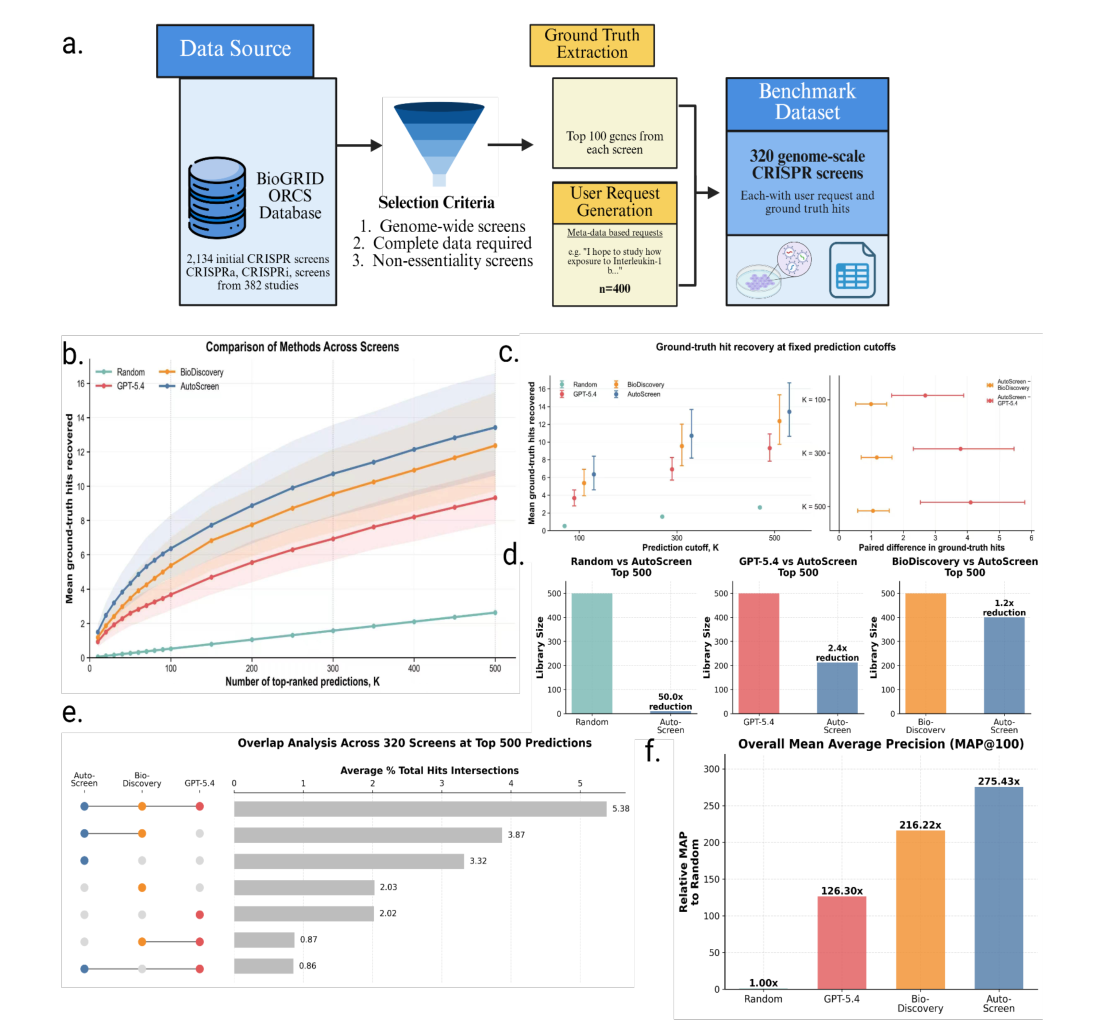
Figure 2. 320 个 CRISPR 筛选基准。(a) 数据构建流程;(b–c) 命中恢复率随候选库大小变化;(d) 库规模效率;(e) 方法间命中重合;(f) MAP@100 整体精度。
从 BioGRID ORCS 的 2,134 个筛选里按全基因组规模、元数据完整、非必需性三条标准筛出 320 个,把各筛选原分析的 top-100 基因当作 ground truth,让各方法仅凭研究目标描述推荐基因。
- Panel b–f:top-100 里 AutoScreen 恢复 6.4% 真实命中,高于 BioDiscovery 的 5.4%、GPT-5.4 的 3.8%(相对提升约 19%);MAP@100 达随机基线的 275 倍。要达到 AutoScreen top-500 同样的命中数,随机方法需要 50 倍大的库、GPT-5.4 需要 2.4 倍。
Figure 3 · 多配置融合提升恢复率
这张图想回答:为什么要用三种 anchor 长度再融合?它们找到的候选是同一批吗?
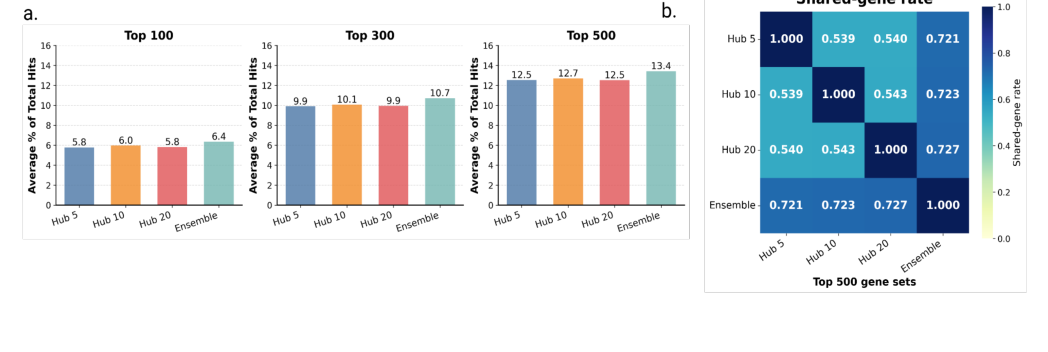
Figure 3. 跨 hub-list 配置的集成融合。(a) 单配置与融合排名在不同候选数下的验证命中恢复率。(b) 三种配置 top-500 基因集的两两共享率热图。
较短 anchor(Hub 5)更保守,较长 anchor(Hub 20)更激进地远离枢纽基因。Panel a 显示三种配置的恢复率相近,但 Panel b 的共享率热图里三者 top-500 两两只重合约 54%——说明它们探索的是不同但同样有价值的候选空间。逆排名融合(Ensemble)把在多个配置中都靠前的基因得分抬高,恢复率最高。
Figure 4 · 换不同大模型后端的表现
这张图想回答:AutoScreen 的优势依赖某个特定大模型吗,还是框架本身带来的?
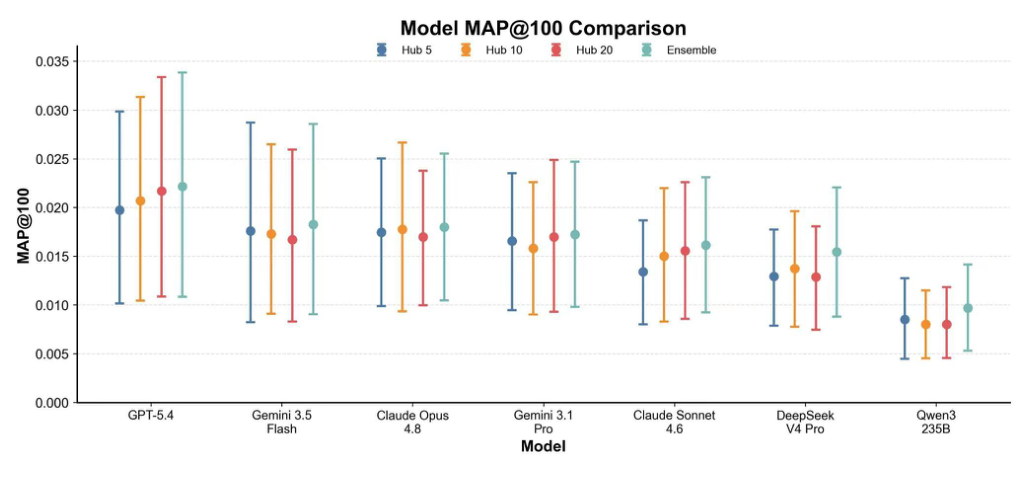
Figure 4. 七种推理后端在 207 个共同基准筛选上的 MAP@100 点线图,每种后端分别用 Hub 5 / Hub 10 / Hub 20 与 Ensemble 配置。
横轴是 GPT-5.4、Gemini、Claude、DeepSeek、Qwen3 等七个后端,每个后端画四种配置的 MAP@100。强模型(GPT-5.4)整体更高,但在推理型和非推理型模型上,多 anchor 集成(青色)普遍优于单配置。这说明性能提升主要来自「检索–锚定–融合」框架,而非某一个大模型。
Figure 5 · 免疫逃逸中的实验验证
这张图想回答:AutoScreen 的预测能通过湿实验验证吗?post-screen 和 pre-screen 各怎样?
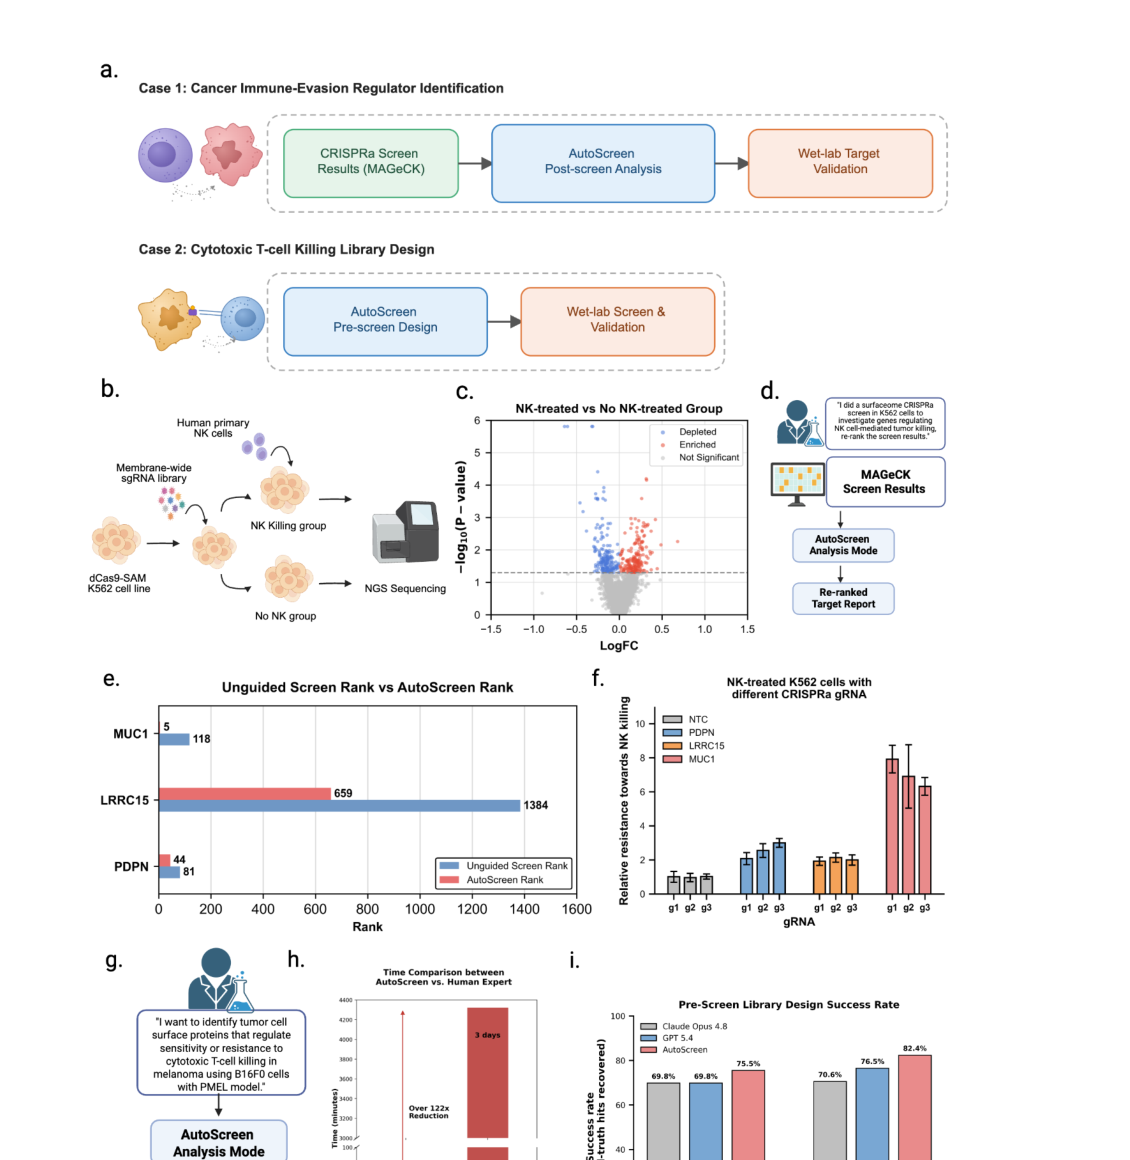
Figure 5. 癌症免疫逃逸中的验证。(a–f) post-screen:NK 细胞杀伤筛选的重排序与湿实验。(g–i) pre-screen:T 细胞杀伤的前瞻性候选库设计。
Post-screen(a–f):K562 surfaceome CRISPRa 筛选出 317 个候选,AutoScreen 重排序把 MUC1 从第 118 位提到第 5 位、PDPN 81→44、LRRC15 1384→659。用三条独立 sgRNA 的湿实验确认,激活这三个基因都显著提高 K562 对 NK 细胞杀伤的抵抗。
Pre-screen(g–i):在两个没给筛选数据的 T 细胞杀伤任务上,只凭研究问题设计 500 个候选,后续真实筛选确认 平均覆盖 77.1% 的共识命中,高于 Claude、GPT-5.4;整个设计平均 35.5 分钟,比人工约 3 天快 120 多倍。
Figure 6 · 从单次运行到 Resource Hub
这张图想回答:怎样把 AutoScreen 从一次性运行变成可复用、可扩展的资源库?
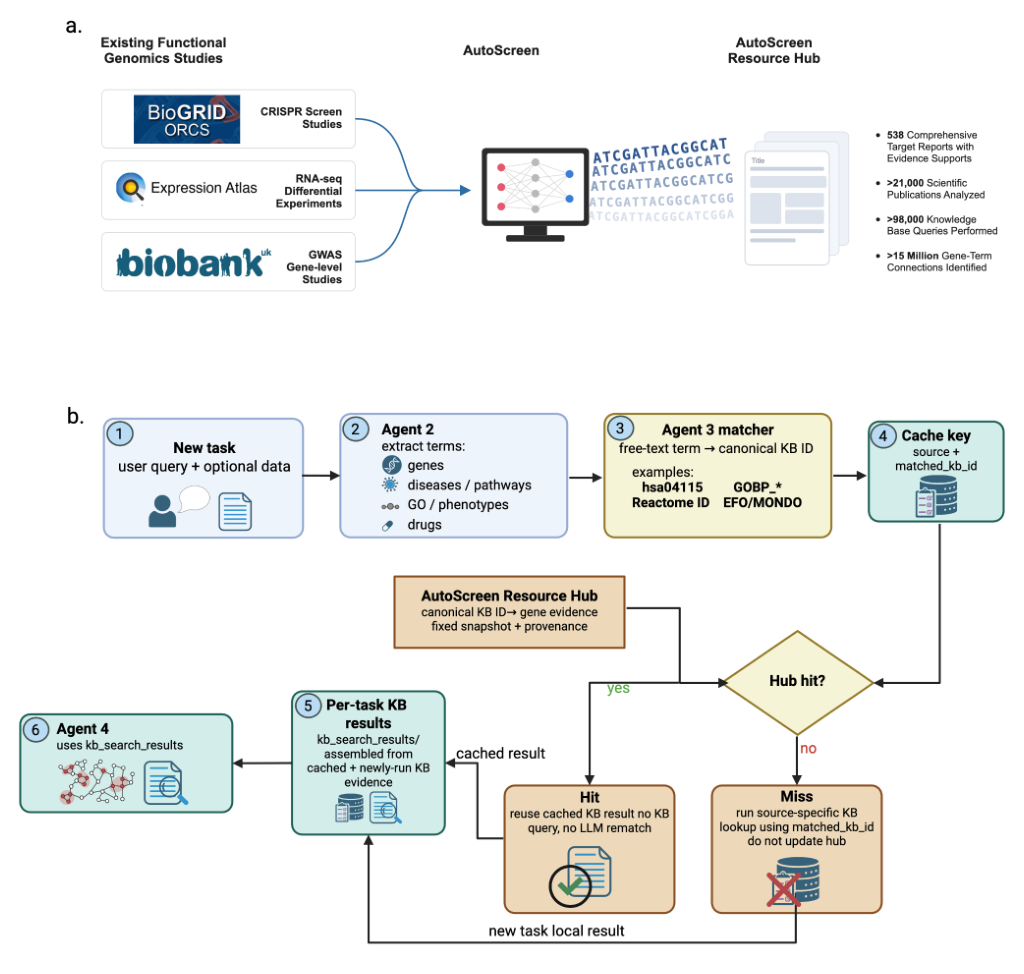
Figure 6. 构建与使用 AutoScreen Resource Hub。(a) 整合公开 CRISPR(BioGRID ORCS)、转录组(Expression Atlas)、GWAS(UK Biobank)数据的预计算资源库。(b) 以「数据库来源 + 标准标识符」为缓存键的命中/未命中流程。
对 500 多个公开功能基因组数据集跑完整管线,积累了 538 份靶点报告、超过 2.1 万篇文献、9.8 万次知识库查询、1,500 万个基因–术语连接。Panel b 的关键设计:稳定的基础知识(某基因属于某通路)按缓存键复用,但 最终基因排名仍由 Agent 4 针对当前实验重新生成,保证不同实验背景下排序不同。
四、核心贡献总结
Post-screen 验证:在 K562 白血病细胞的 surfaceome CRISPRa 筛选中,作者激活细胞表面蛋白并与原代人 NK 细胞共培养,MAGeCK 识别出 317 个显著候选。AutoScreen 对完整排名进行重排序后:
MUC1:从第 118 位提升至 第 5 位(细胞表面糖蛋白,可形成免疫屏障)
PDPN:从第 81 位提升至第 44 位(肿瘤表面糖蛋白,参与免疫调节)
LRRC15:从第 1384 位提升至第 659 位(与肿瘤微环境相关)
使用多个独立 sgRNA 的湿实验验证表明,激活这三个基因均能显著提高 K562 对 NK 细胞杀伤的抵抗。实验使用 E:T 比 2:1 的原代人 NK 细胞与 K562 共培养 24 小时,通过 IncuCyte 实时监测细胞存活。每个基因使用三条独立 gRNA,结果一致,降低了脱靶假阳性的可能。此外,在 A375 黑色素瘤的独立 CRISPRa 筛选中,AutoScreen 还将 CEACAM5(143→38)和 CEACAM6(155→26)整体提升,利用互作网络和临床证据识别出这一家族成员可能共同参与 NK 细胞免疫逃逸。
Pre-screen 前瞻性验证:在两个未提供筛选数据的 T 细胞杀伤任务中(B16F0–PMEL 和 MC38–OT-I),AutoScreen 在只知道研究问题的情况下设计 500 个候选基因,随后的真实 CRISPR 筛选确认:AutoScreen 平均覆盖了 77.1% 的共识命中,高于 Claude Opus 4.8(69.8%/70.6%)和 GPT-5.4(69.8%/76.5%)。整个设计过程平均仅需 35.54 分钟,相比人工专家的约 3 天缩短超过 122 倍。
Resource Hub:从单次运行到规模化资源
作者还将 AutoScreen 扩展为一个预计算资源库——对 500 多个公开功能基因组数据集(BioGRID ORCS 的 CRISPR 数据、Expression Atlas 的转录组数据、UK Biobank 的 GWAS 数据)运行完整管线,积累了 538 份综合靶点报告、超过 21,000 篇科学文献、98,000 次知识库查询和 1,500 万个基因–术语连接。系统使用”数据库来源 + 标准标识符”作为缓存键,稳定的基础知识(如某基因属于某通路)可以复用,但最终基因排名仍由 Agent 4 根据当前实验重新生成,从而保证不同实验背景下得到不同排序。
五、局限与展望
AutoScreen 的核心价值在于将原本分散的人工流程系统化——从研究问题到结构化生物学概念,到多数据库检索,到任务特异性去偏,再到多排序融合和实验可操作性审查。每一步都保留完整证据链,使得结果可审计、可追溯。语言模型在系统中被视为可替换后端:论文在 7 个不同模型上测试,多 anchor 集成的优势在推理型和非推理型模型上均成立,说明性能提升主要来自检索–锚定–融合框架。
但也需要注意几个局限。320 个公共基准的 Deep Research Agent 会查询文献和网络,可能检索到原始论文的结果,存在一定信息泄漏风险——论文通过两个 T 细胞任务做了前瞻性验证,但对公共基准未做去污染评估。top-100 的绝对恢复率仍只有 6.4%,说明仅凭描述预测筛选结果依然非常困难。湿实验验证规模较小(3 个基因),且 AutoScreen 与基线的计算预算不对等——它使用了多轮模型调用、26 个数据库和多配置融合,而 GPT-5.4 基线主要是单模型零样本生成。底层知识库本身仍偏向研究充分的疾病和高引用通路,anti-hub 能减轻对单个明星基因的偏好,但可能将偏差从”推荐最知名的单个基因”转变为”推荐知识库中最充分标注的机制模块”。
通讯作者介绍
本文标注的通讯作者有三位:Mengdi Wang(普林斯顿大学电气与计算机工程教授,强化学习和运筹学领域专家)、Xufeng Liu(斯坦福大学)以及 Le Cong(斯坦福大学病理学与遗传学助理教授,CRISPR 功能基因组学领域的活跃研究者)。作者名单中还包括 Russ Altman(斯坦福大学生物工程与遗传学教授)、Jure Leskovec(斯坦福大学计算机科学教授,图神经网络领域的开创者)和 Aviv Regev(基因泰克研究与早期开发部门负责人,单细胞基因组学先驱),但论文并未将这三位标为通讯作者。该研究整合了来自斯坦福大学、普林斯顿大学、MIT CSAIL 和基因泰克等机构的跨学科团队。
引用
Qu, Y., Liu, X., Wang, X., Chen, M., Luo, X., Lyu, L., … & Cong, L. (2026). AutoScreen: AI Co-Scientist System for Target Discovery in Functional Genomics. bioRxiv. https://doi.org/10.64898/2026.09.06.749678