
Robust deep learning–based protein sequence design using ProteinMPNN
原文链接:全文
作者:J. Dauparas, I. Anishchenko, N. Bennett, …, D. Baker
Science,2022 年 10 月 7 日
导读
蛋白质序列设计——给定目标骨架结构,寻找能折叠成该结构的氨基酸序列——是蛋白质工程的核心问题。传统方法依赖 Rosetta 等物理能量函数,计算成本高且需要专家手动调参。华盛顿大学 David Baker 实验室开发的 ProteinMPNN,基于消息传递神经网络,将设计速度提升两个数量级,天然序列恢复率从 32.9% 提高到 52.4%,并通过 X 射线晶体学、冷冻电镜和功能实验系统验证了设计蛋白质的正确折叠和生物活性。
一、研究问题
蛋白质设计的一个核心子问题被称为”逆折叠”:给定目标三维骨架坐标,找到一条氨基酸序列使其折叠成该结构。这一问题的困难在于:一个骨架通常对应多条可行序列,不存在唯一答案;局部残基之间存在复杂的空间相互作用;多聚体还需要同时优化链内和链间界面。Rosetta 等传统方法将此建模为物理能量优化问题,显式搜索大量侧链 rotamer 组合以寻找能量最低的序列。对于一个 100 残基蛋白质,Rosetta 单次设计需要约 4.3 分钟(单 CPU),且往往需要人工制定疏水残基分布、界面约束等规则。更关键的是,物理方法优化的只是目标构象中的能量,无法直接排除所有可能的错误折叠和聚集状态。在 Rosetta 的设计流程中,对表面疏水残基的限制、核心与边界区域的不同处理等通常需要丰富的领域专业知识,这大大限制了方法的普及和可重复性。
在 ProteinMPNN 之前,已有基于深度学习的逆折叠方法被提出,但它们主要面向单体蛋白质设计,在多链体系和对称结构上适用性有限,且缺乏系统的实验验证。ProteinMPNN 的目标是构建一个通用的深度学习序列设计工具,同时满足两个要求:广泛适用于单体、多聚体、对称体、纳米颗粒和功能蛋白等多种设计场景;通过结晶学、电镜和生化等多种实验手段,系统验证设计蛋白质的正确折叠与功能。
二、方法核心:ProteinMPNN 的核心方法
ProteinMPNN 将蛋白质表示为空间图:每个残基为一个节点,空间上相近的残基对构成边。模型以主链原子 N、Cα、C、O 和虚拟 Cβ 之间的距离作为输入特征。相比仅使用 Cα 距离或二面角的早期方法,这种丰富的原子间距离表示将序列恢复率从 41.2% 提升至 49.0%,是所有模型改进中贡献最大的一项。在此基础上引入编码器边特征更新,将恢复率进一步提高到 50.5%。
网络由 3 层编码器和 3 层解码器组成,隐藏维度 128,每个残基连接 32–48 个空间近邻。作者测试了 16 到 64 个近邻的不同设置,发现性能在 32–48 个邻居时饱和,表明序列选择主要由局部空间环境决定。编码器在图上反复传递消息,使每个位置获得其是否位于疏水核心、链间界面或暴露表面等三维环境信息;解码器以自回归方式逐步生成序列。训练数据包括 PDB 中 2021 年 8 月前分辨率优于 3.5 Å、残基数少于 10,000 的蛋白质组装体结构,经 MMseqs2 按 30% 序列一致性聚类后得到 25,361 个聚类。
随机解码顺序是 ProteinMPNN 的关键创新之一。传统自回归模型固定从 N 端到 C 端生成序列,在生成前端位置时无法利用后端已固定的功能位点信息。例如在蛋白质结合物设计中,靶标链序列已经确定,某些功能位点必须保留,只需要设计其余位置。固定解码顺序的模型难以充分利用这些已知信息。ProteinMPNN 在训练时从所有可能的排列中随机采样解码顺序,因此推理时可灵活选择解码策略:先将固定位置作为已知上下文输入,跳过这些位置,再设计剩余位置。这使模型能够处理保留催化残基、固定配体结合基序、只重设计部分区域、固定靶标链设计结合蛋白等多种实际需求。
对于同源多聚体设计,ProteinMPNN 提供了优雅的对称位置绑定机制。以同源三聚体为例,三条链中对称位置的氨基酸必须相同。模型对三个等价位置分别根据各自的局部三维环境计算 logits,然后取平均后从统一概率分布中采样,将同一氨基酸同时赋给三个对称位置。实测表明,平均 logits 策略使同源多聚体的中位恢复率达到 55%,优于不加对称约束的 52% 和平均概率的 53%。同一绑定机制具有广泛适用性:内部重复蛋白可以绑定各重复单元的对应位置;环状多聚体可以同时施加链间对称和链内重复约束;蛋白质纳米颗粒中多份等价亚基可以共享同一序列;甚至可以通过加权组合不同骨架的 logits 实现多状态设计,用正权重鼓励序列兼容目标构象、用负权重抑制不需要的状态。
三、看图说话
Figure 1 · 编码器-解码器架构
这张图想回答:ProteinMPNN 的架构怎样处理骨架几何、怎样生成序列?
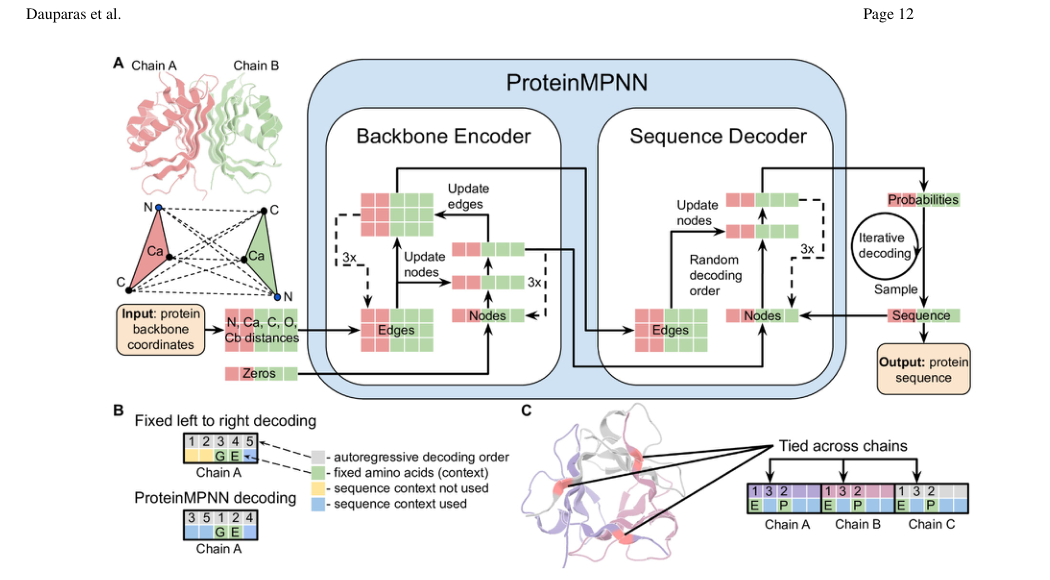
Figure 1. ProteinMPNN 架构。(A) 把 N、Cα、C、O 和虚拟 Cβ 之间的距离编码后用消息传递网络处理。(B) 编码器-解码器框架,支持随机解码顺序和对称位置绑定。
把蛋白表示成空间图(残基为节点、近邻连边),输入 N、Cα、C、O 和虚拟 Cβ 之间的距离。这组丰富的原子间距离把恢复率从 41.2% 提到 49.0%,是所有改进里贡献最大的一项。3 层编码器 + 3 层解码器、每残基连 32–48 个近邻。
两个关键创新:随机解码顺序(训练时随机采样生成顺序,推理时能先固定已知功能位点、再设计其余,支持保留催化残基、固定靶标链设计结合蛋白等);对称位置绑定(同源多聚体对称位置分别算 logits 再平均后采样,中位恢复率 55% 优于不加约束的 52%),还能扩展到重复蛋白、纳米颗粒、多状态设计。
Figure 2 · 计算评估
这张图想回答:序列恢复率在不同训练策略和采样温度下如何?噪声训练有什么用?
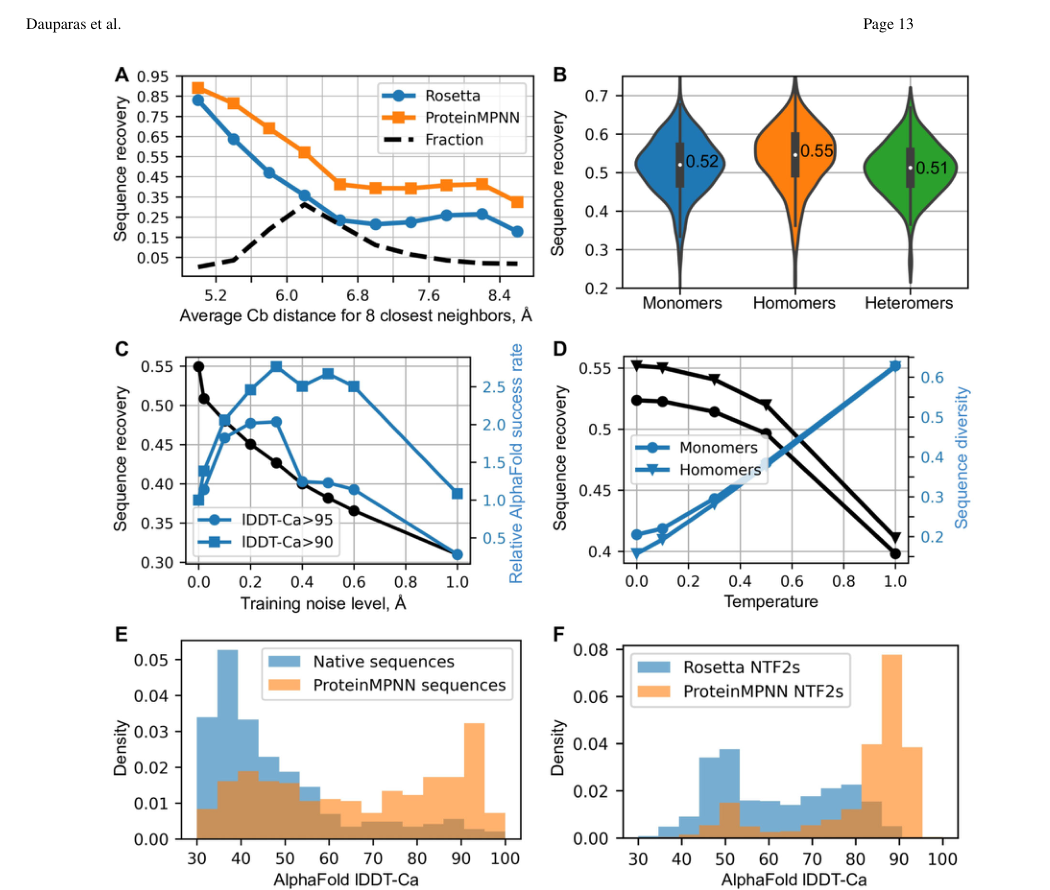
Figure 2. ProteinMPNN 的计算评估。(A) 恢复率高于 Rosetta。(B) 骨架噪声训练的效果。(C) 采样温度与序列多样性。(D) AlphaFold 结构预测验证。
- Panel A:402 个单体骨架上天然序列恢复率 52.4%,远超 Rosetta 的 32.9%(深埋核心 90–95%、暴露表面约 35%)。速度上 100 残基约 1.2 秒,比 Rosetta 快约 200 倍。
- Panel B:加骨架噪声训练会略降完美结构上的恢复率,但在 AlphaFold 预测骨架上反而更好、设计序列折回目标的成功率提高 2–3 倍——鲁棒性比恢复率更有意义。Panel C/D:温度控制多样性;ProteinMPNN 序列通常被 AlphaFold 更高置信度地预测回目标骨架(天然序列还受功能/调控等约束,不只优化稳定性)。
Figure 3 · 实验表征
这张图想回答:设计序列真能可溶表达、热稳定、结晶成目标结构吗?
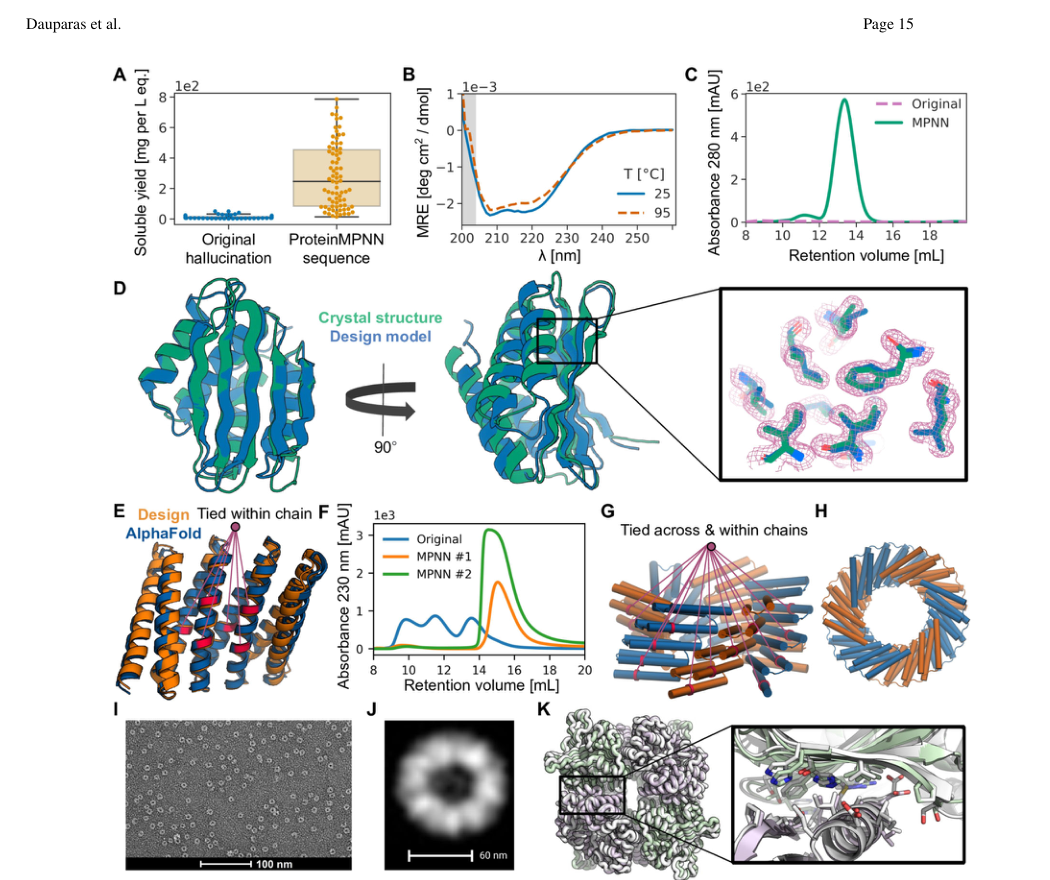
Figure 3. ProteinMPNN 设计的结构表征。(A) 可溶表达对比。(B) 热稳定性。(C) 晶体结构。(D) 纳米颗粒组装。
策略很严格:专门挑之前 Rosetta/AlphaFold 设计失败的蛋白,保留骨架、只换序列。AlphaFold hallucination 的 129 个骨架上原序列大多不溶(中位 9 mg/L),ProteinMPNN 重设计后 96 个里 73 个可溶表达、中位产量 247 mg/L(约 27 倍),95°C 仍保持二级结构。
晶体结构(PDB 8CYK,130 残基新颖折叠)与设计目标 RMSD 仅 2.35 Å;环状多聚体可溶比例 88%(Rosetta 40%);纳米颗粒设计 13 个形成约 1 MDa 组装体、晶体验证偏差 1.2 Å。整个序列设计全自动、每骨架约 1 秒。
Figure 4 · 功能蛋白设计
这张图想回答:保留功能基序、只重设计支架,能设计出有结合功能的蛋白吗?
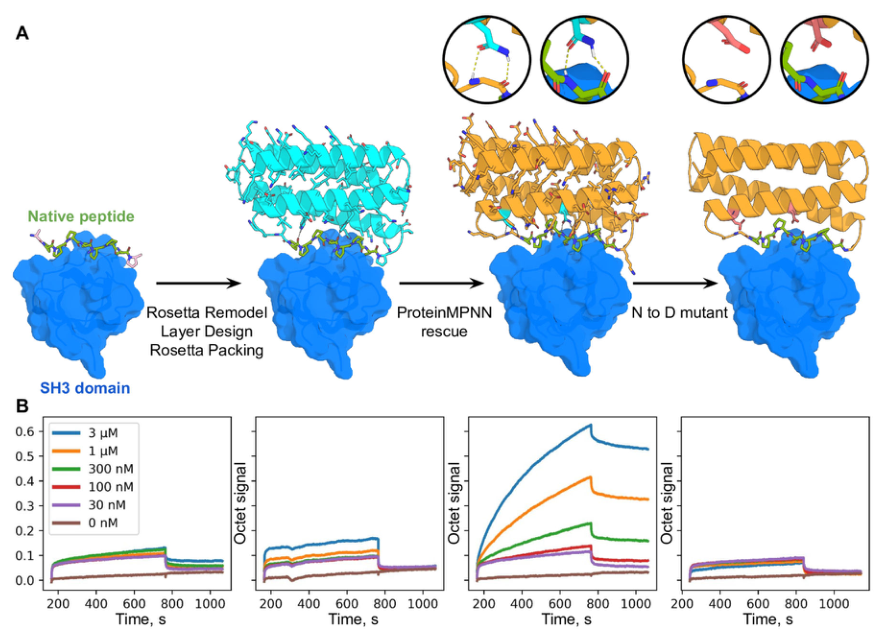
Figure 4. 用 ProteinMPNN 设计功能。(A) 设计方案:把富脯氨酸肽嵌入螺旋束、重设计支架、再做 N→D 突变对照。(B) 不同浓度下的 Octet(BLI)结合曲线。
最难的测试:设计能结合人 Grb2 SH3 结构域的蛋白——把富脯氨酸肽基序嵌进螺旋束支架。原始 Rosetta 序列无结合;ProteinMPNN 保留骨架和基序、只重设计周围支架后,BLI 测到比游离肽更强的结合信号(Panel B 第三格信号随浓度明显上升)。关键对照:把两个参与氢键网络的 Asn 突变成 Asp(N→D)后结合信号几乎消失,证明结合确实依赖 ProteinMPNN 设计的特定相互作用,而非非特异吸附。
四、核心贡献总结
ProteinMPNN 的贡献可以归纳为三点。
用深度学习替代物理能量函数做序列设计。把逆折叠建成骨架图上的消息传递,天然序列恢复率 从 Rosetta 的 32.9% 提到 52.4%,速度快约 200 倍,且不需要人工制定疏水分布等规则。
随机解码顺序 + 对称绑定带来通用性。同一个模型覆盖单体、多聚体、对称体、纳米颗粒、功能蛋白、固定靶标的结合蛋白等多种场景。噪声训练让设计对坐标扰动更鲁棒,折回目标的成功率提高 2–3 倍。
完整的实验证据链。专挑之前设计失败的骨架、只换序列,可溶产量提升约 27 倍,晶体结构、纳米颗粒组装、SH3 结合功能都得到验证,形成「设计合理→指标提高→可表达折叠→结构符合→功能实现」的闭环。
五、局限与展望
ProteinMPNN 主要面向蛋白质骨架和蛋白质—蛋白质界面设计,原始版本不包含对小分子配体、金属离子和核酸的显式建模。在酶活性位点或精细配体识别设计中,通常需要固定关键功能残基并结合其他优化方法。模型从 PDB 中约 25,000 个聚类的蛋白质结构学习,继承了训练数据的偏好和覆盖范围,对远离天然蛋白结构分布的极端新颖骨架,表现可能有所下降——不过本文测试了 hallucination 产生的新颖骨架、纳米颗粒和人工结合蛋白等多种非天然体系,结果表明泛化能力相当强。此外,ProteinMPNN 倾向于生成高稳定性序列,而某些生物功能需要构象柔性、亚稳态或特定的催化几何,设计时需注意通过固定功能残基来保留这些特性。
ProteinMPNN 对蛋白质设计领域的影响深远。它与结构预测模型构成闭环工作流:ProteinMPNN 从骨架生成候选序列,AlphaFold 或 RoseTTAFold 检验序列是否折回目标结构,通过计算筛选选出最有希望的候选进入实验。论文发表后,作者团队沿同一技术路线开发了 LigandMPNN(加入小分子配体建模)和 NA-MPNN(统一蛋白质与核酸设计),ProteinMPNN 本身也成为蛋白质设计流程中使用最广泛的序列设计工具,其代码已在 GitHub 开源(github.com/dauparas/ProteinMPNN)。这篇论文的核心贡献可以概括为一条完整的证据链:模型设计合理→计算指标提高→蛋白质可表达和折叠→实验结构符合设计→能够实现目标功能。
通讯作者介绍
David Baker 为本文通讯作者,现任华盛顿大学生物化学系教授、蛋白质设计研究所(Institute for Protein Design)所长、霍华德·休斯医学研究所研究员。Baker 于密歇根大学获得学士学位,于加州大学伯克利分校获得博士学位。他的研究方向涵盖蛋白质结构预测、从头蛋白质设计和计算酶设计,开发了 Rosetta 软件套件并推动了 ProteinMPNN、RFdiffusion 等新一代蛋白质设计工具的发展,因在计算蛋白质设计领域的开创性贡献获得 2024 年诺贝尔化学奖。本文第一作者 Justas Dauparas 在 Baker 实验室完成博士后研究期间主导了 ProteinMPNN 的模型设计与全面的大规模实验验证工作。
引用
Dauparas, J., Anishchenko, I., Bennett, N., Bai, H., Ragotte, R. J., Milles, L. F., … & Baker, D. (2022). Robust deep learning–based protein sequence design using ProteinMPNN. Science, 378(6615), 49-56. https://doi.org/10.1126/science.add2187