
BoltzDesign1: Inverting All-Atom Structure Prediction Model for Generalized Biomolecular Binder Design
原文链接:全文
作者:Yehlin Cho, Mateusz Pacesa, Zhe Zhang, Bruno E. Correia, Sergey Ovchinnikov
bioRxiv,2025 年 4 月 6 日
导读
蛋白结合物设计的核心挑战是:给定一个靶标分子,从头设计出能稳定折叠并与之结合的全新蛋白序列。现有生成方法(如 RfDiffusion)需要重新训练专门模型;而模型反演方法又面临扩散模块反向传播的巨大计算开销。BoltzDesign1 提出了一种巧妙的解决方案——冻结全原子结构预测模型 Boltz-1 的参数,直接优化 Pairformer 输出的距离概率分布(distogram),完全绕过 200 步扩散过程的反向传播。由此以较低计算成本实现蛋白、小分子、金属离子、核酸和翻译后修饰等多种靶标的结合物设计,在四种小分子基准上的计算成功率超过 RfDiffusionAA。
一、研究问题
蛋白结合物设计领域目前有两条主要技术路线。第一条是以 RfDiffusion/RfDiffusionAA 为代表的生成模型路线:将结构生成建模为扩散过程,对结构预测模型进行训练或微调以生成蛋白骨架,再用 ProteinMPNN 或 LigandMPNN 设计序列。优点是生成能力强,但骨架生成与序列设计是分离的两个阶段,且需要为新类型靶标重新训练。
第二条是以 BindCraft 为代表的模型反演路线:冻结结构预测模型参数,将蛋白序列作为可优化变量,根据结构置信度等指标定义损失函数,将梯度反向传播到输入序列。BindCraft 主要反演 AlphaFold2,其 Structure Module 相对适合端到端反向传播。
BoltzDesign1 属于第二条路线,但要反演的是 Boltz-1——一个与 AlphaFold3 类似的全原子、多分子类型结构预测模型,能同时处理蛋白、小分子、核酸、金属离子和翻译后修饰。核心障碍在于:Boltz-1 的最终原子结构由扩散模块经约 200 步去噪生成。直接通过扩散模块反向传播将带来巨大显存消耗、长链梯度消失,以及一次扩散只产生一个结构样本、优化可能过度依赖某个偶然采样出的构象等问题。
作者的核心洞察是:Boltz-1 的 Pairformer 模块在扩散生成三维结构之前,就已经通过 distogram 编码了残基对之间的距离概率分布。这个分布对每个残基对预测其落入 64 个距离区间各自的概率——包含了丰富的几何关系信息。直接优化这个概率分布,就能绕过昂贵的扩散过程。
二、方法核心:绕过扩散,优化距离分布
BoltzDesign1 的方法架构如上图所示。整个流程中,黑色箭头表示 Boltz-1 的正常预测路径,红色箭头表示反向优化路径。论文提出两种工作模式:
模式一:仅使用 Pairformer。梯度路径为 distogram loss → Pairformer → 序列。这是计算成本最低的路径:不需要生成三维结构,直接从距离概率分布获取优化信号。
模式二:Pairformer + Confidence module。扩散模块仍然前向生成三维坐标,但对坐标执行 stop-gradient(切断梯度传播)。Confidence module 基于这些坐标和 Pairformer 表征输出 pLDDT、PAE 等置信度指标。梯度通过 Confidence module 和 Pairformer 回传到序列,但不穿过约 200 步扩散过程。可以理解为:扩散模块负责”给出候选结构”,Confidence module 负责”打分”,但优化时不追踪候选结构的整个生成过程。
损失函数设计
蛋白内部接触损失:要求设计蛋白形成稳定的长程接触(接触阈值 14 Å),每个残基考虑两个重要接触。关键细节是忽略序列距离 <9 的近邻残基对——这样模型就不能通过只生成连续螺旋来满足接触要求,必须建立有意义的长程拓扑联系。
蛋白-靶标界面接触损失:确保设计蛋白与靶标形成可靠界面(阈值 22 Å)。对小分子靶标,作者发现若从一开始就要求每个残基尽量接触配体,蛋白会过度包裹小分子,导致游离态与结合态结构差异过大。因此采用”先折叠再结合”策略:先让蛋白独立形成基本折叠,二级结构建立后再加入配体,每步只优化一个最可靠的蛋白-配体接触(k=1)。虽然只直接优化一个接触,但为使这个接触高度可信,模型通常仍会形成其他辅助相互作用。
序列优化采用四阶段退火策略,从连续空间逐步过渡到离散氨基酸:第一阶段在连续 softmax 空间中广泛探索,每个位置可同时具有多种氨基酸概率;第二阶段通过 logits 与 softmax 的加权混合逐步过渡;第三阶段逐渐降低温度使概率分布越来越尖锐;第四阶段使用 straight-through estimator 在离散 one-hot 序列上优化——前向看起来是离散序列,反向仍通过连续概率传播梯度。
得到初始序列后,还可选择性地使用 LigandMPNN 进行二次序列设计。论文发现保留 BoltzDesign1 界面残基、只让 LigandMPNN 重设计非界面区域的策略效果最好。补充实验表明,即使让 LigandMPNN 完整重设计所有残基,界面位置对原始 BoltzDesign1 序列的恢复率也高于表面位置——这说明 BoltzDesign1 的界面序列具有较强合理性。
三、看图说话
Figure 1 · 绕过扩散的设计管线
这张图想回答:BoltzDesign1 怎样绕过 200 步扩散,直接优化距离分布来设计结合物?
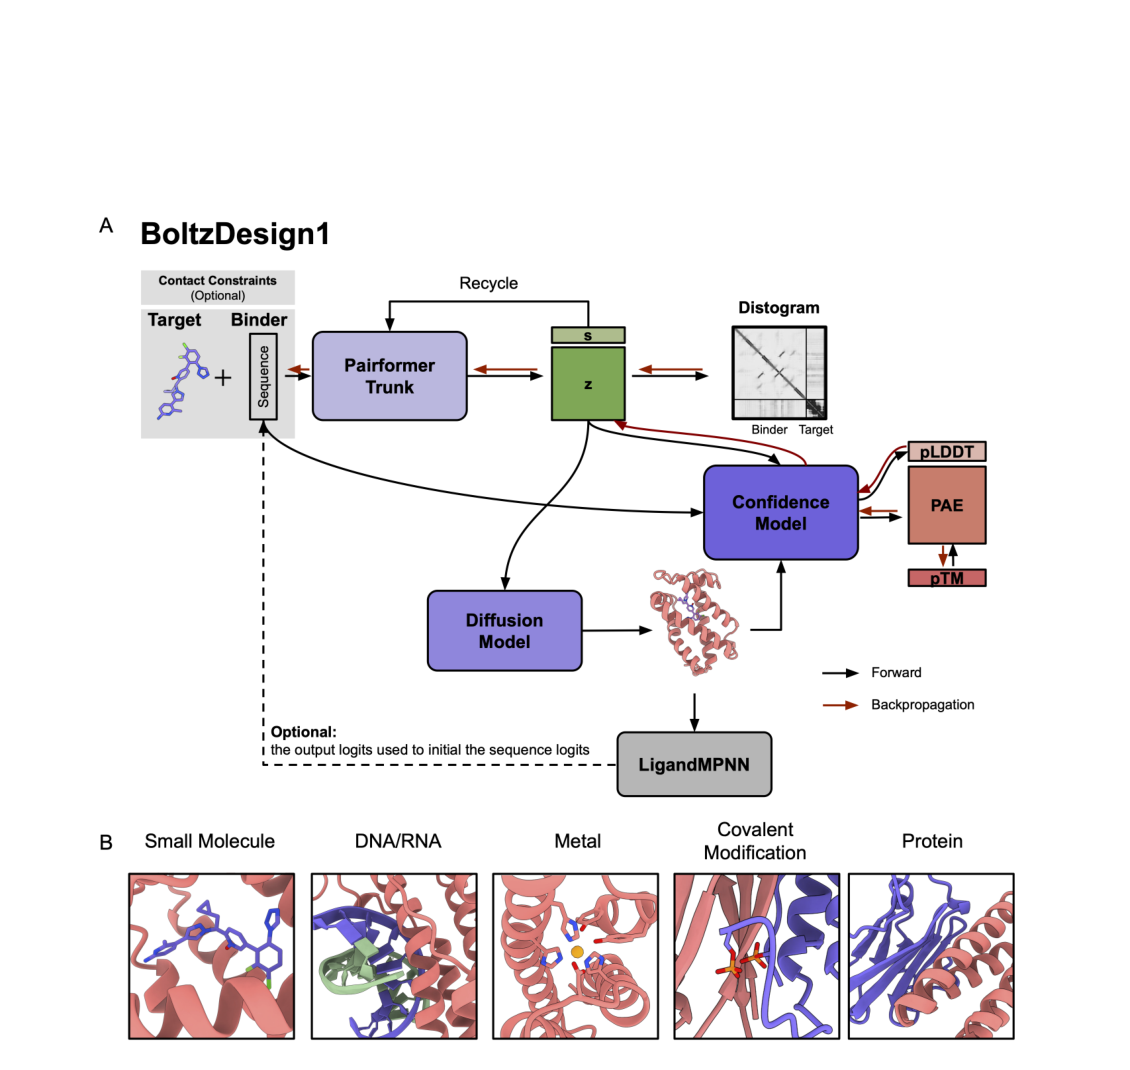
Figure 1. BoltzDesign1 管线。黑色箭头为 Boltz-1 正常预测路径,红色箭头为损失反向传播方向。s 为 single 表示,z 为 pair 表示。
核心是冻结 Boltz-1、把序列当可优化变量。模式一只用 Pairformer:梯度沿 distogram loss → Pairformer → 序列,完全不生成三维结构,成本最低。模式二加 Confidence module:扩散模块仍前向生成坐标但执行 stop-gradient,梯度只经 Confidence module 和 Pairformer 回传,不穿过 200 步扩散。
序列优化用四阶段退火,从连续 softmax 空间逐步过渡到离散 one-hot(straight-through estimator)。可选再用 LigandMPNN 只重设计非界面残基、保留 BoltzDesign1 的界面残基。
Figure 2 · distogram 能替代置信度吗
这张图想回答:只优化 Pairformer 的距离分布,真能反映折叠和界面质量吗?
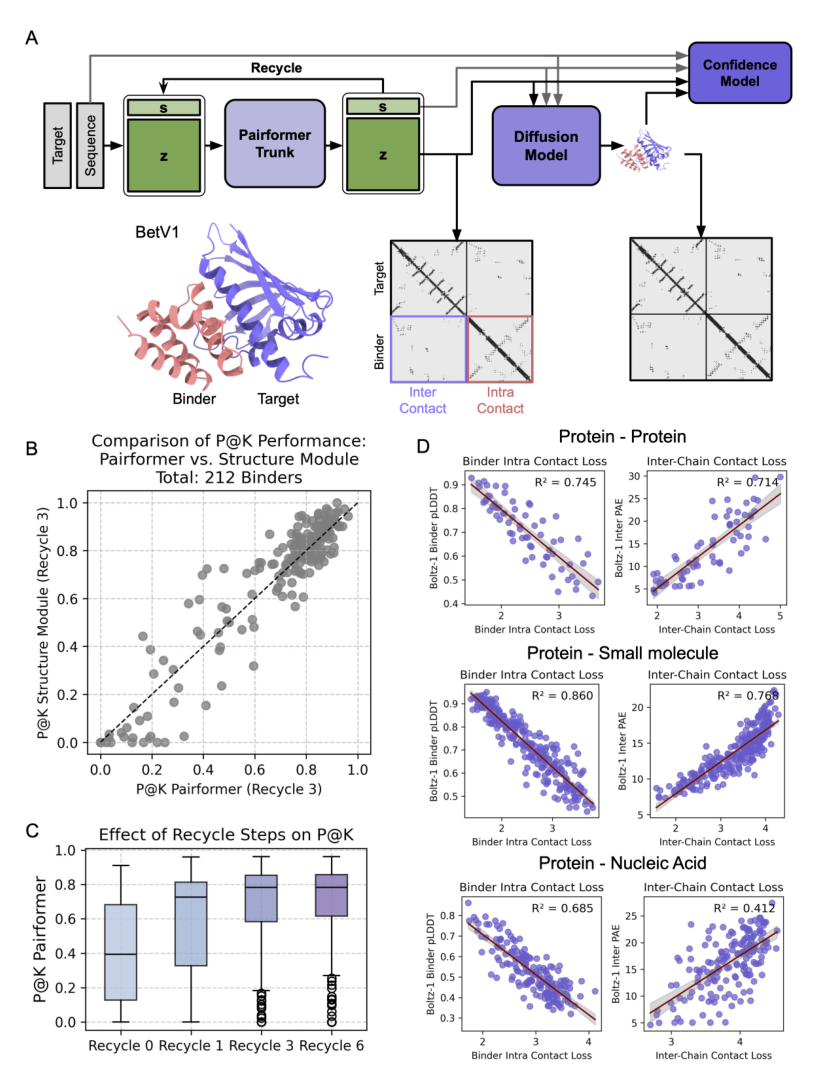
Figure 2. Pairformer distogram 有效捕捉蛋白与靶标的相互作用,可作为置信度的代理。(A) 架构与两种接触来源。(B) Pairformer 与结构模块的 P@K 对比(212 个结合物)。(C) recycle 步数对 P@K 的影响。(D) 蛋白–蛋白/小分子/核酸上接触损失与 pLDDT、inter-PAE 的相关性。
- Panel B:用 BindCraft 的 212 个成功结合物验证,76% 的设计里 Pairformer 接触预测的 P@K > 0.5——即概率最高的前 K 个接触中过半与真实界面吻合,说明不走扩散也能拿到可靠接触信号。
- Panel D:蛋白内部接触损失与 pLDDT、界面接触损失与 inter-PAE 都明显相关(蛋白–小分子 R² 达 0.86)。例外是核酸(R² 仅 0.412)——DNA/RNA 磷酸骨架重复接触多,只知「有接触」不够,所以核酸设计更依赖 Confidence module。
Figure 3 · 小分子结合蛋白的成功率
这张图想回答:设计的小分子结合蛋白在 AF3 / Boltz-1 重折叠下成功率如何?
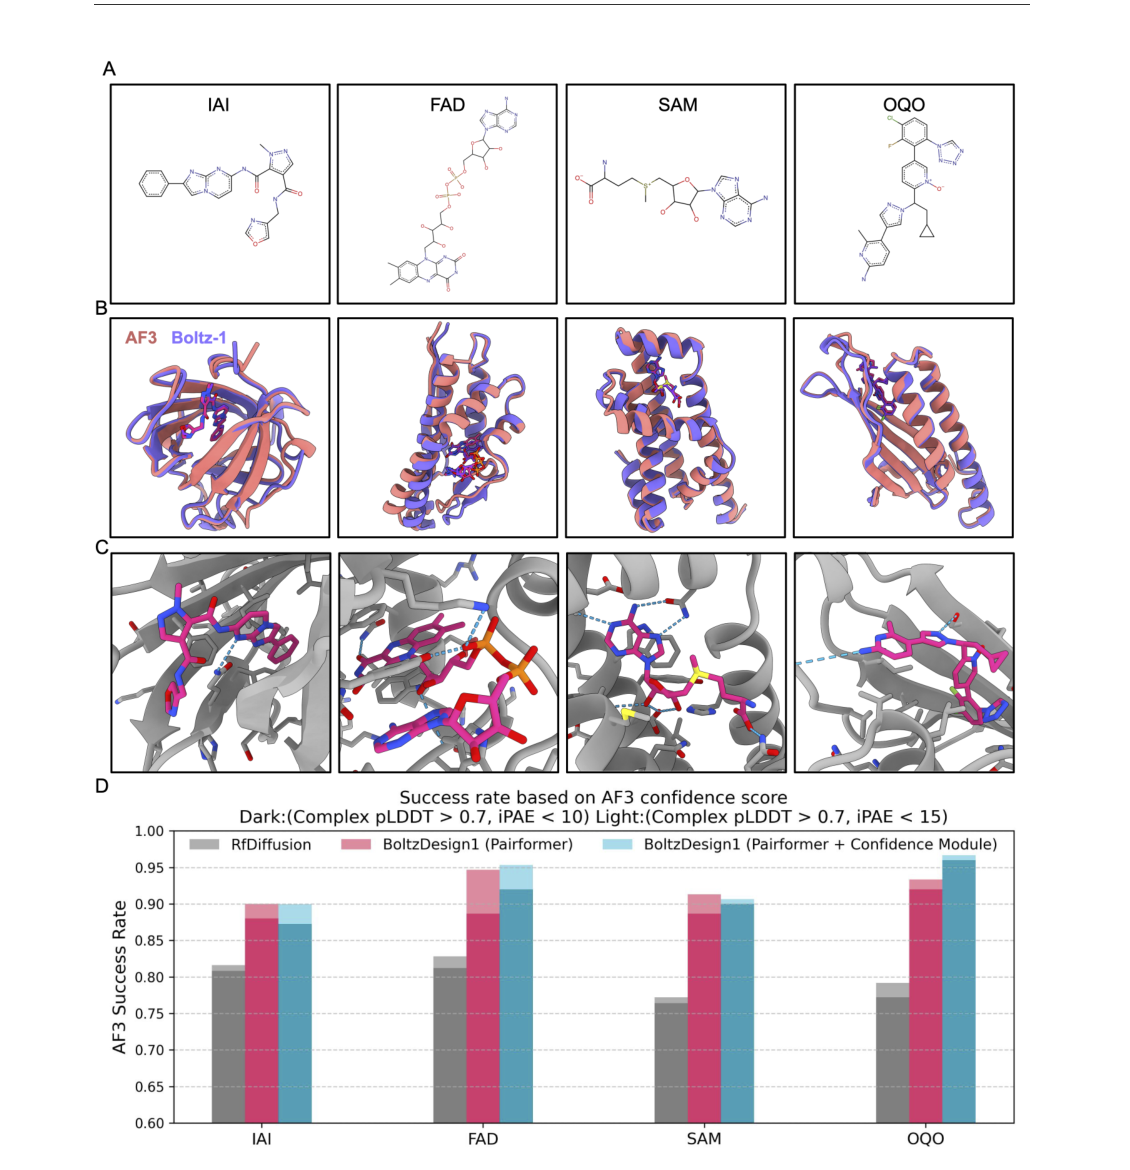
Figure 3. BoltzDesign1 设计的小分子结合蛋白可设计性高、AF3 成功率高。(A) 四种配体 IAI、FAD、SAM、OQO 的化学结构。(B) AF3(红)与 Boltz-1(蓝)预测结构叠合。(C) 结合口袋原子相互作用放大。(D) 两种模式的 AF3 成功率柱状图。
基准是 RfDiffusionAA 用过的四种配体。每个配体生成 30 个结构、各出 5 条序列,再用 AF3 独立重预测。Panel B 里 AF3 和 Boltz-1 对同一设计的预测高度叠合,Panel C 可见氢键、疏水包装和形状互补,Panel D 显示 BoltzDesign1 两种模式的 AF3 成功率均超过 RfDiffusionAA。
一个反直觉的发现:最佳配置用 recycle = 0。作者推测多轮 recycle 会让优化器找到「对抗性序列」——初始置信度低却被模型多轮抬高。对固定序列预测有帮助的步骤,在反演设计里可能适得其反。
Figure 4 · 结构与二级结构的多样性
这张图想回答:设计出来的蛋白折叠多样吗?能控制 α/β 比例吗?
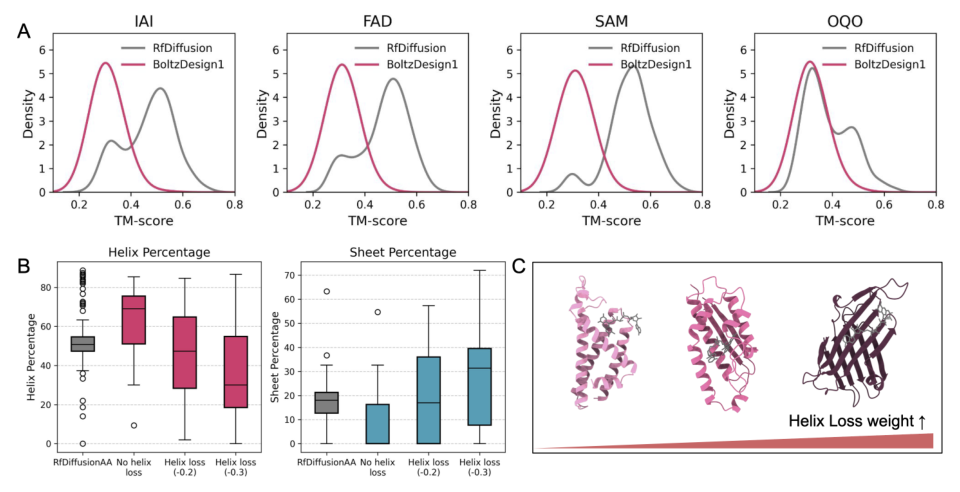
Figure 4. BoltzDesign1 生成高度多样的结构和二级结构组成。(A) 四个配体上 Boltz-1 设计与 RfDiffusion 设计的成对 TM-score 分布。(B) 不同 helix loss 权重下的螺旋/折叠占比。(C) 随 helix loss 增大结构从全螺旋转向含 β-sheet。
- Panel A:设计之间的平均成对 TM-score 为 0.36,低于 RfDiffusionAA 的 0.46(曲线更靠左),说明探索的折叠空间更广。Panel B、C:加大 helix loss 权重,β-sheet 比例随之上升,结构从全螺旋逐步变成含折叠片——说明二级结构组成可控。
Figure 5 · 扩展到金属、核酸与修饰
这张图想回答:同一框架能不能设计金属离子、DNA 和翻译后修饰的结合蛋白?配位几何对吗?
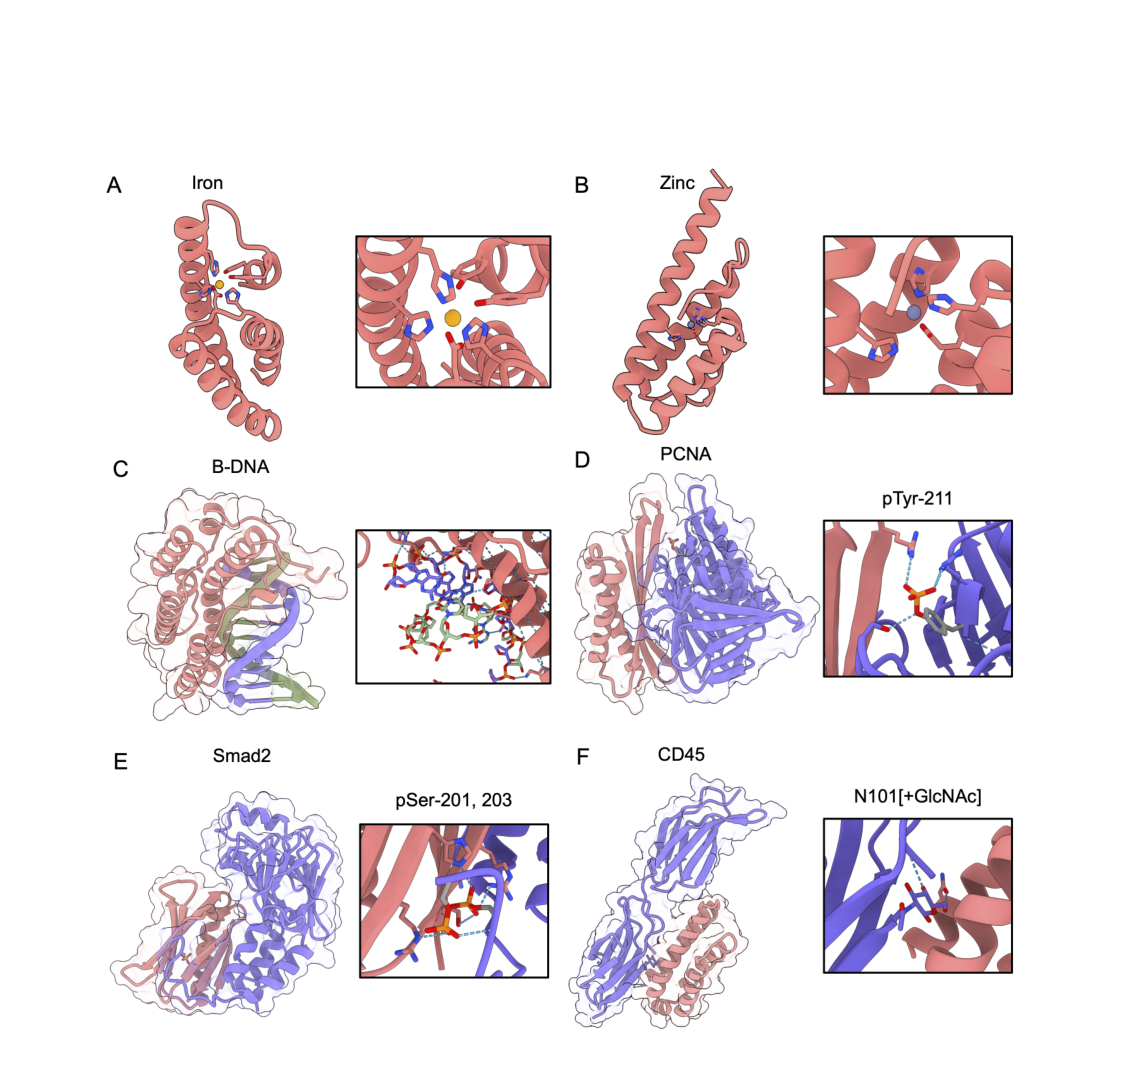
Figure 5. BoltzDesign1 可设计 AF3 预测能结合金属离子、核酸和其他生物分子的序列与结构。(A) 铁、(B) 锌结合蛋白;(C) DNA 结合蛋白;(D–F) 磷酸化/糖基化等翻译后修饰的特异性结合蛋白。
- Panel A、B 金属:铁结合位点呈预期的八面体配位、锌呈四面体配位,界面出现 Tyr、Asp、His 等典型配位残基(但未经光谱/滴定实验验证选择性)。Panel C DNA:设计蛋白沿 B-DNA 表面排列,界面富含 Lys、Arg 与磷酸骨架成氢键,但「一般亲和力」与「序列特异识别」还难区分。
- Panel D–F 翻译后修饰:针对 PCNA 磷酸化、Smad2 磷酸化、CD45 糖基化位点设计结合蛋白,界面同时接触蛋白本体和修饰基团。但只展示了正向结合结构,尚未评估对未修饰状态的负向选择性。
四、核心贡献总结
作者使用 RfDiffusionAA 论文中的四种小分子(IAI、FAD、SAM、OQO)作为基准,涵盖不同大小、柔性和化学特征的配体。每个配体生成 30 个初始结构,每个结构用 LigandMPNN 生成 5 条序列,随后用 AlphaFold3 独立重新预测复合物结构。成功标准分为两级:严格标准要求 complex pLDDT > 0.7 且 iPAE < 10,宽松标准将界面条件放宽至 iPAE < 15。
上图展示了四种小分子的设计结果。Panel A 为四种配体的化学结构;Panel B 展示 AF3(红色)与 Boltz-1(蓝色)对同一设计的预测结构叠合,二者高度一致;Panel C 放大了结合口袋的原子相互作用,可见氢键(蓝色虚线)、疏水包装和形状互补;Panel D 的柱状图显示,BoltzDesign1 两种模式的 AF3 计算成功率(complex pLDDT > 0.7 且 iPAE < 10)均高于 RfDiffusionAA 基线。在四个配体中的三个上,加入 Confidence module 比仅使用 Pairformer 更好。
值得注意的是,最佳配置出乎意料地使用 recycle = 0。通常 recycling 会改善结构预测,但作者推测在反向设计中,更多循环可能让优化器找到”对抗性序列”——这些序列初始置信度低,却在多轮循环后被模型错误提升为高置信度。这提示一个重要洞察:对固定序列的结构预测有帮助的计算过程,在通过梯度搜索序列的模型反演中可能适得其反。
其他关键指标
结构多样性:设计之间的平均成对 TM-score 为 0.36,低于 RfDiffusionAA 的 0.46,说明 BoltzDesign1 能探索更广泛的蛋白折叠空间。通过调整 helix loss 权重,还能控制二级结构组成——随着该损失绝对值增加,β-sheet 比例上升。
跨模型一致性:Boltz-1 与 AF3 对同一设计预测出相近结构(RMSD 普遍 < 2 Å),表明设计不太可能只是”骗过”单一模型。不过两个模型架构相似,这不构成完全独立的验证。
对接评分:部分设计的 Gnina CNN VS 评分超过了天然蛋白-配体复合物(SAM 9.3%、OQO 7.3%、IAI 4.0%),这是积极的计算信号,但对接评分不能等同于实验结合亲和力。
与”先生成骨架再独立设计序列”的方法相比,BoltzDesign1 从一开始就把氨基酸身份纳入优化,因此能直接设计氢键、芳香堆积、金属配位等精细化学相互作用。同时,设计过程中配体构象可以同步调整——每轮优化中配体可采用新构象,更接近 induced fit 的真实场景,适合天然构象未知或柔性配体的情况。
扩展到金属、核酸和翻译后修饰
BoltzDesign1 继承了 Boltz-1 全原子、多分子类型的表示能力,因此可用统一框架处理多种靶标类型。
金属离子结合物(Panel A-B):设计了铁和锌结合蛋白,经 LigandMPNN 重设计和 AlphaFold3 预测后,再用 AllMetal3D 分析金属类型和配位几何。铁结合位点呈现预期的八面体配位几何,锌位点呈现四面体配位,界面出现 Tyr、Asp、His 等典型金属配位残基。这说明全原子模型能处理金属配位环境,但尚未通过光谱或金属滴定实验验证金属选择性和结合亲和力。
DNA 结合物(Panel C):设计的蛋白沿 B-DNA 表面排列,与双螺旋外形具有良好的形状互补性。界面富含 Lys、Arg 等正电荷残基,与磷酸骨架形成氢键,部分相互作用可能涉及碱基边缘的特异性识别。但区分”与磷酸骨架的一般性 DNA 亲和力”和”对特定碱基序列的特异性识别”需要更深入的验证。作者也承认,核酸任务中 distogram 与界面置信度的相关性较弱(R² = 0.412),DNA/RNA 结合物设计仍不成熟。
翻译后修饰特异性结合物(Panel D-F):这是论文最具前瞻性的应用方向。作者设计了针对 PCNA Tyr-211 磷酸化、Smad2 Ser-201/203 磷酸化和 CD45 Asp-101 糖基化位点的结合蛋白。方法上,将指定接触位置和修饰位置编码为额外输入特征。预测结构显示,设计界面同时接触靶蛋白本体和修饰基团(磷酸基团或糖基),在结构层面具备修饰特异性的基础。理想的修饰特异性结合物需要区分未修饰蛋白和特定位点被修饰后的蛋白,但论文只展示了正向结合结构,尚未系统评估对未修饰状态的负向选择性。
五、局限与展望
论文最大的局限是全部结果均为计算预测,没有任何实验验证。高 pLDDT、低 iPAE 或高对接评分不能保证蛋白能表达、具有良好溶解性、正确折叠或真实结合靶标。论文的所有评估工具——Boltz-1、AlphaFold3、LigandMPNN、Gnina、AllMetal3D——彼此并非完全独立,因此跨模型一致性虽然有价值,但不能作为真正的独立验证。
其他值得关注的局限包括:recycle = 0 的最优配置暗示梯度优化可能在利用模型的内在漏洞,存在对抗性解的风险;当前版本不支持模板输入,限制了对已知骨架的约束和对特定口袋几何的精确复现;缺少负向设计——论文只优化”结合目标”,但实际应用中还需要明确惩罚与同源蛋白、相似配体或未修饰状态的非特异性结合;模型没有整合核酸多序列比对,核酸结合物设计的成熟度明显低于蛋白和小分子任务。
尽管如此,BoltzDesign1 提供了一条有前景的技术路线:通过反演预训练的全原子结构预测模型进行通用结合物设计,避免了为每种新靶标类型重新训练生成模型的需要。其真实的实验成功率、结合亲和力和修饰选择性仍需系统的湿实验验证。
通讯作者介绍
本文唯一标注的通讯作者是 Sergey Ovchinnikov(通讯邮箱 so3@mit.edu),署名单位为麻省理工学院(MIT);共同作者 Bruno E. Correia 任职于瑞士洛桑联邦理工学院(EPFL)蛋白质设计与免疫工程实验室,研究方向为计算蛋白质设计、疫苗免疫原设计和蛋白质工程。Ovchinnikov博士毕业于 MIT,在蛋白质共进化分析、结构预测和深度学习蛋白设计领域有开创性工作,是 ColabFold 等广泛使用的结构预测工具的核心开发者,曾获 NSF CAREER Award。
引用
Cho, Y., Pacesa, M., Zhang, Z., Correia, B. E., & Ovchinnikov, S. (2025). BoltzDesign1: Inverting All-Atom Structure Prediction Model for Generalized Biomolecular Binder Design. bioRxiv. https://doi.org/10.1101/2025.04.06.647261