
Allofusion: Allosteric Site Prediction Based on Language Models and Multi-Feature Fusion
原文链接:全文
作者:Jiabin Huang, Dongliang Guo, Yapeng Liu, Yanfen Wang, Mengya Lv
Journal of Chemical Information and Modeling,2025 年 8 月 1 日
导读
变构位点预测对药物发现至关重要,但传统方法先找口袋再分类,约 18.3% 的变构残基根本不在可检测口袋里。AlloFusion 提出残基级多模态预测框架,将 ProtT5 蛋白语言模型 embedding、进化 PSSM 和生化动态特征融合为 1047 维残基向量,用一维卷积网络直接判断每个残基是否属于变构位点。在 90 个蛋白的测试集上 F1 达 0.560,AUC 达 0.953,全面超越 PASSer 系列口袋方法;在 24 个独立蛋白上成功预测 23 个变构位点。
一、研究问题
蛋白质上的变构位点(allosteric site)是远离活性中心的调节区域——配体在此结合后通过改变蛋白构象或动态行为,间接影响催化或信号功能。变构药物具有更高选择性且无需与天然底物竞争,是当前药物发现的重要方向,已有多个变构药物获批上市或进入临床试验。但变构位点极难预测:有些只在特定构象中短暂出现(隐蔽位点),有些位于平坦表面不形成典型口袋,还有些在进化上高度多样。更重要的是,变构效应的本质是残基之间的协同作用——一小部分关键残基直接介导配体结合和功能调控,而其他残基主要负责维持蛋白整体构象稳定性。准确识别这些关键残基对理解变构机制和设计变构药物都至关重要。
目前主流的计算方法分两步走:先用 Fpocket 等工具检测蛋白表面的候选口袋,再用机器学习判断哪个口袋可能是变构位点。这个流程有一个根本瓶颈:如果真实变构位点不被第一步的口袋检测所发现,后续分类模型再好也无法预测它。文献报道约 18.3% 的变构位点形成残基(AFR)位于可检测口袋区域之外。此外,已有方法大多依赖静态结构或单模态特征,难以捕捉变构位点在序列、结构和动态上的多维信号。
AlloFusion 的核心思路是绕过口袋检测这一前提,直接在残基层面进行二分类:对蛋白质序列中的每个残基,判断它是否属于变构位点形成残基(AFR)。这使得即使位于平坦表面或非典型几何区域的残基也有可能被识别。与此同时,AlloFusion 融合蛋白语言模型表示、进化保守性和物理化学性质三种互补模态的信息来全面刻画每个残基的多维特性,从根本上提高变构位点识别的准确性和覆盖率。
二、方法核心:绕过口袋检测,在残基层面融合三类特征
AlloFusion 将每个残基表示为一个 1047 维特征向量,融合三类信息:
ProtT5 Embedding(1024 维):ProtT5 是在大规模蛋白质序列数据(BFD 和 UniRef50)上预训练的 Transformer 模型,每个残基对应一个 1024 维向量。由于 Transformer 的注意力机制能捕捉远距离残基之间的关系,这一表示隐含了序列上下文、局部基序、长程依赖和潜在结构功能信息。作者进一步使用 LoRA(低秩自适应)对 ProtT5 的注意力层进行参数高效微调,使其更好地区分变构残基。微调后 Precision 从 0.285 提升至 0.710,AUC 从 0.772 升至 0.902。
PSSM 进化特征(20 维):通过 PSI-BLAST 三轮迭代搜索(E-value 阈值 0.001)得到的位置特异性评分矩阵。每个位置的 20 个数值反映该残基被 20 种标准氨基酸替代的进化倾向,描述残基保守性和功能约束。数值经 sigmoid 归一化到 [0, 1] 区间。
生化特征(3 维):疏水性(反映与配体的相互作用倾向)、溶剂可及表面积(反映残基在蛋白表面的暴露程度)和动态性质(ESSA z-score,基于弹性网络模型衡量扰动某残基后对蛋白整体运动模式的影响)。影响全局动态越大的残基,越可能参与变构信号传导。三个特征经 min-max 归一化。
三类特征拼接后,每个残基由一个 1047 维向量表示。这些向量输入四层一维卷积网络(Conv1: 32×3, Conv2: 128×3, Conv3: 32×5, Conv4: 32×3),所有卷积层使用 same padding 和 ReLU 激活,并在每层后加 dropout 防过拟合。随后连接两个全连接层(128→32 神经元),最终由 sigmoid 输出每个残基属于 AFR 的概率。概率 ≥ 0.5 即判定为变构位点残基。选用 1D CNN 的考量是:沿蛋白质序列滑动的卷积核可以学习局部残基组合模式——一个残基是否参与变构位点往往取决于它与邻近残基的理化组成和保守性组合,而 ProtT5 embedding 负责补充更长程的上下文信息。
训练数据来自 ASD2023(V5.0,3,102 个变构位点条目)和 ASBench 基准数据集,经 MMseqs2 聚类去冗余(序列相似度 < 30%)后得到 462 个非冗余蛋白质,按 8:2 划分为训练集 TR372 和测试集 TE90。另外还使用了 AllositePro 研究中的 24 个变构蛋白作为独立测试集 D24。AFR 定义为距变构调节剂 ≤ 5 Å 的残基,训练集中 AFR 与 FR 的比例约 1:27(5,239 vs 144,465)。为避免模型倾向于将所有残基都预测为非变构(在如此不平衡的数据上,总是预测 FR 也能得到约 96% 的准确率),作者对 FR 进行随机欠采样,测试了采样比例参数 SRP 从 5 到 15 的范围,发现 SRP = 13 时验证集 F1 最优。
三、看图说话
Figure 1 · AlloFusion 的工作流程
这张图想回答:三类特征怎么从序列算出来、怎么融合进一个 1D CNN?
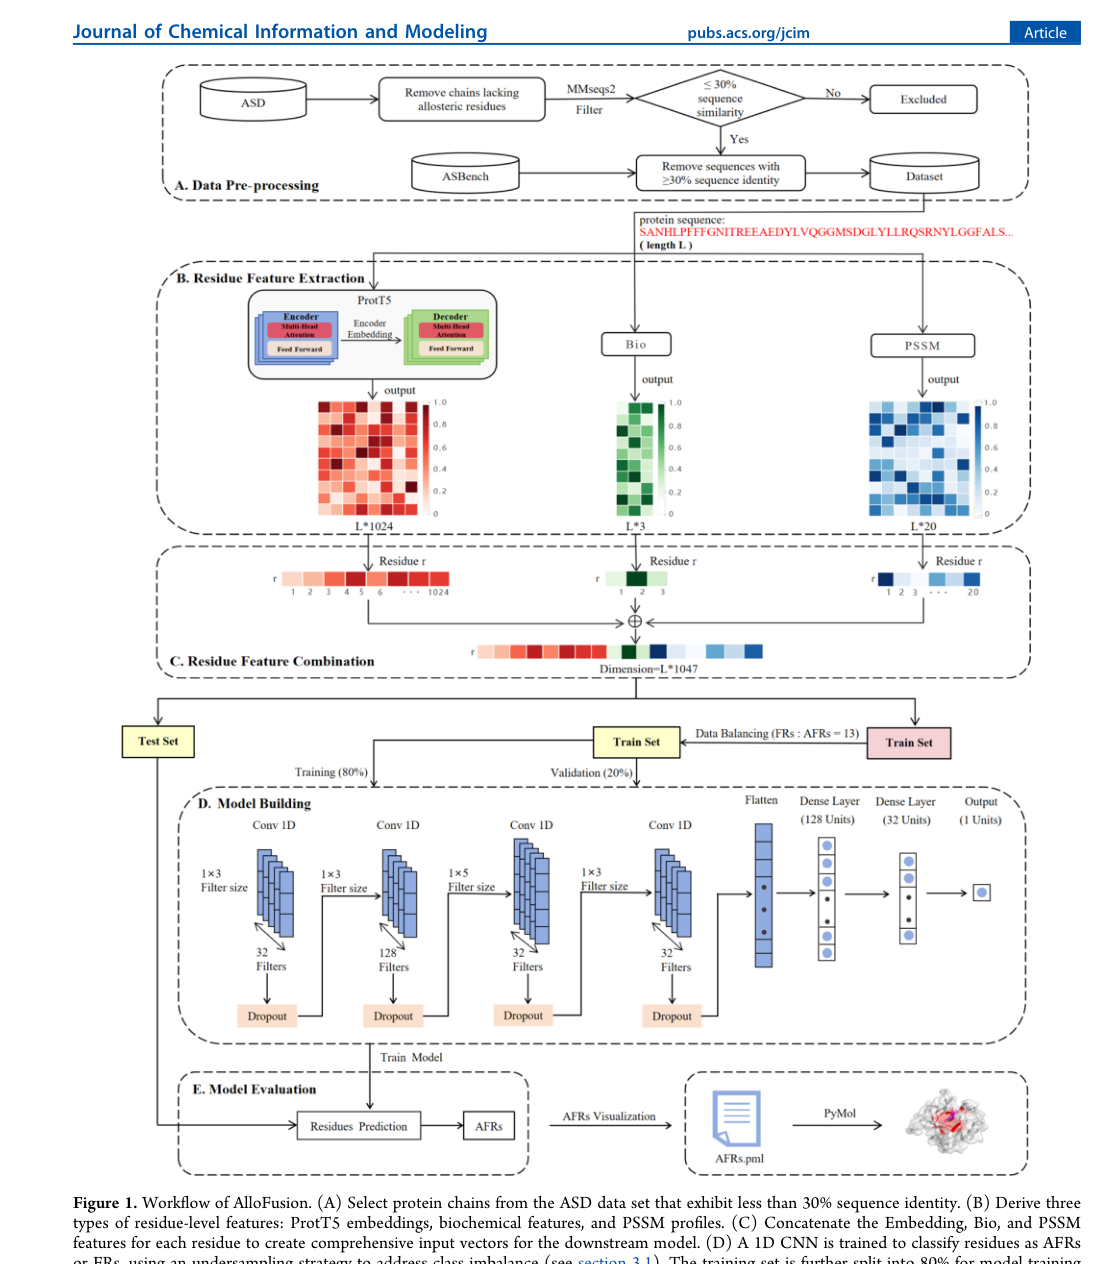
Figure 1. AlloFusion 流程。(A) 从 ASD 取序列一致性 <30% 的蛋白链。(B) 对每个残基算三类特征:ProtT5 embedding、生化特征、PSSM。(C) 拼成综合向量。(D) 送入一维卷积网络逐残基判断是否为变构位点。
- Panel A 是数据:从 ASD 取彼此序列一致性低于 30% 的蛋白链,避免同源泄漏。Panel B 是特征,每个残基算三类——ProtT5 语言模型 embedding 1024 维(捕捉序列上下文和长程依赖,并用 LoRA 微调)、PSSM 进化特征 20 维、生化特征 3 维(疏水性、溶剂可及面积、ESSA 动态性)。
- Panel C 把三类拼成 1047 维残基向量。Panel D 送进四层一维卷积网络加两个全连接层,sigmoid 输出每个残基属于变构位点的概率,≥ 0.5 即判为变构残基。整条路线不做口袋检测,任何位置的残基都有平等机会被识别。
Figure 2 · 怎么选判定阈值 SRP
这张图想回答:逐残基打分后,取排名前多少算作预测位点最合适?
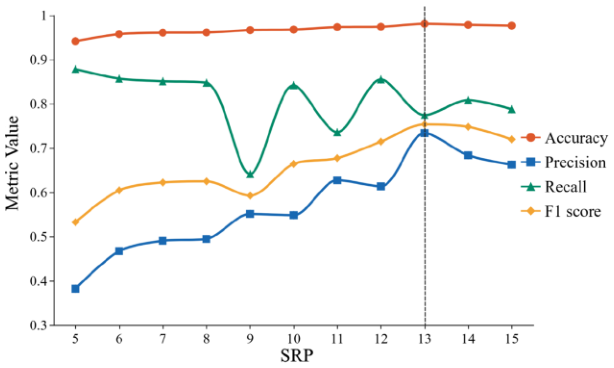
Figure 2. 验证集上不同 SRP 取值的表现,SRP = 13 时 F1 最高,是精度与召回的最佳折中。
SRP 控制每个蛋白取排名前多少的残基作为预测的变构位点。横轴是 SRP,四条线分别是 Accuracy、Precision、Recall、F1。Recall 随 SRP 增大先降后升,Precision 持续上升,F1 在 SRP = 13 处达到峰值(图中虚线),作者据此定下这个阈值。
Figure 3 · 类别极不平衡下的 PR 曲线
这张图想回答:蛋白里变构残基只占极小部分,模型在这种不平衡下表现如何?
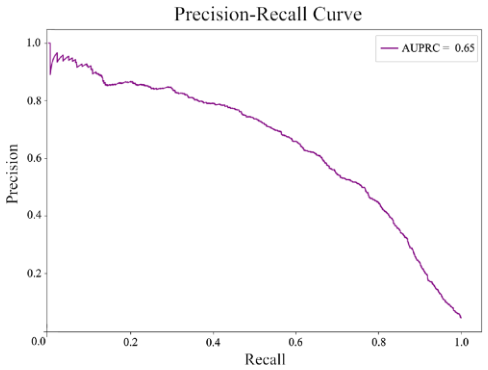
Figure 3. TE90 测试集(SRP = 13)上的 Precision-Recall 曲线,AUPRC = 0.65。
变构残基与非变构残基的比例约 1:25,这种情况下 PR 曲线比 ROC 更能反映真实难度。曲线下面积 AUPRC = 0.65:在低召回区精度能保持在 0.8 以上,随召回升高逐渐下降,说明模型在严重不平衡下仍有可用的区分力,但高召回时假阳性会增多。
Figure 4 · 三类特征各自贡献多少(消融)
这张图想回答:PSSM、embedding、生化特征,去掉哪一类影响最大?
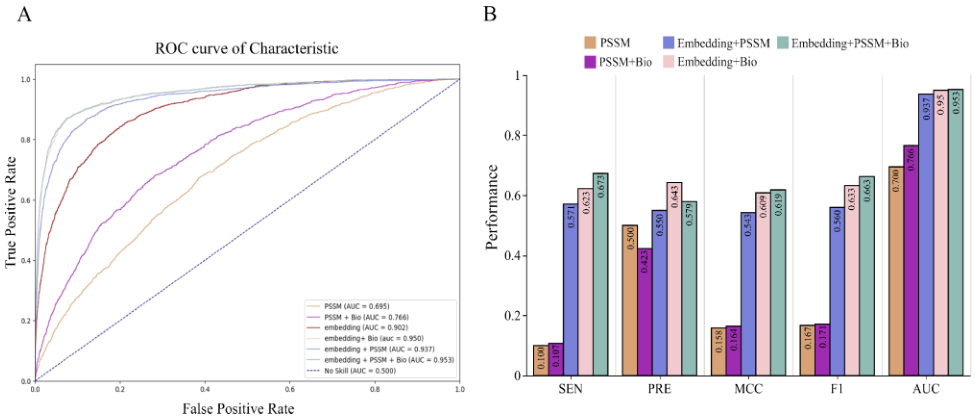
Figure 4. 特征组合消融。(A) 测试集 ROC 曲线对比。(B) 六种组合在 SEN、PRE、MCC、F1、AUC 上的对比。
ProtT5 embedding 是最核心的来源:单用 AUC 就有 0.902,远超单用 PSSM 的 0.695,说明预训练语言模型学到的信息远多于传统进化特征。
加生化特征提升最明显(Embedding + Bio 的 AUC 达 0.950,+0.048),因为表面暴露、疏水性、整体动态这些物理化学约束是语言模型没直接编码的。再加 PSSM 的完整模型 AUC 0.953,边际提升虽小(+0.003),但 SEN、PRE、MCC 仍有稳定改善——三类特征各有分工、互补。
Figure 5 · 对比基于口袋的 PASSer
这张图想回答:在同一个非冗余测试集上,残基层面能不能超过 PASSer 这类口袋方法?
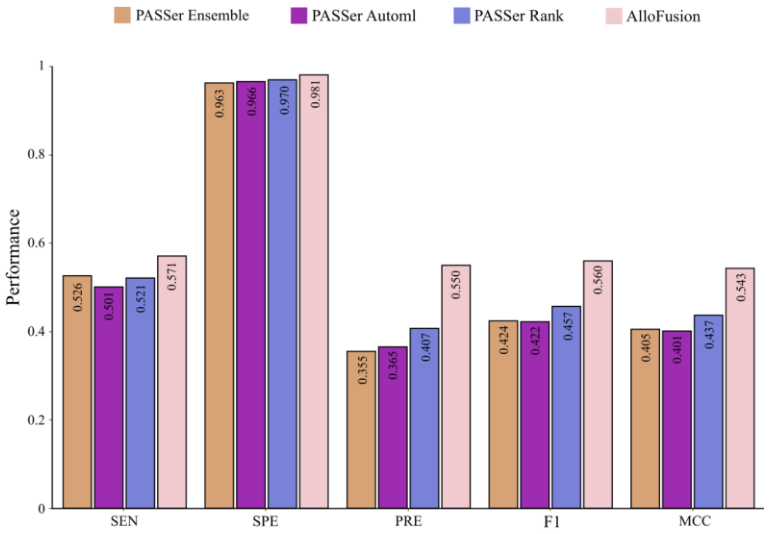
Figure 5. TE90 测试集上 AlloFusion 与 PASSer Ensemble / AutoML / Rank 的对比。
为公平比较,口袋方法只取排名第一的口袋、把口袋残基当作预测结果。AlloFusion 在 全部五项指标上都最好:SEN 0.571、SPE 0.981、PRE 0.550、F1 0.560、MCC 0.543。
其中 Precision 0.550 相对 PASSer Rank 的 0.407 提升 35%,F1 0.560 相对次优的 0.457 提升 22.5%。高 SPE(98.1%)意味着模型不会在整个蛋白表面乱标,这在绝大多数残基都不是变构残基的场景下尤其重要。
Figure 6 · 多个蛋白上各方法的预测叠放对比
这张图想回答:把不同方法在同一批蛋白上的预测摆在一起,差别看起来怎样?
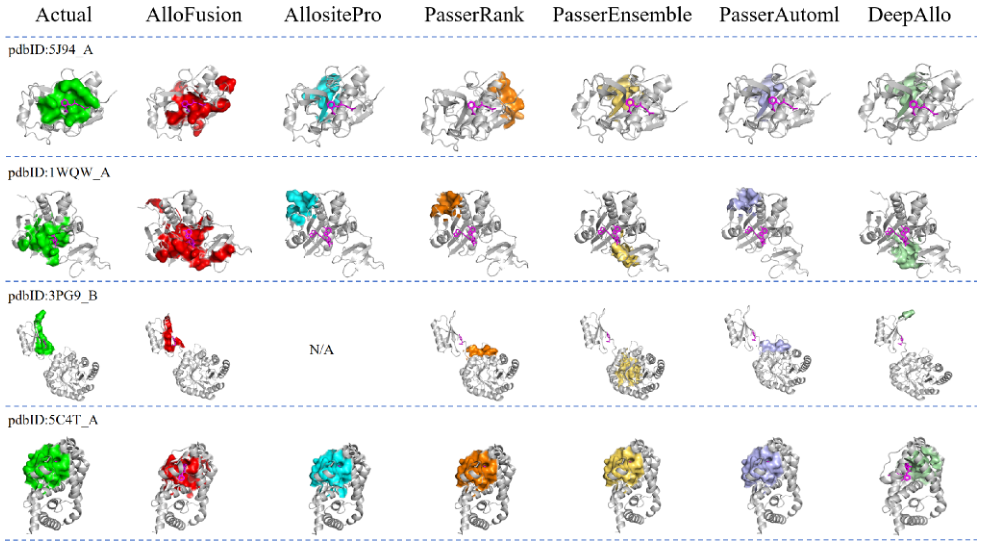
Figure 6. 若干蛋白上各方法预测的变构残基 3D 可视化。每行从左到右:真实位点(绿)、AlloFusion(红)、AllositePro(青)、PASSer Rank(橙)、PASSer Ensemble(浅黄)、PASSer AutoML(浅蓝)、DeepAllo(浅绿)。N/A 表示该方法无输出。
每一行是一个蛋白,最左列绿色是真实变构位点,右侧各列是不同方法的预测。AlloFusion(红)的红色块普遍与绿色真实位点重合度最高。
对比很直观:如 5J94_A 上 AllositePro 虽紧凑但盖住大量无关残基,PASSer 的两个模型则整体偏开;在 3PG9_B 上 AllositePro 直接 N/A(无输出),AlloFusion 仍能正确定位。
Figure 7 · 定位精度 DCC 的分布
这张图想回答:各方法预测的位点中心,离真实中心有多远?
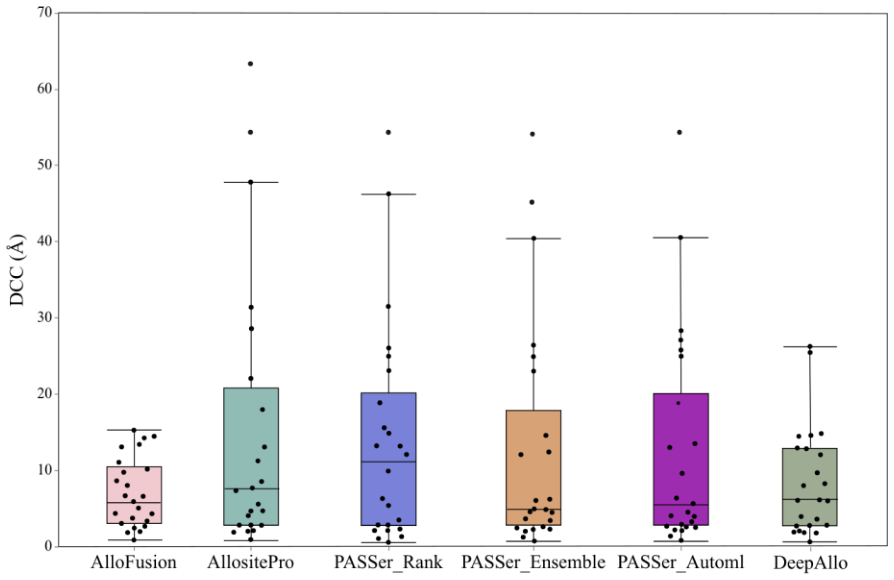
Figure 7. 独立测试集 D24 上 AlloFusion、AllositePro、PASSer 三模型、DeepAllo 的 DCC(预测中心到真实中心距离)分布。
DCC 是预测位点中心到真实位点中心的距离,越小越准。AlloFusion 的箱体最低最窄,中位 DCC 5.35 Å,明显优于 PASSer Rank(10.94 Å)和 PASSer Ensemble(16.47 Å)。
AllositePro 中位 DCC 虽低到 4.23 Å,但它只成功预测 14/24 个蛋白,漏检率 41.7%;AlloFusion 在 D24 上 成功预测 23/24,兼顾了覆盖率和精度。
Figure 8 · 三个蛋白上真实与预测位点的结构对照
这张图想回答:在真实三维结构上,预测位点和实际位点贴合得怎么样?
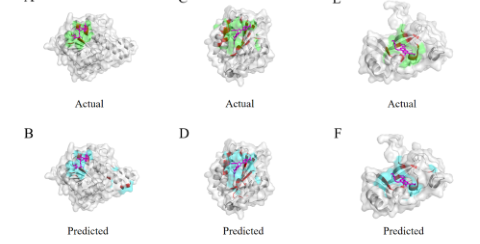
Figure 8. 三个蛋白(PDB 2V4Y、3M6F、6BOZ)的 3D 可视化。上排 A/C/E 为真实变构位点(绿),下排 B/D/F 为 AlloFusion 预测位点(青)。
把三个蛋白的真实位点(上排绿)和预测位点(下排青)并排看:两排在空间上落在同一区域,形状和位置都对得上,说明模型整体锁定了正确的变构区域,而非碰巧命中几个残基。
Figure 9 · 序列层面的逐残基比对
这张图想回答:换成一维序列看,预测的残基和真实残基逐位对不对得上?
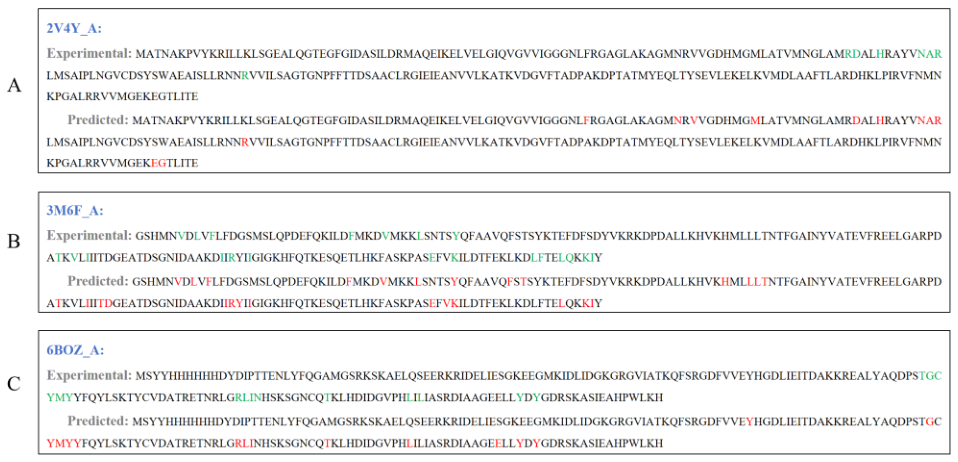
Figure 9. PDB 2V4Y (A)、3M6F (B)、6BOZ (C) 链 A 的一维序列表示。每个蛋白上行标注真实变构残基(绿),下行为 AlloFusion 预测残基。
这张图把三维结构摊平成序列,上行是真实变构残基、下行是预测残基,用颜色标出。可以逐个位置核对:大部分绿色残基在预测行也被标中,漏标和多标的都是少数,和前面 SEN 0.571、PRE 0.550 的数字一致。
Figure 10 · 一个独立蛋白的预测案例
这张图想回答:在训练之外的一个蛋白上,预测位点和真实位点贴合吗?
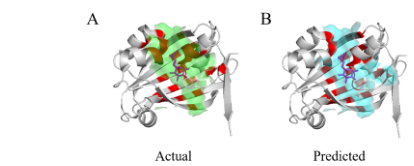
Figure 10. 蛋白 4ZSI 的变构位点预测。(A) 绿色为真实位点,(B) 青色为 AlloFusion 预测位点,灰色为蛋白骨架。
4ZSI 是独立测试里的一个例子。左图绿色真实位点与右图青色预测位点落在同一凹陷区域,形状相近,直观印证了模型在没见过的蛋白上也能把变构区域定位出来。
四、核心贡献总结
在 TE90 测试集(90 个非冗余蛋白)上,作者将 AlloFusion 与三种 PASSer 口袋方法进行了残基层面的直接对比。为保证公平,口袋方法只取排名第一的预测口袋,将构成该口袋的残基作为预测 AFR。AlloFusion 在全部五项指标上均取得最佳结果:
Sensitivity 0.571:找回约 57% 的真实变构残基,优于 PASSer Ensemble(0.526)和 PASSer Rank(0.521),也高于 PASSer AutoML(0.501)
Specificity 0.981:98.1% 的非变构残基被正确排除。由于蛋白质中绝大多数残基都不是 AFR,高 SPE 意味着模型不会在整个蛋白表面产生大量错误预测
Precision 0.550:预测为 AFR 的残基中约 55% 是真实变构残基,相比 PASSer Rank 的 0.407 提升 35%,相比 PASSer Ensemble 的 0.355 提升 55%
F1 0.560:在”找得多”和”找得准”之间取得最佳平衡,相比次优的 PASSer Rank(0.457)提升 22.5%
MCC 0.543:Matthew 相关系数同时考虑 TP、TN、FP 和 FN 四种分类结果,比准确率更适合类别不平衡的场景,AlloFusion 在此指标上同样领先
在独立测试集 D24(24 个变构蛋白)上,AlloFusion 成功预测了 23 个蛋白的变构位点。作者使用 DCC(predicted site center 与 known site center 之间的距离)衡量空间准确性,AlloFusion 的中位 DCC 为 5.35 Å,显著低于 PASSer Rank(10.94 Å)和 PASSer Ensemble(16.47 Å),说明 AlloFusion 不仅能找到变构区域,而且定位更精准。AllositePro 的中位 DCC 虽低(4.23 Å),但它只成功预测了 14/24 个蛋白,漏检率高达 41.7%。DeepAllo(中位 DCC 6.87 Å,成功 22/24)和 PASSer Rank(成功 14/24)也存在明显的预测盲区。
在具体蛋白案例中(如 PDB: 5J94_A),AlloFusion 预测的变构残基与真实 AFR 高度重合,而 AllositePro 虽然预测区域紧凑但覆盖了大量无关残基,PASSer Ensemble 和 Automl 的预测区域则偏离了真实变构位点。对于另一个蛋白 3PG9_B,AllositePro 完全没有输出预测结果(N/A),而 AlloFusion 仍能正确识别变构区域。
AlloFusion 优势的关键在于策略转变。传统口袋方法遵循”先找口袋再判断”的串行流程:首先用 Fpocket 等工具检测蛋白表面所有可能的候选口袋,然后训练分类模型判断哪个口袋最可能是变构位点。这个流程的问题是,如果变构区域恰好位于不形成典型口袋的平坦表面、蛋白-蛋白界面或仅在特定构象下出现的隐蔽位点,第一步就会将其遗漏,后续分类模型无论多好都无法补救。
AlloFusion 完全绕过了口袋检测步骤,直接对蛋白质序列中的每个残基独立评分。这意味着任何位置的残基——无论是否处于可检测口袋中——都有平等的机会被判定为 AFR。ProtT5 蛋白语言模型提供的深层序列语义进一步强化了这一优势:模型不依赖实验解析的三维结构,仅凭蛋白质序列即可工作,这对于目前尚无实验解析结构或只有低分辨率结构的蛋白来说尤为重要。
五、局限与展望
AlloFusion 的 Sensitivity 为 0.571,意味着仍有约 43% 的变构残基被漏检——对于需要高召回率的药物筛选场景,这一漏检率需要引起注意。在高度不平衡的测试条件下(正负样本比约 1:25),AUPRC 为 0.65,说明模型在实际应用中仍会产生一定比例的假阳性。训练和评估数据均来自 ASD2023 数据库,其覆盖范围受限于已发表的实验研究,蛋白功能类别的分布可能反映研究热度而非自然界变构蛋白的真实分布,模型在数据库未覆盖的蛋白类别上的表现有待验证。
此外,由于 PASSer 和 AllositePro 的训练数据未公开,无法完全排除测试集 TE90 和 D24 与这些方法训练集之间的潜在重叠,这给公平比较带来了不确定性。生化特征中的动态性质(ESSA z-score)依赖于弹性网络模型对蛋白质运动的线性近似,对构象变化复杂或涉及大幅度结构域运动的蛋白可能不够准确。模型使用的 1D CNN 主要捕捉局部序列窗口中的特征组合(卷积核大小 3-5 个残基),对更长程的序列依赖主要依靠 ProtT5 embedding 间接提供,未来可以考虑引入图神经网络或注意力机制来显式建模残基间的空间关系。最后,AlloFusion 目前仅利用序列和序列衍生特征,未显式整合三维结构信息。虽然 ProtT5 隐含了一定的结构知识,但如果能结合 AlphaFold 预测结构或分子动力学模拟数据,预测准确性有望进一步显著提升,这也是未来值得探索的方向。
通讯作者介绍
本文通讯作者为郭栋梁(Dongliang Guo),署名单位是燕山大学信息科学与工程学院,以及河北省软件工程重点实验室,研究方向为软件工程与人工智能方法在生物数据上的应用。AlloFusion 的源代码和训练数据已在 GitHub 开源(https://github.com/hjb-001/AlloFusion),便于其他研究者复现和在自己的数据上应用。第一作者黄佳斌(Jiabin Huang)同样来自燕山大学信息科学与工程学院,负责了方法设计、模型训练、代码开发和实验验证的主要工作;吕梦雅(Mengya Lv)等人为共同作者。
引用
Huang, J., Guo, D., Liu, Y., Wang, Y., & Lv, M. (2025). Allofusion: Allosteric Site Prediction Based on Language Models and Multi-Feature Fusion. Journal of Chemical Information and Modeling, 65(16), 8858-8870. https://doi.org/10.1021/acs.jcim.5c01033