
Deep generative design of RNA aptamers using structural predictions
原文链接:全文
作者:Felix Wong, Dongchen He, Aarti Krishnan, …, James J. Collins
Nature Computational Science,2024 年 11 月
导读
RNA 适配体的传统发现主要依赖 SELEX 实验——从大规模随机序列库中反复筛选,耗时耗资源。这篇文章提出了 RhoDesign——一个结构到序列的深度学习平台,能够根据目标 RNA 三维骨架结构自动生成序列新颖但结构相似的 RNA 适配体。以荧光适配体 Mango-III 为目标,作者首轮合成 18 条候选序列即获得 4 条活性适配体(命中率 22%);经过一轮计算优化后,20 条候选中 15 条有活性且 9 条超过初始最佳(命中率 75%)。这些新适配体与已知 Mango 序列差异显著,展示了通过 RNA 三维结构”逆折叠”实现功能性序列跨越式探索的可能性。
一、研究问题
RNA 是一类功能多样的可编程生物分子——核酶可以催化化学反应,核糖开关能感知代谢物并调控基因表达,适配体可以高特异性地结合蛋白质或小分子。这些功能几乎都高度依赖 RNA 的三维结构:特定的碱基堆叠、氢键网络和三级相互作用共同构成了功能所需的空间骨架。近年来,RhoFold、AlphaFold 3 等序列到结构预测模型取得了显著进展,使得 RNA 三维结构预测逐渐从”不可行”走向”初步实用”阶段。作者提出了一个自然的延伸:如果已经知道某种三维结构具有特定功能,能否反过来生成一批”结构类似但序列不同”的新 RNA?这本质上是蛋白质设计领域”逆折叠”思想在 RNA 上的对应——给定三维骨架,求解与之兼容的核苷酸序列。与蛋白质逆折叠(如 ProteinMPNN 需要从 20 种氨基酸中选择)相比,RNA 逆折叠看似更简单(只有 A、U、G、C 四种碱基),但实际上 RNA 结构预测本身的精度仍是主要瓶颈,大量训练数据的缺乏也增加了建模难度。
传统 RNA 适配体发现依赖 SELEX(指数富集配体系统进化),从 10^13–10^15 规模的随机序列库出发,经 8–15 轮结合-扩增-测序筛选获取高亲和力序列。虽然有效,但 SELEX 在序列空间中的探索范围受限于初始文库的多样性和 PCR 扩增偏差,而且每种新靶标都需要从头建库和筛选,周期通常以月计。更重要的是,SELEX 富集到的序列往往集中在序列空间的少数几个区域,很难跨越大的序列距离找到功能等价但序列迥异的适配体——而这对于避开现有专利、降低免疫原性、改善核酸酶稳定性或设计正交的生物传感器元件都至关重要。RhoDesign 的思路是利用已知三维结构作为约束条件,在计算空间中高效采样满足结构要求的序列,将合成和测试的规模从数万条压缩到十几条,同时允许在序列空间中进行远超 SELEX 随机突变范围的大范围跳跃式探索。
二、方法核心:RhoDesign 的模型架构与训练
(a)RhoDesign 的设计流程从一个已知的目标三维结构出发(如 Mango-III 荧光适配体,PDB: 6UP0),通过逆折叠生成候选序列,再经结构预测回验、聚类和结合力预测多重筛选后合成验证。整个流程学习的条件概率分布为 P(RNA 序列 | 三维骨架结构, 二级结构)。(b)模型架构包括两个核心模块。GVP(几何向量感知器)编码器提取 RNA 骨架上 C4’、C1’、N1、C2、C5’、O5’、P 等原子的空间坐标,计算出二面角等局部几何特征,分别用向量特征表示空间方向、标量特征表示角度信息,GVP 的设计使编码天然地满足旋转和平移不变性。Transformer 编码-解码器将 GVP 提取的三维几何特征与 RNA 二级结构接触图(碱基配对信息)拼接后输入,通过自注意力机制建模序列中远程碱基间的依赖关系——例如空间上相邻但序列位置上相隔数十个碱基的配对——最终逐位置输出四种核苷酸(A、U、G、C)的概率分布,通过温度控制的采样产生新的 RNA 序列。
训练数据面临一个核心瓶颈:PDB 中实验解析的 RNA 三维结构仅约 3,435 个,远少于蛋白质的十几万个。直接在如此小的数据集上训练深度学习模型很容易过拟合。作者采用了一个关键的数据增强策略——从 RNAcentral 随机抽取约 100 万条 RNA 序列,用 RhoFold 预测三维结构,保留 pLDDT 大于 60 的 369,499 个预测结构作为扩充训练集。pLDDT 阈值的选择经过系统比较:阈值设为 80 时只剩 34,565 个高质量结构,数据量不足;阈值设为 40 时数据虽多但低质量预测会干扰学习;作者发现 60 是总体效果最好的折中点。消融实验验证了这一策略的有效性:仅用 PDB 实验结构训练时序列恢复率为 30.0%,仅用预测结构时为 41.3%,两者结合达到 52.9%——约为其他基线方法(23.7%–26.1%)的两倍。(c–g)与 LEARNA、RiboLogic、MCTS-RNA、gRNAde、RDesign、eM2dRNAs 等方法的对比中,RhoDesign 在恢复率上有明确优势;进一步的消融实验证明 GVP 编码器、Transformer 编/解码器和二级结构信息各自都有不可替代的贡献,移除任何一个模块都会导致性能下降。
三、看图说话
Figure 1 · 从三维骨架到序列的设计方法
这张图想回答:RhoDesign 怎样从 RNA 三维骨架出发,用 GVP 编码器和 Transformer 生成序列?
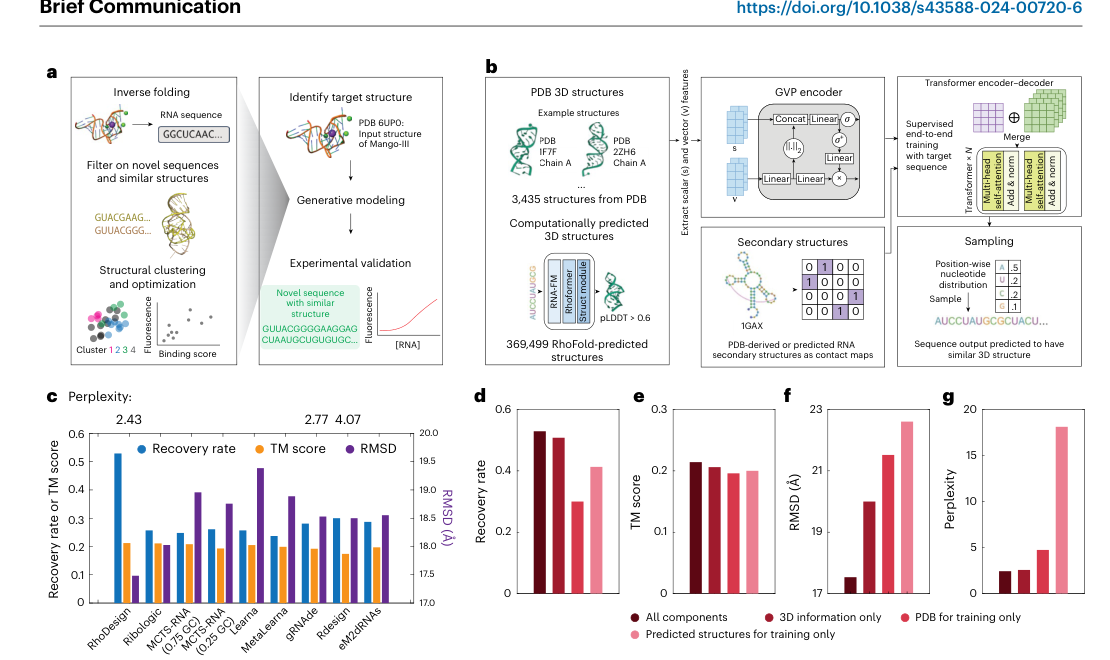
Figure 1. 基于三维结构的 RNA 生成设计方法。(a) 整体流程:从目标结构逆折叠生成序列,再经结构回验、聚类、结合力预测筛选后合成。(b) GVP 编码器 + Transformer 编解码器架构。(c–g) 与基线方法的恢复率对比及消融。
- Panel a/b:学习条件分布 P(序列 | 三维骨架, 二级结构)。GVP 几何向量感知器从骨架原子坐标提取满足旋转平移不变的几何特征,拼上二级结构接触图后喂进 Transformer,逐位置输出 A/U/G/C 概率、温度采样出新序列。
数据增强是关键:PDB 实验 RNA 结构只有约 3,435 个,作者从 RNAcentral 抽 100 万条序列用 RhoFold 预测、保留 pLDDT > 60 的 36.9 万个作扩充集。消融证明:只用 PDB 恢复率 30.0%、只用预测结构 41.3%、两者结合 52.9%(约为其它基线的两倍)。Panel c–g 显示 GVP、Transformer、二级结构信息各自都不可替代。
Figure 2 · 荧光适配体的实验验证与优化
这张图想回答:设计的 Mango-III 适配体变体能否在荧光实验中有活性、甚至超过野生型?迭代优化有多大提升?
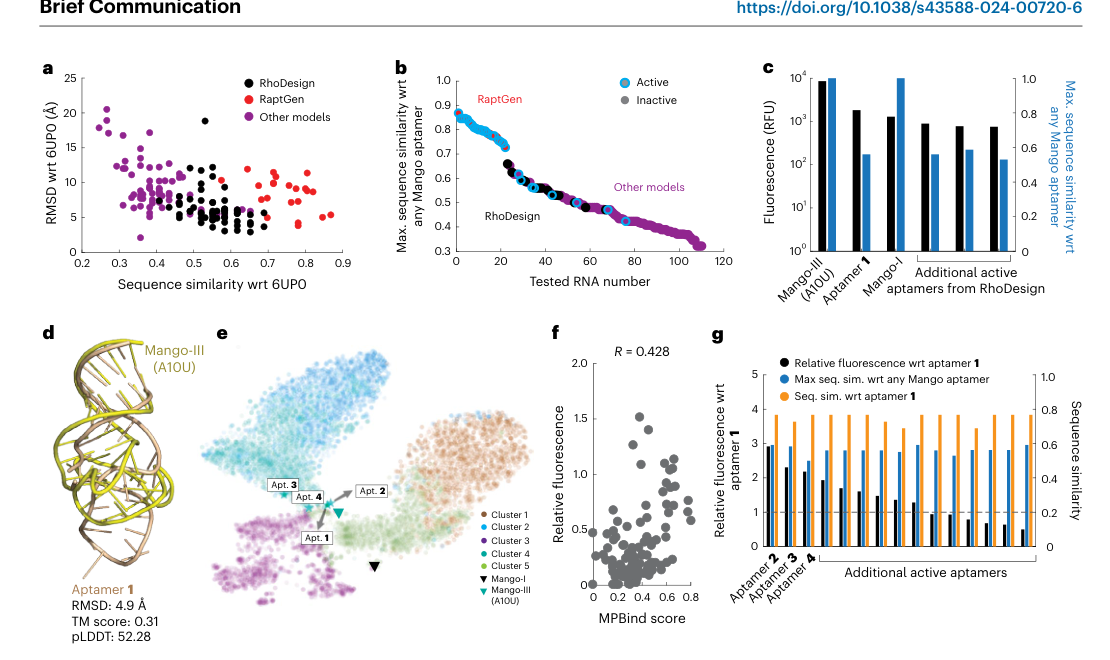
Figure 2. 生成的荧光点亮型 RNA 适配体的实验验证、优化与机制。(a) 首轮按预测 RMSD 与序列距离筛选。(b) 与 RaptGen 等方法对比。(c) 方法定位。(d–e) 第二轮优化流程。(f) MPBind 分数与荧光的相关。(g) 优化后命中率与最佳适配体。
目标是 Mango-III(PDB 6UP0),训练时特意排除 6UP0 及与其相似度 > 0.5 的结构,防止背答案。Panel a:首轮 60 条候选筛出 18 条合成,4 条有活性(22%),其中 aptamer 1 荧光超过 Mango-I,而与任何已知 Mango 的相似度仅约 0.59、不含保守基序。
- Panel b/c:RaptGen(基于 SELEX 数据)命中率 91% 但序列都与已知 Mango 相似度 > 0.7,只是在已知序列附近打转;RhoDesign 命中率虽低却能在保持结构功能的同时大跨度跳到序列空间新区域。Panel d–g:以 aptamer 1 为起点第二轮优化(生成 5000 条、MPBind + t-SNE 筛选),20 条里 15 条有活性(75%)、9 条超过 aptamer 1,最好的 aptamer 2–4 荧光是 aptamer 1 的约 3–5 倍。两轮只合成 38 条就拿到 19 条活性序列。
四、核心贡献总结
RhoDesign 的贡献可以归纳为三点。
把蛋白「逆折叠」思路搬到 RNA。给定三维骨架求兼容序列,用 GVP + Transformer 学结构到序列的映射。针对 RNA 实验结构稀缺,用 RhoFold 预测结构做大规模数据增强,恢复率提到 52.9%,约为其它方法的两倍。
湿实验证明可行,还能大跨度探索序列空间。首轮 18 条合成命中 4 条、aptamer 1 荧光超野生型 Mango-I,且与已知 Mango 相似度仅约 0.59——这是 SELEX 和基于 SELEX 的方法难以做到的跨越式探索。
迭代优化闭环有效。以首轮最佳为起点再生成、筛选,命中率从 22% 跃升到 75%,最佳适配体荧光达 aptamer 1 的 3–5 倍;两轮只合成 38 条就拿到 19 条活性序列,比 SELEX 省几个数量级。竞争抑制和 QUMA-1 实验提示新序列很可能通过相似的 G-四链体机制发光。
五、局限与展望
Mango 适配体的核心结构特征是 G-四链体(G-quadruplex)——多个鸟嘌呤通过 Hoogsteen 氢键形成的平面堆叠结构,为 TO1 类不对称氰基染料提供了一个刚性结合口袋,限制染料的分子内旋转从而增强荧光。作者通过两类实验验证新设计的适配体是否也采用类似机制:首先,三种 G-四链体特异性结合小分子(TMPyP4、Pyridostatin、Carboxypyridostatin)的竞争抑制实验显示,这些抑制剂使 aptamer 1–4 和 Mango-III 的 TO1-biotin 荧光均显著降低,说明 G-四链体结构对荧光功能至关重要;其次,QUMA-1(一种对 RNA G-四链体敏感的荧光探针)检测显示,加入 aptamer 1–4 后 QUMA-1 荧光明显上升,进一步支持这些新适配体中存在 G-四链体。此外,AlphaFold 3 引入离子约束后的预测也提示 aptamer 1、2、4 可能含有 G-四链体结构(但 RhoFold 对此的预测不够明确)。综合来看,RhoDesign 生成的新序列与 Mango 家族虽然序列差异大,但很可能通过相似的 G-四链体介导的结构机制实现荧光功能。
局限性方面,整个流程存在一个需要注意的自洽性偏差:训练数据中约 99% 的结构由 RhoFold 预测,设计评估也主要由 RhoFold 进行,模型可能学会生成”RhoFold 认为合理”而非物理上最准确的序列。文中报告的 TM score 和 RMSD 指标受 RhoFold 预测精度的上限约束——即使输入完全正确的天然序列,RhoFold 预测与 PDB 实验结构的平均 TM score 也只有约 0.247、RMSD 约 17.45 Å,因此这些数值不能按蛋白质结构比较的惯例来解读。缺少新适配体的实验三维结构解析(X 射线晶体学、冷冻电镜或 NMR),无法在原子尺度上确认它们是否真正采用 Mango 类构象。功能验证仅针对一类荧光适配体和一种配体(TO1-biotin),尚未证明方法适用于蛋白质结合适配体、治疗性靶标、催化 RNA 或结构更复杂的多结构域 RNA 设计。此外,RNA 功能不仅取决于静态骨架,还涉及局部碱基取向、金属离子配位、水分子网络和构象动态集合体,而 RhoDesign 目前仅针对固定骨架进行逆折叠。尽管如此,该工作首次在湿实验层面证明了”RNA 结构 → 序列”设计思路的可行性,将 RNA 适配体发现从大规模文库筛选推向了结构引导的精准生成设计。同时,利用大规模预测结构作为训练数据来弥补实验结构不足的策略,为 RNA 计算设计领域提供了一条通用的数据扩充路径,未来随着 RNA 结构预测精度的持续提升,这种”预测结构 → 训练逆折叠模型 → 生成新序列 → 实验验证”的范式有望拓展到更多的 RNA 功能类型。
通讯作者介绍
James J. Collins,麻省理工学院(MIT)医学工程与科学研究所教授、美国国家科学院和国家工程院双院士、Howard Hughes 医学研究所研究员,研究领域横跨合成生物学、系统生物学和 AI 驱动的药物发现。Collins 实验室在合成基因线路设计、新型抗生素发现(包括 AI 驱动的 halicin 和 abaucin)和生物传感器开发等方面有开创性贡献,近年来将深度学习方法广泛应用于核酸设计和药物筛选。第一作者 Felix Wong 为 MIT 博士后研究员,此前主导了 AI 驱动的新型抗生素发现工作并在 Nature 和 Cell 上发表相关成果,本文是其将深度学习拓展到 RNA 设计领域的代表性工作。另一位通讯作者 Yu Li 来自香港中文大学计算机科学与工程系(论文标注的通讯作者为 Yu Li 和 James J. Collins 两人;同系的 Irwin King 为共同作者)。Yu Li 实验室长期从事 RNA 结构预测和生物信息学研究,其开发的 RhoFold 模型为本文提供了关键的结构预测能力和大规模训练数据生成支持。
引用
Wong, F., He, D., Krishnan, A., Hong, L., Wang, A. Z., Wang, J., … & Collins, J. J. (2024). Deep generative design of RNA aptamers using structural predictions. Nature Computational Science, 4(11), 829-839. https://doi.org/10.1038/s43588-024-00720-6