
Accurate structure prediction of biomolecular interactions with AlphaFold 3
原文链接:全文
作者:Josh Abramson, Jonas Adler, Jack Dunger, …, John M. Jumper
Nature,2024 年 6 月
AlphaFold 2 让单条蛋白链的结构预测接近实验精度,可细胞里的分子机器很少只由蛋白组成:转录因子要抓住 DNA,核糖体由 rRNA 和几十种蛋白装配而成,药物分子要嵌进蛋白口袋,糖链和磷酸基团会改写蛋白之间的结合方式。过去这些问题分属不同的专用工具,各管一段。
2024 年 5 月,Google DeepMind 与 Isomorphic Labs 在 Nature 发表 AlphaFold 3(AF3):输入蛋白/DNA/RNA 序列、小分子 SMILES、修饰残基和共价键信息,直接输出整个复合物的全原子三维坐标。为此模型做了两处根本性改动:用 MSA 处理大幅简化的 Pairformer 取代 Evoformer,用直接在原子坐标上去噪的扩散模块取代 AF2 的结构模块。
效果上,PoseBusters 蛋白–配体基准中 AF3 的成功率(口袋对齐配体 RMSD < 2 Å)为 76.4%,经典对接工具 Vina 为 52.3%,而且 Vina 还用上了实验结构和口袋信息;蛋白–双链 DNA 界面 iLDDT 从 RoseTTAFold2NA 的 28.3 提高到 64.8;抗体–抗原界面的正确率从 AlphaFold-Multimer v2.3 的 29.6% 提高到 62.9%。与此同时,论文也明确列出了手性错误、原子碰撞、无序区”幻觉”和构象覆盖不足等问题。
本文按”研究问题 → 方法核心 → 逐图讲解 → 核心发现 → 意义与局限”展开,文末附一份拿到 AF3 预测结果后的检查清单。
一、研究问题
AlphaFold 2(AF2)发布后不久,研究者就发现只要对输入做一些简单改动(比如把两条链用长 linker 连起来),它就能给出相当准确的蛋白–蛋白相互作用预测;DeepMind 随后专门训练了 AlphaFold-Multimer,把复合物预测做成了正式能力。这一系列成功自然引出了下一个问题:能否在同一个深度学习框架里,准确预测包含配体、离子、核酸和修饰残基的复合物?
在 AF3 之前,这类问题大致由下面几类工具分别处理:
蛋白单体与蛋白复合物
AF2、AlphaFold-Multimer、RoseTTAFold、ESMFold 等。它们的表示方式围绕氨基酸设计:骨架局部坐标系、侧链扭转角、残基级的几何约束。
蛋白–小分子
AutoDock Vina、Gold 等物理打分对接工具,以及 DiffDock、EquiBind、TankBind、Uni-Mol 等深度学习对接方法。前者通常需要已解析的蛋白结构(往往是与配体共结晶的 holo 结构)和口袋位置;后者的精度参差不齐,PoseBusters 的分析指出很多 AI 对接方法生成的姿势在物理上并不合理。
蛋白–核酸与 RNA 三级结构
RoseTTAFoldNA / RoseTTAFold2NA,以及 CASP15 中的各类 RNA 结构预测程序(不少还依赖人工干预)。与本工作同期,RoseTTAFold All-Atom 也尝试做通用的全原子建模。
作者指出,这种分工有两个根本问题。第一,大多数方法只针对一种相互作用类型,无法处理同时含有多种实体的一般复合物,例如”蛋白 + DNA + 小分子”的三元体系,或者”糖基化刺突蛋白 + 抗体”。第二,深度学习方法在这些专门任务上的精度经常不如基于物理的方法。还有一个更隐蔽的问题:传统对接先固定蛋白结构,再把配体放进口袋,可配体结合往往伴随口袋构象调整,把”结构预测”和”分子对接”硬拆成两步,本身就丢掉了这种耦合。
AF3 的目标因此很明确:覆盖 PDB 中几乎所有的分子类型,在一个模型里同时处理蛋白、DNA、RNA、小分子配体、离子、糖链、修饰残基以及它们之间的共价连接,并且在每个类别上都尽量追平甚至超过最强的专用方法,同时不牺牲原有的蛋白预测精度。
AF3 的输入与输出
输入:蛋白、DNA、RNA 的序列;小分子的 SMILES(或化学组分字典 CCD 中的编号);残基修饰(磷酸化、甲基化、糖基化等);实体之间的共价键。
辅助信息:遗传数据库检索得到的 MSA、模板检索得到的结构模板、由化学信息生成的小分子参考构象。
输出:整个复合物所有重原子的三维坐标,以及 pLDDT、PAE、PDE、pTM、ipTM 等置信度。
二、方法核心:Pairformer + 原子级扩散
AF3 的总体思路延续 AF2:一个庞大的主干网络(trunk)先演化出复合物的成对表示,再由结构生成模块把它变成显式的原子坐标。但每个主要部件都改动很大。作者说明,这些改动一方面是为了在不做大量”特殊情况处理”的前提下容纳各种化学实体,另一方面来自对 AF2 各种改动效果的长期观察,目的是提高学习的数据效率。
整体流程:从序列到原子坐标
AF3 先把输入切分成 token:标准氨基酸和核苷酸每个残基是一个 token,小分子等非标准组分则按原子拆成 token。这样蛋白残基、核苷酸和配体原子都能放进同一套表示里。整个推理流程(对应后文 Fig. 1d)依次经过:
Step 1 输入嵌入器(Input embedder,3 个 block):把序列、化学信息、参考构象编码成 single 表示(每个 token 一个向量)和 pair 表示(每对 token 一个向量)。
Step 2 模板模块(Template module,2 个 block):把检索到的结构模板信息加进 pair 表示。
Step 3 MSA 模块(4 个 block):从 MSA 中提取共进化信息,汇入 pair 表示。
Step 4 Pairformer(48 个 block):主干网络的核心,反复更新 single 和 pair 表示;Step 2–4 会循环迭代(recycling)多次。
Step 5 扩散模块(Diffusion module,3 + 24 + 3 个 block):以主干输出为条件,从随机噪声开始反复去噪,生成全原子坐标。
Step 6 置信度模块(Confidence module,4 个 block):根据主干表示和生成的结构,给出 pLDDT、PAE、PDE 等误差预测,用于给多个候选结构排序。
三、看图说话
论文正文只有五张主图,分工很清楚:Fig. 1 回答”能做什么、做得多好”,Fig. 2 回答”为什么能做到”,Fig. 3 展示”能处理多复杂的体系”,Fig. 4 回答”置信度能不能信”,Fig. 5 坦白”哪些地方会出错”。
Figure 1 · 能力范围与总体性能
这张图想回答:AlphaFold 3 能预测多少种生物分子复合物类型,在各项基准上表现如何?
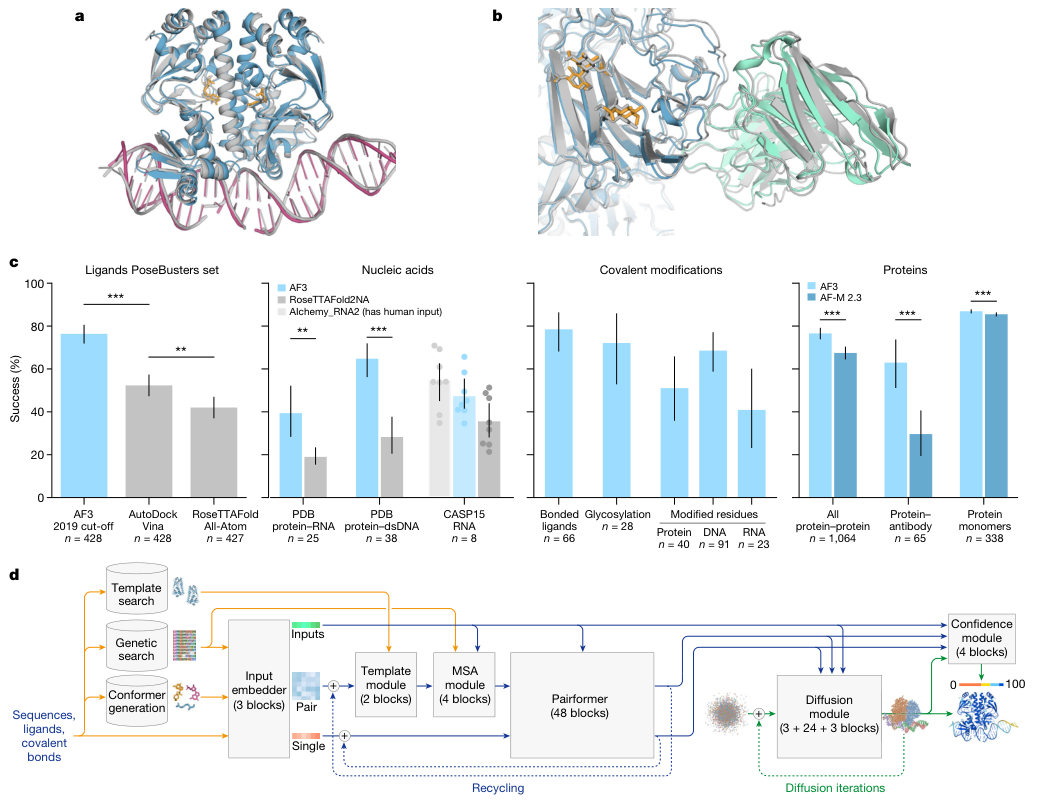
Figure 1. a、b:AF3 预测示例(彩色为预测,灰色为实验结构);c:在 PoseBusters、Recent PDB 评测集和 CASP15 RNA 上与专用方法的比较;d:AF3 推理架构。
怎么读这张图
Panel c 的四组柱状图各用各的指标:配体和共价修饰看口袋对齐 RMSD < 2 Å 的成功率,蛋白–核酸看 iLDDT,核酸和蛋白单体看 LDDT,蛋白–蛋白和抗体看 DockQ > 0.23 的比例。所以只能在同一组内比较不同方法,不能拿不同组的柱子高度互相比较。
柱高为均值,误差棒为 95% 置信区间;*** 表示 P < 0.001,** 表示 P < 0.01(PoseBusters 用双侧 Fisher 精确检验,其余用双侧 Wilcoxon 符号秩检验)。
Panel a 是一个细菌 CRP/FNR 家族转录调控蛋白与 DNA、cGMP 形成的复合物(PDB 7PZB),全复合物 LDDT 82.8,GDT 90.1。Panel b 是人冠状病毒 OC43 的刺突蛋白,共 4,665 个残基,带大量糖基化,并结合了中和抗体(PDB 7PNM),全复合物 LDDT 83.0,GDT 83.1。这两个例子想说明的是,AF3 可以把蛋白、核酸、小分子、糖链和抗体放在同一次预测里联合建模,无需先分别预测再拼接。
Panel c 是全文最重要的性能总结,具体数值见 Extended Data Table 1:
配体(PoseBusters v1,428 个靶标)
AF3(2019 截止版)成功率 76.4%,AutoDock Vina 52.3%,RoseTTAFold All-Atom 42.0%(427 个靶标)。AF3 对 Vina 的显著性 P = 2.27 × 10⁻¹³,对 RoseTTAFold All-Atom 为 P = 4.45 × 10⁻²⁵。
关键在于比较条件:论文把基线方法分成两类,一类只用蛋白序列和配体 SMILES,另一类额外”泄露”了已解析测试结构中的信息。Vina 这类传统对接属于后者,用的是实验得到的 holo 蛋白结构和口袋位置,而这些信息在真实应用中通常拿不到。AF3 不用任何结构输入,依然大幅领先。
核酸
蛋白–RNA 界面 iLDDT:AF3 39.4,RoseTTAFold2NA 19.0(25 个结构,P = 2.78 × 10⁻³)。蛋白–双链 DNA 界面:AF3 64.8,RoseTTAFold2NA 28.3(38 个结构,P = 7.28 × 10⁻¹²)。由于 RoseTTAFold2NA 只在 1,000 个残基以下的结构上验证过,这组比较只用了小于 1,000 个残基/核苷酸的结构,而 AF3 本身可以处理上千残基的蛋白–核酸体系。
CASP15 RNA(图中 n = 8)的 RNA LDDT:AF3 47.3,RoseTTAFold2NA 35.5,而有人类专家参与的 AIchemy_RNA2 为 54.5。AF3 在各自共同子集上的平均表现优于 RoseTTAFold2NA 和 CASP15 中最好的纯 AI 提交 AIchemy_RNA,但没有追上人类专家辅助的最佳提交。由于样本太少,作者没有报告显著性检验。图中的散点是单个靶标的得分。
共价修饰
共价结合配体成功率 78.5%(66 个簇);糖基化 72.1%(28 个簇,高质量、单残基糖);修饰残基中,蛋白修饰残基 51.0%(40 个簇)、DNA 修饰碱基 68.6%(91 个簇)、RNA 修饰碱基 40.9%(23 个簇)。
这组数据有两个需要留意的条件:共价配体和糖基化只保留了实验质量高于中位数的 X 射线结构,而且没有按与训练集的同源性过滤,因为按同源性过滤后分别只剩 5 个和 7 个簇;修饰残基数据集则做了与其他聚合物测试集相同的低同源过滤。在不限实验质量的数据上,多残基糖链成功率为 42.1%(131 个簇),略低于单残基糖的 46.1%(167 个簇)。
蛋白(对比 AlphaFold-Multimer v2.3)
全部蛋白–蛋白界面 DockQ > 0.23 的比例:AF3 76.6%,AF-M 2.3 67.5%(1,064 个簇,P = 1.81 × 10⁻¹⁸)。蛋白–抗体界面:AF3 62.9%,AF-M 2.3 29.6%(65 个簇,P = 6.54 × 10⁻⁵)。蛋白单体 LDDT:AF3 86.9,AF-M 2.3 85.5(338 个簇,P = 1.74 × 10⁻³⁴)。
注意抗体这一组的采样条件特殊:两个模型都对每个靶标跑了 1,000 个随机种子再排序(AF3 每个种子 5 个扩散样本),其余任务都是标准的 5 个种子。这一点在 Fig. 5a 中有专门分析。
蛋白这一组的意义容易被低估:AF3 把建模范围扩展到几乎所有分子类型之后,蛋白单体和蛋白–蛋白界面的精度不降反升。单体 LDDT 只提高了 1.4,但在 338 个簇的配对检验中方向非常一致,所以显著性极强。
PoseBusters 还有一些正文没有展开、但很有参考价值的补充结果(Extended Data Fig. 4 与 Table 1)。在去除了晶体接触问题的 PoseBusters v2(308 个靶标)上,AF3 成功率 80.5%,Vina 59.7%(P = 2.3 × 10⁻⁸)。在”给定 holo 蛋白结构”的设定下,DiffDock 为 37.9%,Gold 为 51.2%;在”给定口袋残基”的设定下,Uni-Mol Docking V2 为 77.6%。作者另外微调了一个接收口袋信息的 AF3 版本,v1 成功率升到 90.2%,v2 为 93.2%。Extended Data Fig. 3 还给出三个 Vina 和 Gold 都失败、AF3 成功的例子,配体 RMSD 分别为 0.65 Å(Notum 抑制剂,8BTI)、1.3 Å(7KZ9)和 0.44 Å(Galectin-3 抑制剂,7XFA)。
Panel d 是推理架构图。黄色是输入数据,蓝色是网络内部的抽象表示,绿色是输出;彩色小球代表物理原子坐标。图中可以看到两个循环:主干网络的 recycling(虚线回到输入端),以及扩散模块自身的多轮去噪迭代。置信度模块同时接收主干表示和扩散模块生成的结构,输出 0–100 的置信度着色。
Figure 2 · 架构与训练细节
这张图想回答:AF3 内部到底换了什么,才能把这么多种分子放进同一个模型?
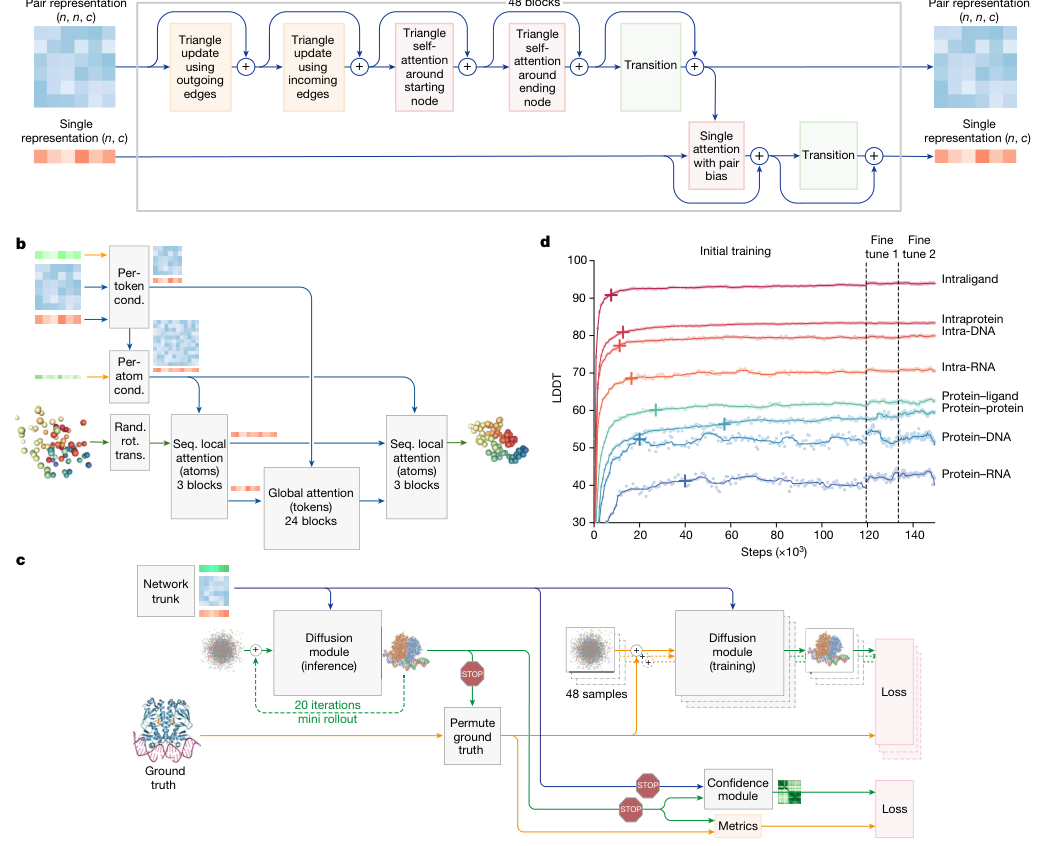
Figure 2. 架构与训练细节。a Pairformer 模块(48 个 block,反复更新 pair 与 single 表示)。b 扩散模块以 token/原子条件做序列局部与全局注意力。c 训练时的扩散 rollout 与置信度/指标分支。d 各类界面的 LDDT 随训练步数的变化。
- Panel a 是主干核心 Pairformer:pair 表示(n×n×128)经三角更新和三角自注意力反复精修,single 表示(n×384)再用带 pair 偏置的注意力更新,共 48 个 block。相比 AF2 的 Evoformer,这里把重度依赖 MSA 的部分压缩掉,只保留对 pair 表示的几何推理。
- Panel b、c 是扩散模块:它直接在原子坐标上去噪,不再用 frame、扭转角和等变网络,所以任意化学组分(配体原子、糖、修饰残基)都能统一表示;训练时跑一个 20 步的 mini-rollout,并分出置信度和指标两个分支。
- Panel d 是训练曲线:七类界面(intraligand、蛋白–蛋白、蛋白–DNA/RNA 等)的 LDDT 随步数上升,到约 12 万步后两轮微调(fine-tune 1/2)再抬一截。可以看出蛋白内部(intraprotein)起点最高,蛋白–RNA 最低——这与后面各类任务的难度排序一致。
Figure 3 · 能处理多复杂的体系
这张图想回答:AF3 实际能一次预测出多大、多混合的复合物?
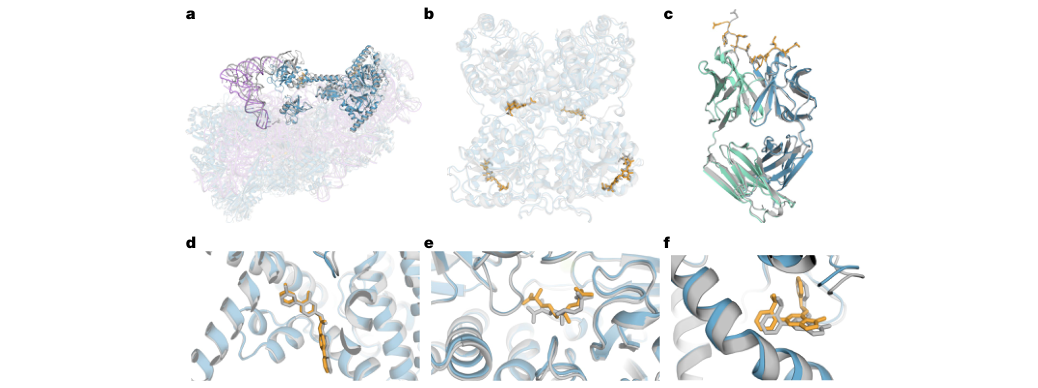
Figure 3. AF3 预测的复合物示例,预测蛋白为蓝色(抗体绿色)、配体与糖为橙色、RNA 紫色,灰色为实验结构。a 人 40S 小核糖体亚基(7,663 残基,含 18S rRNA 与起始 tRNA);b–f 蛋白–配体、蛋白–蛋白界面的放大。
- Panel a 是最震撼的例子:人 40S 小核糖体亚基,7,663 个残基,由 18S rRNA 加几十条蛋白外加一条起始 tRNA 组成。彩色预测与灰色实验结构几乎重叠,说明 AF3 能把核酸、蛋白、tRNA 放在同一次预测里联合建模。
- Panel b–f 把若干蛋白–配体、蛋白–蛋白界面放大:橙色配体嵌进蓝色蛋白口袋,与灰色真实结构贴合。这些例子覆盖了「蛋白 + 核酸 + 小分子 + 糖 + 抗体」的多种组合,正是过去要靠好几种专用工具分段处理的场景。
Figure 4 · 置信度能不能信
这张图想回答:AF3 自己给出的置信度,和预测真实准不准对得上吗?
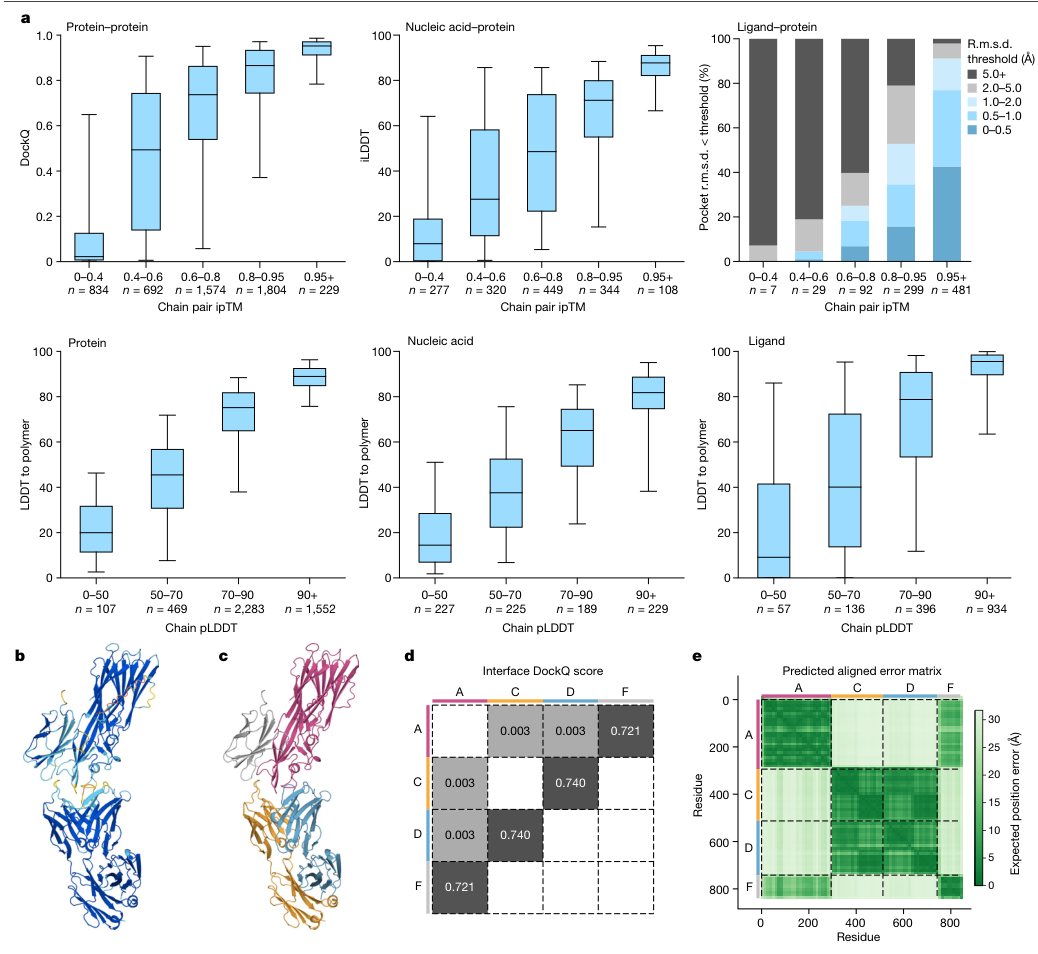
Figure 4. AF3 置信度跟踪准确率。a 上:蛋白相关界面准确率随链对 ipTM 变化;下:各类链的 LDDT-to-polymer 随链平均 pLDDT 变化。b–c 同一复合物的两种预测。d 界面 DockQ 矩阵。e 预测的 PAE 矩阵。
- Panel a:把预测按置信度分箱,箱线图显示置信度越高、真实准确率越高——链对 ipTM 与蛋白–蛋白 DockQ、蛋白–核酸 iLDDT 单调相关,链平均 pLDDT 与 LDDT-to-polymer 单调相关。也就是说,拿到结果先看置信度,大致就能判断该不该信。
- Panel d、e:对同一个四链复合物,DockQ 矩阵(d)显示哪些链对预测得好(如 A–F 的 0.721),PAE 矩阵(e)则能指出同一结构里哪些链对可信、哪些不可信——绿色越深表示该区域的相对位置预测误差越小。三种置信度(pLDDT、PAE、ipTM)各管一个层面。
Figure 5 · 哪些地方会出错
这张图想回答:AF3 还有哪些已知失败模式?困难靶标卡在哪一步?
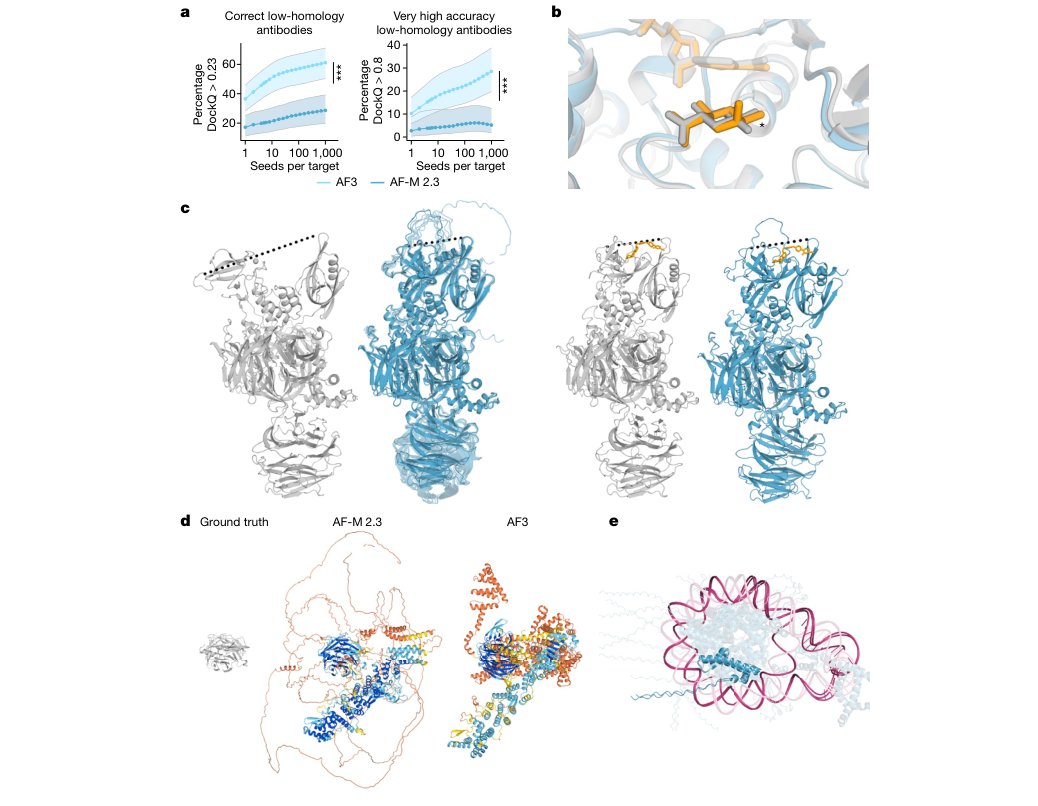
Figure 5. 模型局限。a 低同源抗体预测质量随模型种子数增加而提升(AF3 vs AF-M 2.3)。b 一个手性错误的例子。c–e 蛋白在无序区/构象覆盖上的「幻觉」与误差示例。
- Panel a 是最重要的局限分析:低同源抗体–抗原界面的正确率随种子数一路升到 1,000 个仍未饱和,而单纯增加每个种子的扩散样本没有同样效果。这说明困难靶标的瓶颈在「能不能采样到正确结构」,所以抗体任务才要跑上千个种子(其余任务只跑 5 个)。
- Panel b–e 展示其它失败模式:扩散模块的生成本质会对无序区产生看似合理、实则不存在的「幻觉」结构(d);约 4% 的样本出现手性错误(b);此外还有原子碰撞、构象覆盖不足等问题。用 AF3 结果时要结合 pLDDT、PAE、ipTM 一起判断,关键界面再用实验验证。
四、核心贡献总结
发现 1:一个统一模型可以在几乎所有类别上超过专用方法
在 Fig. 1c 有对比基线的任务中,AF3 只有一个类别(CASP15 RNA)没有超过最强的专用方法(且对手有人类专家参与),其余类别都明显更好,蛋白单体和蛋白–蛋白界面的精度也高于 AlphaFold-Multimer v2.3。
发现 2:不用任何结构输入,配体姿势预测就超过了使用实验结构的对接工具
PoseBusters v1 上 76.4% 对 Vina 的 52.3%,v2 上 80.5% 对 59.7%;提供口袋信息后进一步升到 90.2% 和 93.2%。这说明蛋白结构预测和配体对接可以合并成一个问题来解。
发现 3:架构简化反而带来了通用性
去掉 frame、扭转角、等变网络和立体化学违例损失,改用直接作用于原子坐标的扩散模块,让模型可以不做特殊处理就容纳任意化学组分;MSA 处理压缩到 4 个 block,主干以 Pairformer 为主。
发现 4:跨实体的共进化信息并非不可或缺
配体没有共进化信号,抗体–抗原界面也常缺少可靠的配对 MSA,AF3 在这两类任务上的提升都很大。作者据此认为,AlphaFold 系列方法可以在不依赖 MSA 的情况下建模某些类别分子相互作用的化学和物理规律。单链蛋白精度依然受 MSA 深度影响,这一点没有改变。
发现 5:置信度校准良好,三种置信度各有分工
链对 ipTM 与蛋白–蛋白 DockQ、蛋白–核酸 iLDDT、蛋白–配体成功率都单调相关;链平均 pLDDT 与 LDDT_to_polymer 单调相关;PAE 能区分同一复合物中哪些链对可信、哪些不可信。
发现 6:困难靶标的瓶颈在采样
低同源抗体–抗原界面的正确率随模型种子数持续提升,到 1,000 个种子仍未饱和,而增加每个种子的扩散样本没有同样效果。AF3 的最终表现取决于两个环节:能否采样到正确结构,以及置信度排序能否把它挑出来。
五、局限与展望
AlphaFold 3 的意义在于将生物分子结构预测从”一条蛋白链怎么折叠”推广到”几乎任意类型的分子如何组装”,用一个统一模型覆盖了蛋白质、核酸、小分子配体、离子和修饰残基。它还表明,蛋白结构预测和分子对接可以合并为同一个问题,甚至不需要实验蛋白结构就能超过传统对接工具。
局限同样明显:扩散模块的生成本质带来了”幻觉”风险——对无序区域生成看似合理但实际不存在的结构;手性错误在约 4% 的样本中出现;抗体–抗原等困难靶标需要采样上千个种子才接近饱和;RNA 预测精度仍不及部分专用方法(如 CASP15 中借助人工干预的 AIchemy_RNA2);模型训练和推理成本极高。使用时应检查 pLDDT、PAE 和 ipTM 三种置信度,并结合实验数据验证关键界面。
通讯作者介绍
本文的三位通讯作者是 Max Jaderberg、Demis Hassabis 和 John M. Jumper。Max Jaderberg 在论文中署名 Isomorphic Labs(伦敦),曾任该公司首席 AI 官;他在牛津大学获得工程科学本科学位,并在牛津大学视觉几何组(Visual Geometry Group)获得博士学位,博士阶段研究用于图像理解的深度学习算法,读博期间创办的视觉识别公司 Vision Factory 于 2014 年被 DeepMind 收购;此后他在 DeepMind 领导开放式学习(Open-Ended Learning)团队,主导或参与了 Capture the Flag、AlphaStar 等强化学习工作,加入 Isomorphic Labs 后主导了 AlphaFold 3 等药物设计 AI 模型的研发与应用。Demis Hassabis 在论文中同时署名 Google DeepMind 和 Isomorphic Labs,是 DeepMind 的联合创始人兼 CEO,也是 Isomorphic Labs 的创始人兼 CEO;他本科就读于剑桥大学计算机科学专业,2009 年在伦敦大学学院(UCL)获得认知神经科学博士学位,师从 Eleanor Maguire,博士期间研究海马体在情景记忆与想象中的作用,此后长期致力于通用人工智能、强化学习以及用 AI 推动科学发现。John M. Jumper 在论文中署名 Google DeepMind,领导 AlphaFold 团队;他在范德堡大学获得物理与数学学士学位,在剑桥大学获得理论凝聚态物理哲学硕士学位,随后在芝加哥大学获得理论化学硕士和博士学位,导师为 Tobin Sosnick 和 Karl Freed,博士论文研究用严格的机器学习方法建模粗粒化蛋白折叠与动力学,研究方向为蛋白质结构预测与面向生物分子的机器学习。Hassabis 与 Jumper 因 AlphaFold 在蛋白质结构预测上的贡献,与 David Baker 共同获得 2024 年诺贝尔化学奖。
引用
Abramson, J., Adler, J., Dunger, J., Evans, R., Green, T., Pritzel, A., … & Jumper, J. M. (2024). Accurate structure prediction of biomolecular interactions with AlphaFold 3. Nature, 630(8016), 493-500. https://doi.org/10.1038/s41586-024-07487-w