
BoltzGen: Toward Universal Binder Design
原文链接:全文
作者:Hannes Stark, Felix Faltings, MinGyu Choi, …, Tommi Jaakkola
bioRxiv,2025 年 11 月 24 日
导读
蛋白结合物设计的通用化面临两大瓶颈:传统方法把序列设计和结构生成分成独立阶段,导致不同阶段之间不一致;而现有模型大多只支持单一分子类型,难以同时处理蛋白、纳米抗体、肽和小分子靶标。BoltzGen 提出了一种全原子扩散模型——用”虚拟原子”几何编码氨基酸身份,使序列和结构在同一个连续扩散过程中联合生成。通过 8 类湿实验验证(涵盖 26 个靶标),在 9 个 PDB 中无已知结合物的新颖蛋白靶标上,纳米抗体和蛋白结合物均达到 66% 的靶标成功率,最佳亲和力达单位数纳摩尔。
一、研究问题
过去的结合物设计方法面临几个核心局限。首先,不同模型分别处理蛋白-蛋白、抗体-蛋白、蛋白-小分子等任务,难以用同一套框架覆盖多种模态。其次,常见设计流程将结构生成与序列设计分为两步——先生成蛋白骨架,再用逆折叠模型(如 ProteinMPNN)设计序列——两步之间缺乏反馈,骨架生成阶段无法考虑序列层面的化学细节,可能产生结构上合理但序列上难以实现的设计。第三,实验场景往往需要复杂约束:指定结合表位、回避特定区域、加入二硫键或其他共价键、固定部分骨架结构、限制二级结构类型,现有工具很难统一支持。第四,对训练集中见过的靶标效果较好,但外推到缺少已知结合物的新靶标时能力不明确。
BoltzGen 的核心思路是将结构预测和结合物设计合二为一。它继承了 Boltz-2 / AlphaFold3 的架构,以 PairFormer 作为推理核心、全原子扩散模块生成三维坐标,但引入了关键的表示创新——用几何结构直接编码氨基酸身份,将序列选择从离散分类问题转化为连续的三维几何问题,让序列、主链、侧链和靶标构象在同一个扩散过程中联合优化。作者还证明,这一设计不会牺牲结构预测能力——BoltzGen 在结构预测基准上的表现与 Boltz-2 基本持平,这支持了”准确预测原子相互作用的能力,也正是设计高质量界面所需要的能力”这一核心假设。
二、方法核心:几何编码与全原子扩散
蛋白设计需要同时确定两类变量:连续的原子坐标和离散的氨基酸类型。将离散变量纳入连续扩散框架是一个基本难题。BoltzGen 的解决方案是让每个待设计残基始终由 14 个原子位置表示。前 4 个固定对应主链原子 N、Cα、C、O,其余原子中一部分是真实侧链原子,另一部分是“虚拟原子”——叠放到主链 N 或 O 附近的额外位置。虚拟原子的数量和空间排列形成了一种氨基酸类型的几何编码:模型通过观察哪些原子叠放在 N 附近、哪些叠放在 O 附近来推断该残基是苏氨酸、脯氨酸还是其他类型。生成完成后虚拟原子被删除,只保留真实原子。这一方案优雅地绕开了在扩散模型中混合离散和连续变量的技术难题。
这种设计使模型在每一步去噪时可以同时推理”这个位置应该是哪种氨基酸”、”它的侧链朝向哪里”、”它如何与靶标形成氢键、盐桥和疏水接触”——序列和结构的决策在同一个连续空间中自然耦合。模型架构分为两部分:Trunk(PairFormer)处理残基/原子类型、分子链信息、共价键、结构模板和约束条件,建立单体表示和成对表示;Diffusion Module 从随机噪声出发,经 300 次函数评估逐步去噪,生成整个复合物的全原子坐标。训练数据包括 PDB 实验结构(采样权重 60%)、AlphaFold DB 自蒸馏结构(30%)和蛋白-小分子/核酸蒸馏数据(10%),截止到 2023 年 6 月。训练损失包含坐标去噪损失、键长损失和平滑 lDDT 损失,对核酸和小分子原子给予更高权重以避免蛋白原子数量占优势。训练过程中随机选择复合物的不同区域进行设计,使同一个训练框架覆盖折叠预测、结合物设计、模体支架和无条件生成等多种任务。
上图为 BoltzGen 的完整设计管线。Panel a 展示模型接受任意模态的靶标(蛋白、核酸、小分子)以及各种约束条件作为输入,输出遵守约束的全原子复合物结构。Panel b 展示各阶段运行时间(约 200 残基复合物为例):BoltzGen 生成约 6 秒、BoltzIF 逆折叠约 1 秒、Boltz-2 重折叠验证约 36 秒、亲和力预测约 17 秒、分析与过滤约 2 秒。Panel c 为详细流程:BoltzGen 生成候选全原子结构 → BoltzIF 重新设计序列以提高可折叠性和溶解性 → Boltz-2 独立预测复合物结构并检查与原始设计的一致性 → 计算氢键数量、盐桥、埋藏面积、疏水斑块、溶解性等指标 → 使用”最差指标排名”策略排序(优先保留没有明显短板的设计)→ 多样性优化避免输出重复骨架 → 最终选出少量实验候选。
设计规范语言
BoltzGen 支持丰富的约束输入。共价键约束可指定任意原子间形成共价键,因此可以设计二硫键环肽、头尾环化肽、化学钉固定的 helicon 等。结构约束可固定靶标结构、纳米抗体框架或功能模体,允许其他区域自由生成。结合/排斥位点标记可指定希望结合物靠近或远离的残基,实现表位靶向和区域回避。二级结构约束可要求设计残基形成 α 螺旋、β 折叠或 loop。
这套约束体系使同一个模型可以处理纳米抗体(固定框架区、重设计 CDR 环)、二硫键环肽(指定共价键位置)、模体支架(固定功能模体周围生成蛋白骨架)等多种设计任务。
三、看图说话
这篇论文的实验规模很大,正文一共 21 张主图。大致分三组:Fig 1–5 是湿实验验证的总览与主结果,Fig 6–12 讲方法与管线,Fig 13–21 是各类应用的详细表征。下面逐张来看。
Figure 1 · 八类湿实验的总览
这张图想回答:BoltzGen 到底被验证到什么程度——覆盖了哪些靶标类型和应用场景?
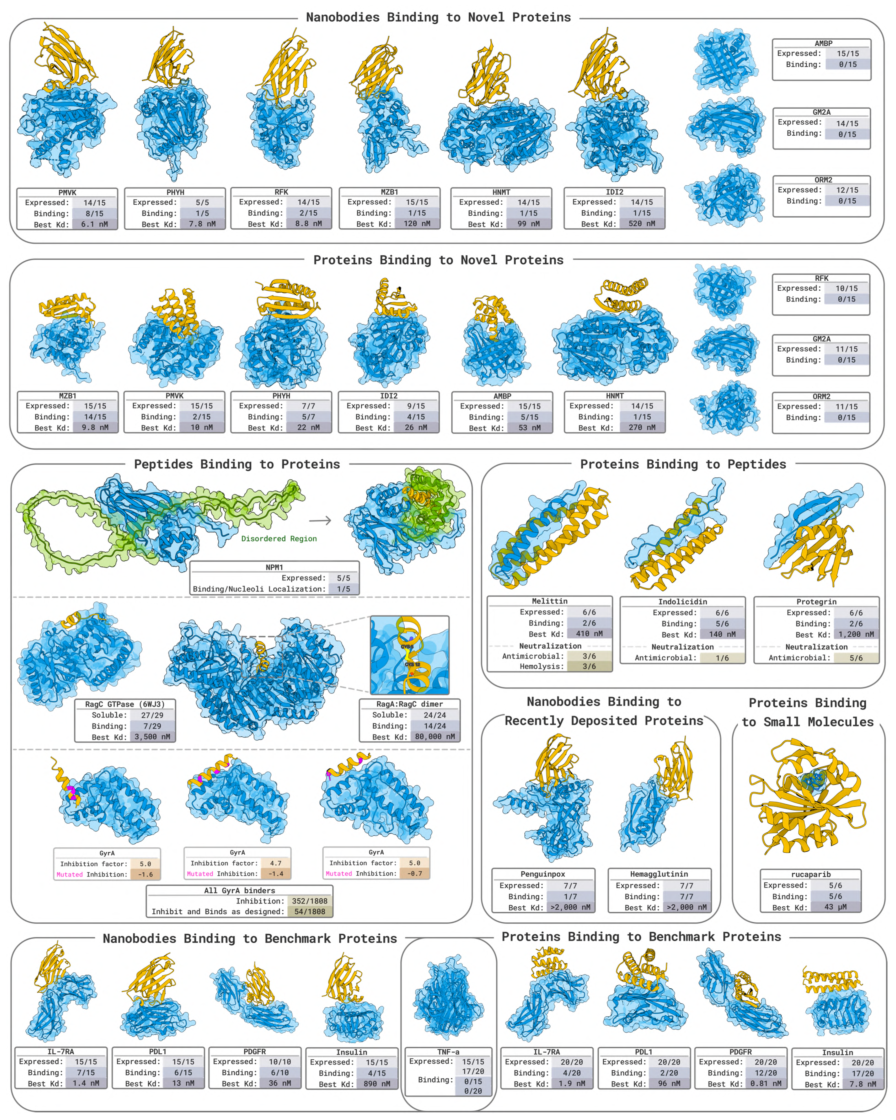
Figure 1. BoltzGen 湿实验验证总览。与多个实验室合作,覆盖新颖蛋白靶标的纳米抗体/蛋白结合物、生物活性肽中和、肽/环肽设计、小分子结合、基准靶标等多类任务,每格给出表达数、结合数和最佳 Kd。
这是一张把全部湿实验塞进一页的「成绩单」:每个小块是一个靶标,列出 Expressed / Binding / Best Kd。它想传达的核心是 一个模型覆盖了纳米抗体、蛋白、肽、环肽、小分子结合等差别极大的任务,并且都拿到了真实实验数据。后面 Fig 2–21 就是把这张总览里的各个板块逐一展开。
Figure 2 · 9 个新颖靶标的纳米抗体
这张图想回答:在 PDB 里没有已知结合物的 9 个新靶标上,设计的纳米抗体有几个真能纳摩尔结合?
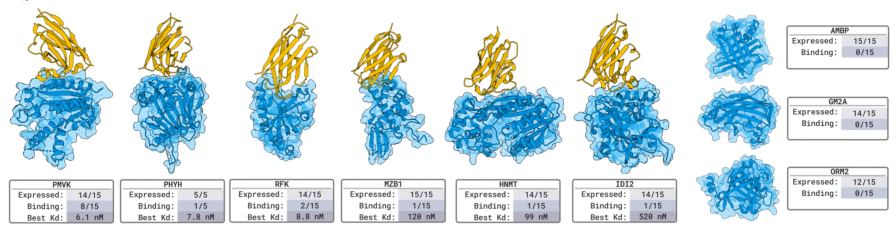
Figure 2. 9 个新颖靶标的纳米抗体设计。每个靶标选 15 个做 SPR/BLI,橙色为设计纳米抗体、蓝色为靶标,下方标注表达/结合/最佳 Kd。
「新颖」的标准很严:PDB 里不存在与该靶标全长一致性 >30% 且出现在已知结合复合物中的蛋白,模型无法靠记忆已有界面取巧。每靶标生成约 6 万候选、固定框架区、只重设计 3 个 CDR 环。结果 6/9 个靶标拿到纳摩尔结合物:PMVK 6.1 nM、PHYH 7.8 nM、RFK 8.8 nM,另有 HNMT、MZB1、IDI2;全部不结合人血清白蛋白,初步排除非特异。
Figure 3 · 9 个新颖靶标的蛋白结合物
这张图想回答:换成全新设计的小蛋白(不指定结合位点),在同样 9 个新靶标上表现如何?
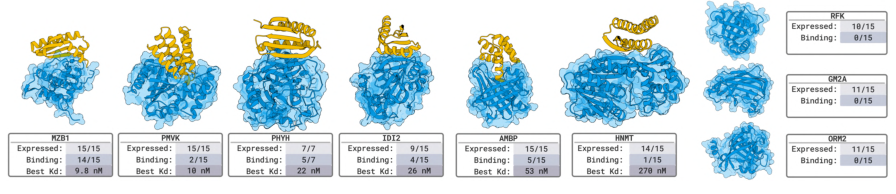
Figure 3. 9 个新颖靶标的蛋白结合物(80–140 aa,不指定结合位点),每靶标评测 15 个设计。
蛋白结合物同样 6/9 靶标拿到纳摩尔(MZB1 9.8 nM、PMVK 10 nM、PHYH 22 nM、IDI2 26 nM、AMBP 53 nM)。有意思的是两种模态成功的靶标并不完全重合——RFK 上纳米抗体行、蛋白不行;AMBP 上蛋白行、纳米抗体不行。说明不同形状的结合物适配不同的靶标表面,多种模态可以互补覆盖更多靶标。
Figure 4 · 5 个基准靶标的纳米抗体
这张图想回答:在 PD-L1、IL-7Rα 等有大量已知结构的经典靶标上,纳米抗体成功率如何?
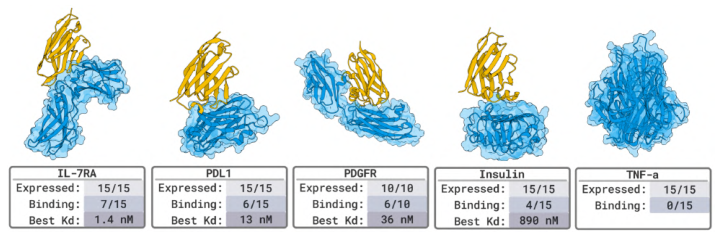
Figure 4. 5 个基准蛋白(IL-7RA、PDL1、PDGFR、Insulin、TNF-α)的纳米抗体设计,每靶标 ≤15 个设计。
基准靶标上 4/5 成功(80%),IL-7RA 达 1.4 nM。但要留意:这些靶标在 PDB 里已有大量已知复合物(PD-L1 就有几十个),模型可能重组了已有界面模式,所以证据力度不如 Fig 2/3 的新颖靶标。
Figure 5 · 5 个基准靶标的蛋白结合物
这张图想回答:基准靶标上的蛋白结合物能做到多强的亲和力?
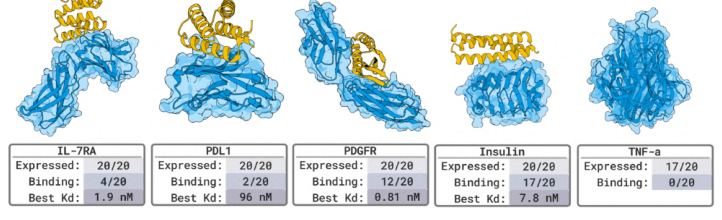
Figure 5. 5 个基准蛋白的蛋白结合物,每靶标测 20 个设计。
同样 4/5 成功,其中 PDGFR 达到 0.81 nM(亚纳摩尔)。唯一失败的是 TNF-α。基准实验主要用来和已有方法对齐,真正体现泛化能力的还是前面的新颖靶标。
Figure 6 · 完整设计管线
这张图想回答:从靶标输入到选出实验候选,整条管线有哪些步骤、各花多久?
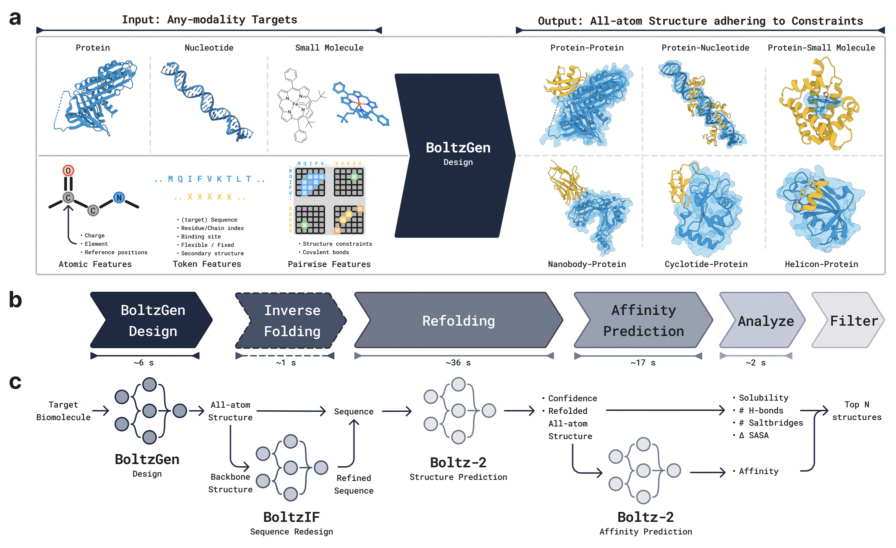
Figure 6. BoltzGen 管线总览。(a) 接受任意模态靶标和约束,输出遵守约束的全原子结构。(b) 各阶段耗时。(c) 生成→逆折叠→重折叠→亲和力预测→分析过滤的详细流程。
以约 200 残基复合物为例:BoltzGen 生成约 6 s、BoltzIF 逆折叠约 1 s、Boltz-2 重折叠验证约 36 s、亲和力预测约 17 s、分析过滤约 2 s。关键是用「最差指标排名」策略排序——优先保留没有明显短板的设计,再做多样性优化避免输出重复骨架。66% 的成功率是这整条漏斗的结果,不是单个设计的概率。
Figure 7 · 用虚拟原子编码氨基酸
这张图想回答:离散的氨基酸类型怎么塞进连续的坐标扩散里?
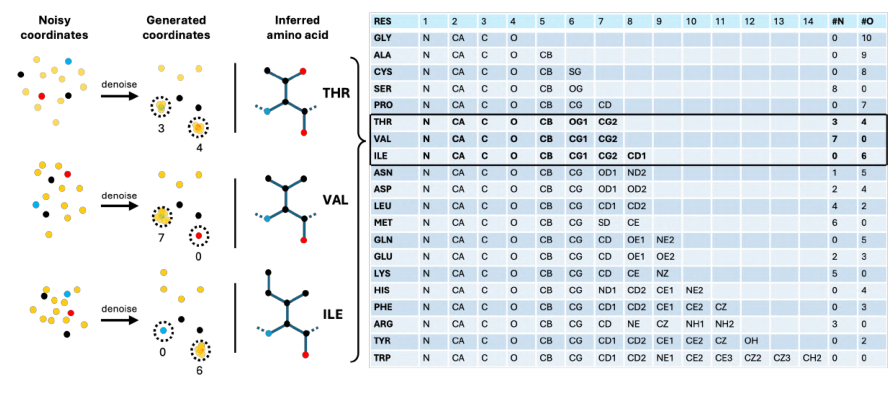
Figure 7. 残基类型编码。每个设计残基用 14 个原子表示,模型训练时把其中一部分「标记原子」叠到特定主链原子上,用叠放模式表示氨基酸类型,解码后丢弃。
这是全文最巧妙的设计。前 4 个原子固定是主链 N、Cα、C、O,其余原子里一部分是真实侧链、一部分是 叠放在 N 或 O 附近的「虚拟原子」。右边的表给出每种氨基酸该把几个原子叠到哪里(如 THR/VAL/ILE 的不同模式)。模型通过「哪些原子叠在 N 附近、哪些叠在 O 附近」来推断残基类型,于是把离散的序列选择变成了连续的几何问题,序列和结构能在同一个扩散过程里联合生成。生成完虚拟原子删掉。
Figure 8 · 模型架构
这张图想回答:相比 AlphaFold3 / Boltz-2,BoltzGen 的架构改了什么?
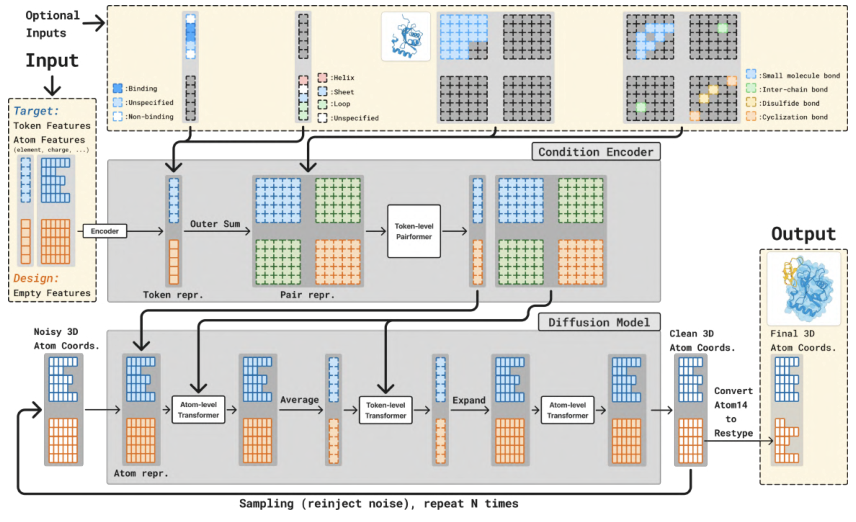
Figure 8. 模型架构,保留 AlphaFold3/Boltz-2 的 condition encoder(trunk)和扩散模块,主要增加了 design token 以及结合位点、靶标结构等额外输入。
上半部是 Condition Encoder:把残基/原子类型、链信息、共价键、模板、约束(结合位点、二级结构等)编码成 token 和 pair 表示,经 token 级 Pairformer 处理。下半部是扩散模块,从噪声坐标出发经原子级/token 级 Transformer 反复去噪,最后把 14 原子表示转回氨基酸类型。关键点:设计任务和结构预测共用同一套架构,作者据此论证「能准确预测原子相互作用的能力,正是设计高质量界面所需的能力」。
Figure 9 · 设计规范语言
这张图想回答:怎样用一套规范语言表达环肽、共价键、固定框架等各种设计需求?
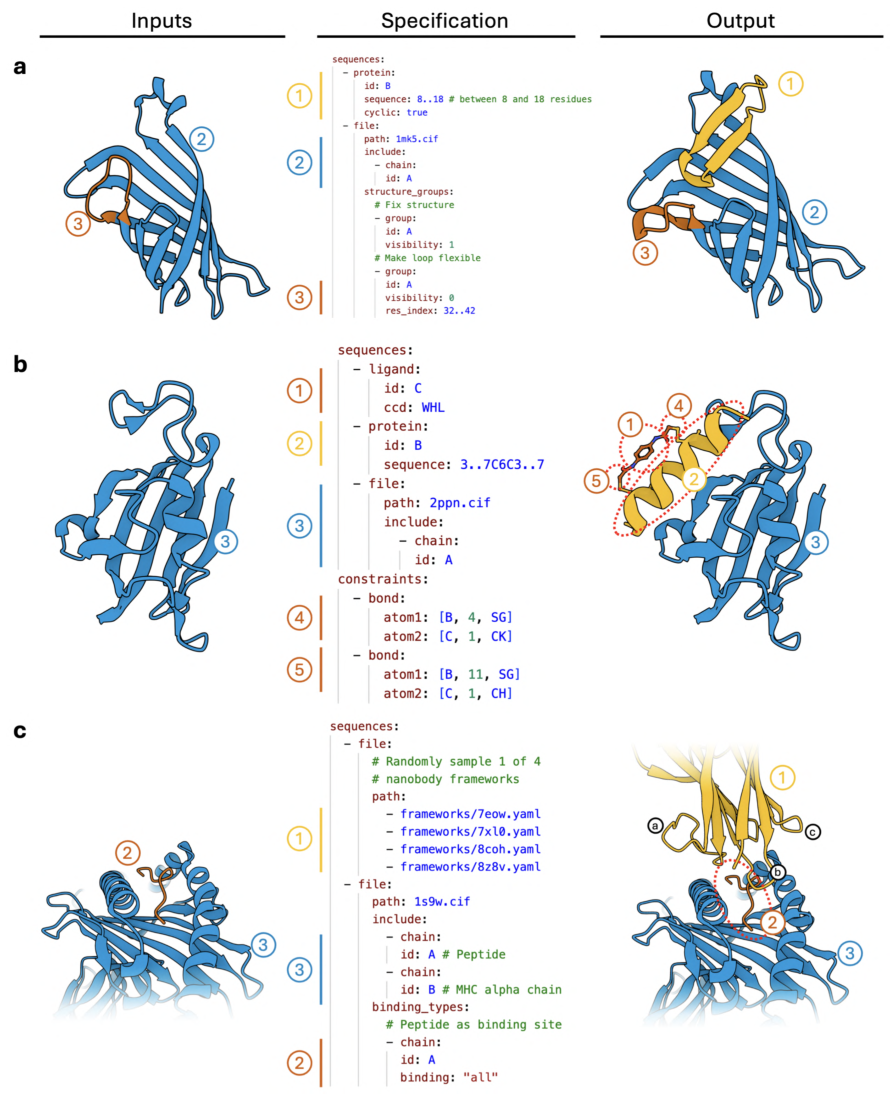
Figure 9. 设计规范语言的三个例子(左输入、中规范、右输出)。(a) 针对 streptavidin 的环肽,部分靶标结构留柔性。(b) 带二硫键约束的 helicon。(c) 从 4 种框架随机选的纳米抗体。
中间一列是 YAML 式的规范:可以指定序列长度范围、固定某条链结构、设 共价键约束(做二硫键环肽、头尾环化肽、化学钉 helicon)、标 binding/not-binding 位点(表位靶向、区域回避)、要求某段形成螺旋或折叠。同一个模型靠这套语言覆盖纳米抗体、环肽、模体支架等多种任务,不用为每种任务单独训练。
Figure 10 · 训练时的裁剪与条件采样
这张图想回答:一个模型怎样在训练中同时学会折叠预测、结合物设计、模体支架等任务?
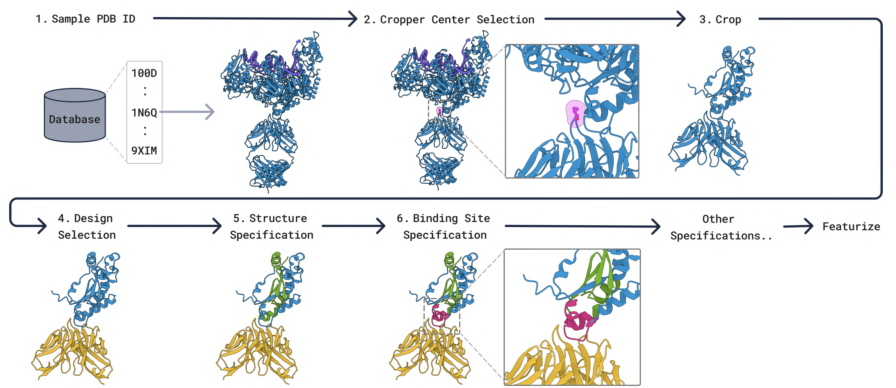
Figure 10. 训练时的裁剪、选择与规范。从数据库采一个 PDB 结构、裁剪,再可选地指定哪些链用于设计(黄色),并叠加固定靶标、结合位点等多种条件。
每个训练样本随机裁一块结构、随机选一部分链「标为待设计」,再随机叠加各种条件。同一个训练框架于是覆盖了折叠预测、结合物设计、模体支架、无条件生成——哪些区域被标为设计、给了什么约束,决定了这一步在学哪种任务。
Figure 11 · EDM 采样器
这张图想回答:去噪每一步是怎么走的?为什么要调噪声和步长系数?
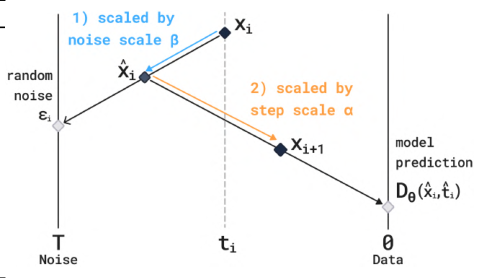
Figure 11. EDM 采样器。每次去噪先朝噪声方向走一步(按 β 缩放),再朝模型预测方向走一步(按 α 缩放)。
示意每一步去噪:从当前点先按噪声系数 β 加点噪声,再按步长系数 α 朝模型预测的「干净结构」方向移动。取 α、β ≠ 1 时已不再严格采样训练分布,而是一种启发式缩放,用来在采样质量和多样性之间调节。
Figure 12 · 各步骤的耗时随规模变化
这张图想回答:复合物越大,管线各步分别慢多少?瓶颈在哪?
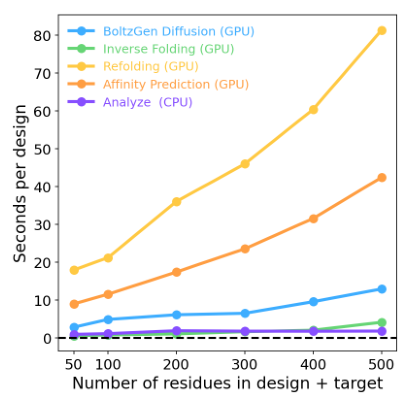
Figure 12. 单张 A100 上,各步骤每个设计的耗时随「设计+靶标」残基数变化。
五条线分别是 BoltzGen 生成、逆折叠、重折叠、亲和力预测、分析。重折叠验证(黄)是最大的时间开销,500 残基时约 80 s/设计,其次是亲和力预测;生成本身、逆折叠和分析都很快。也就是说瓶颈不在「生成」而在「验证」。
Figure 13 · 蜂毒肽结合物的表征
这张图想回答:针对蜂毒肽设计的结合物能表达、折叠、结合并中和它的溶血活性吗?
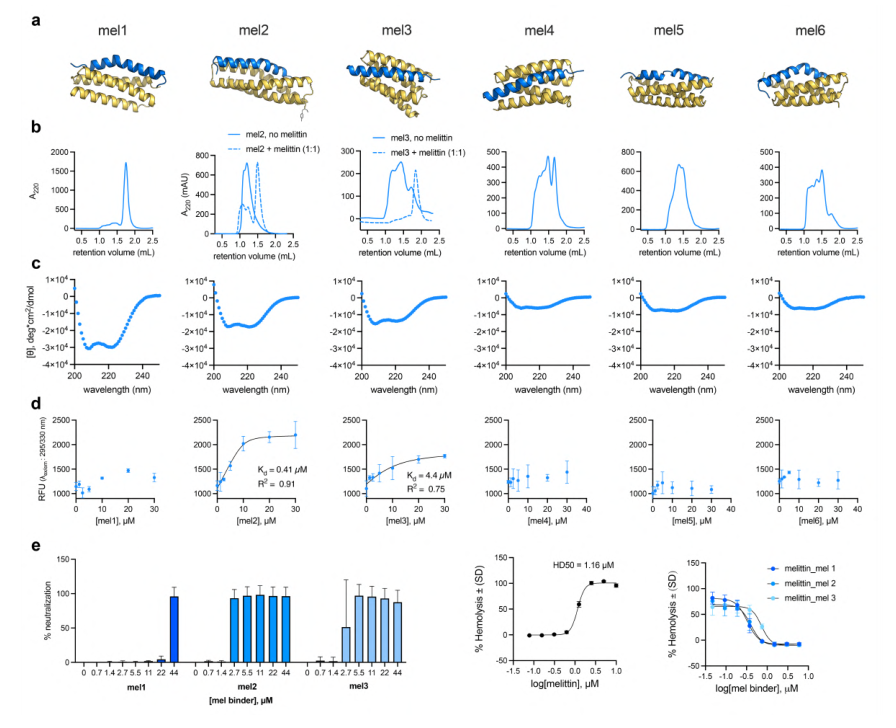
Figure 13. 蜂毒肽(melittin)结合物表征。(a) 预测结构,均为螺旋并结合蜂毒肽的两亲性螺旋态。(b) aSEC。(c) 圆二色。(d) 结合滴定。(e) 中和溶血活性。
蜂毒肽结合膜时形成两亲性螺旋。6 个设计里 Mel2 的 KD = 0.41 μM,panel e 显示多个设计能中和蜂毒肽的溶血/抗菌活性——说明设计的结合物能在体外「封存」靶肽、消除其生物活性。
Figure 14 · indolicidin 结合物的表征
这张图想回答:对构象柔性、非典型的 indolicidin,结合物还能工作吗?
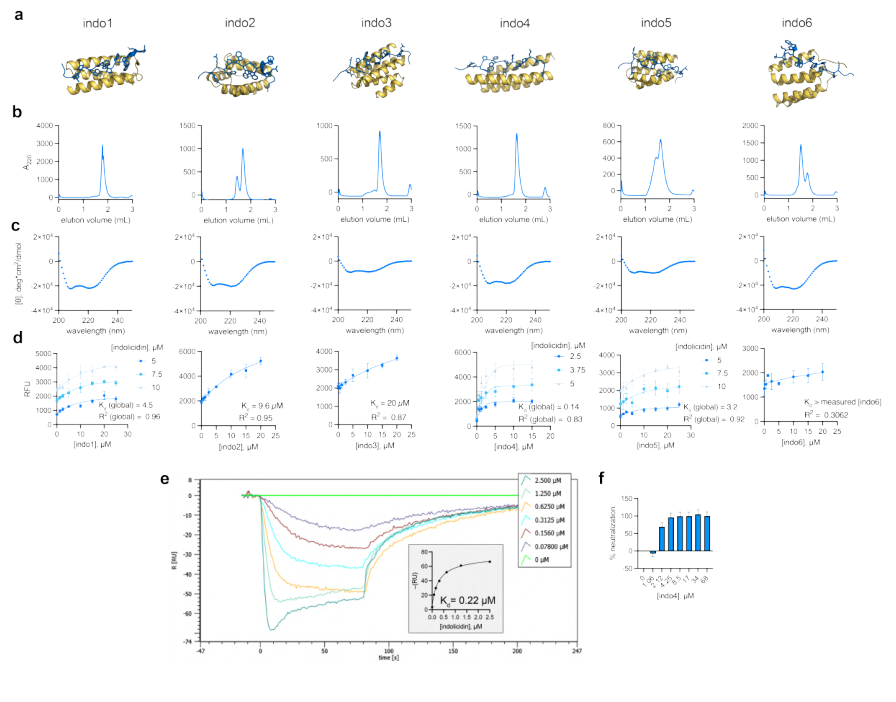
Figure 14. indolicidin 结合物表征。(a) 预测为螺旋构象。(b) aSEC 显示不同寡聚态。(c) 圆二色。(d) 结合滴定。(e) BLI 传感曲线。(f) 中和。
indolicidin 构象柔性、不规则,是更难的靶。6 个设计里 Indo4 经 SPR/BLI 达到纳摩尔亲和力(panel e 的传感曲线给出 KD = 0.22 μM 量级拟合),panel f 显示能中和其抗菌活性。
Figure 15 · protegrin 结合物的表征
这张图想回答:对二硫键稳定的 β 发夹肽 protegrin,设计的螺旋结合物能不能抓住它?
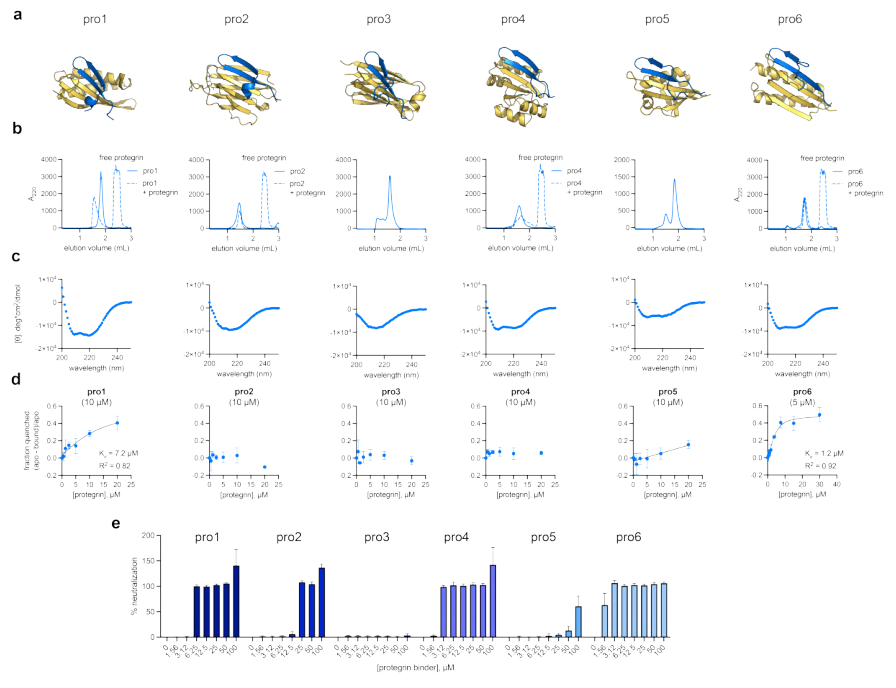
Figure 15. protegrin 结合物表征。(a) 预测为螺旋构象。(b) aSEC。(c) 圆二色。(d) 结合滴定。(e) 中和抗菌活性。
protegrin 由二硫键稳定成 β 发夹,和前两个肽结构差别很大。设计的螺旋结合物同样 6 个里有命中,panel e 显示能中和其抗菌活性。三种结构迥异的肽(螺旋/柔性/β 发夹)都能被设计出功能性结合物,体现了方法的通用性。
Figure 16 · NPM1 无序区结合物的细胞验证
这张图想回答:针对 NPM1 无序区设计的肽,能在活细胞里找到并结合目标吗?
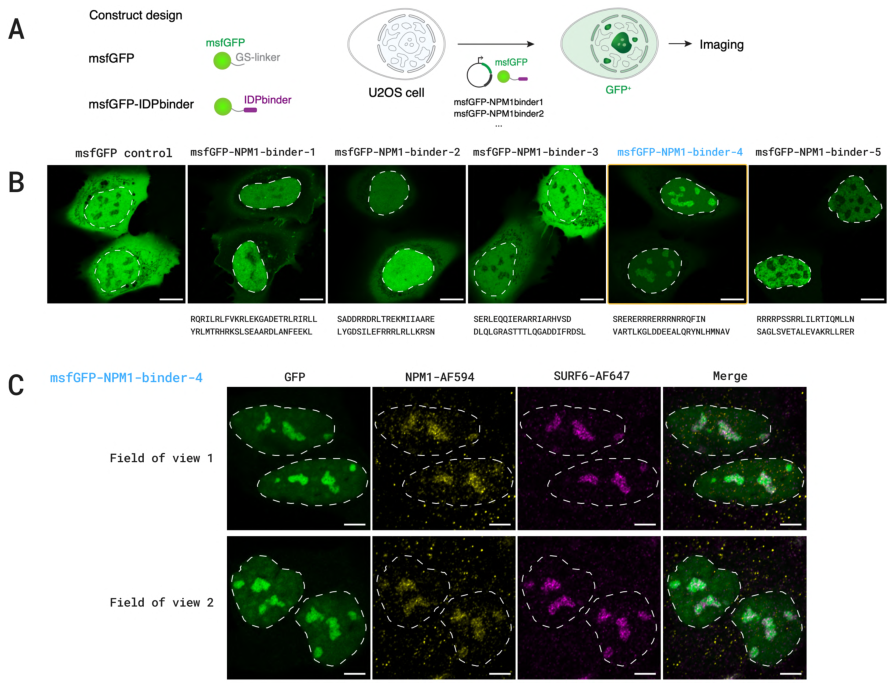
Figure 16. (A) msfGFP 标记的 NPM1 结合物设计与细胞定位实验示意。(B) U2OS 活细胞荧光图,虚线标出细胞核。(C) NPM1-binder-4 与内源 NPM1、SURF6 的共定位。
NPM1 的结合区是无序区,设计时用规范语言把无序区标为 binding、结构化 β 区标为 not-binding,允许无序区结合时共折叠。5 个设计里 有 1 个(binder-4)在活细胞里富集到核仁、与内源 NPM1 共定位——这是细胞内结合的间接证据(非直接亲和力测量)。
Figure 17 · 酵母展示的可行性评估
这张图想回答:用酵母表面展示快速筛查,设计的纳米抗体能检测到抗原结合信号吗?
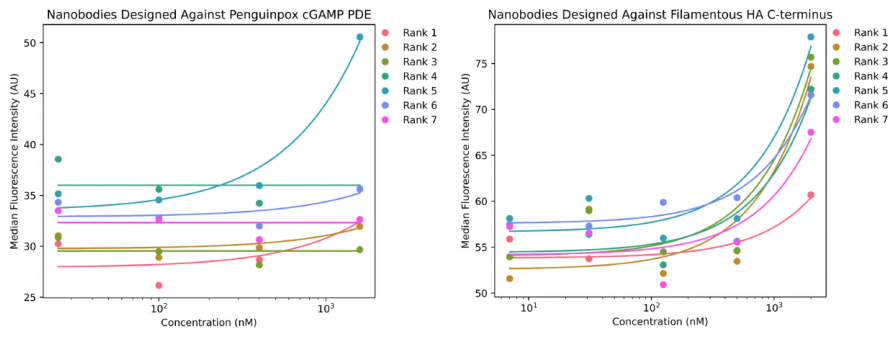
Figure 17. 纳米抗体的酵母表面展示(YSD)可行性评估。展示针对 cGAMP PDE(左)和 FhaB(右)的纳米抗体在不同抗原浓度下的中位荧光强度。
两张图是不同 rank 的纳米抗体在抗原浓度梯度下的荧光强度。信号随浓度上升、在最高浓度最明显,说明 酵母展示可以作为快速可行性筛查,但这里是初步评估,真正的亲和力仍以 SPR/BLI 为准。
Figure 18 · rucaparib 小分子结合蛋白
这张图想回答:通用模型能从头造出一个结合小分子药物 rucaparib 的口袋吗?
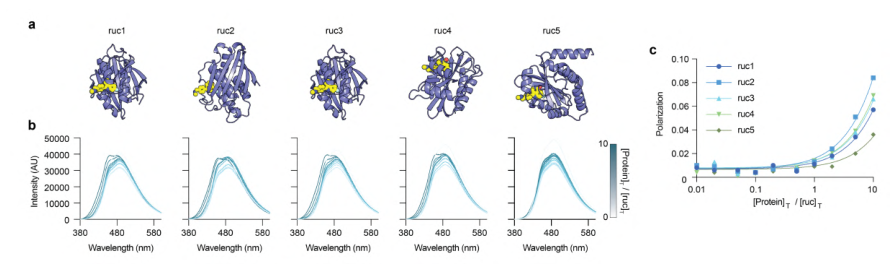
Figure 18. rucaparib 结合蛋白设计。(a) 设计蛋白(紫)与 rucaparib(黄)的复合物模型。(b) rucaparib 随设计蛋白滴定的荧光发射谱。(c) 偏振滴定曲线。
针对 PARP 抑制剂 rucaparib 设计结合口袋,6 个设计里 5 个表达、全部出现结合,最佳约 43 μM。证明通用模型能从头生成小分子结合口袋,但 μM 级亲和力与专门化小分子方法的纳摩尔水平还有明显差距。
Figure 19 · GyrA 抗菌肽的大规模体内筛选
这张图想回答:上千个设计肽里,有多少真能在细菌体内抑制 GyrA,而且是按设计的方式起作用?
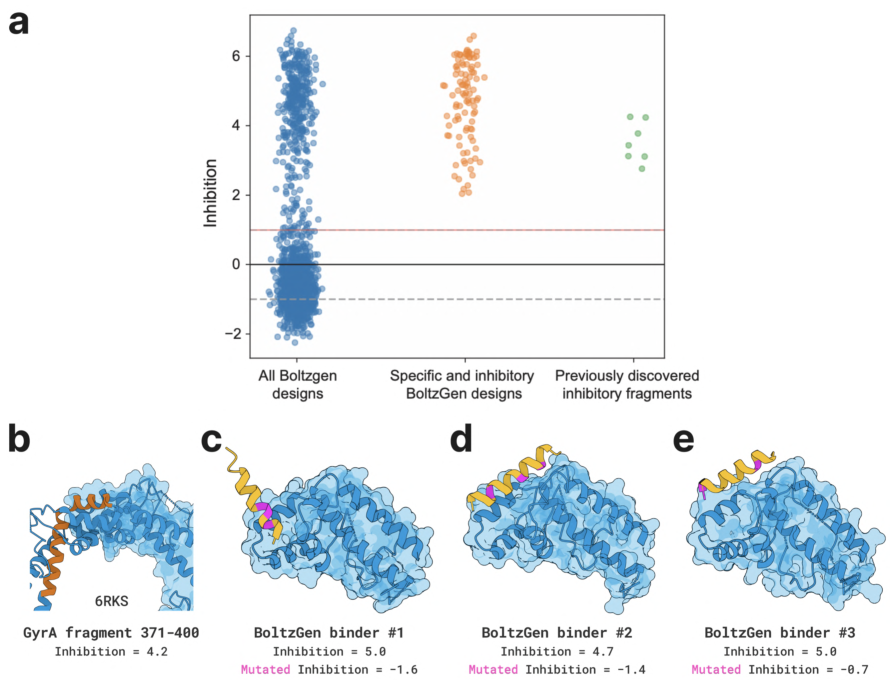
Figure 19. BoltzGen 设计的结合物是有效的体内 DNA 旋转酶抑制剂。(a) 所有 GyrA 设计的体内抑制值 swarm 图(全部设计 / 特异且抑制的设计 / 已知抑制片段)。(b–e) GyrA 片段与三个 BoltzGen 结合物的结构,标注野生型与突变后的抑制值。
这是论文最大规模的实验,共测 1,808 个针对大肠杆菌 GyrA 的抗菌肽。352 个(19.5%)使细菌生长降低至少 4 倍;对每个设计再做 3 个预测界面残基突变为丙氨酸的对照,54 个(3.0%)突变后显著失活,证明它们确实按预测方式靶向 GyrA。比随机 eGFP 片段对照产生抑制的比例高约 43 倍(panel b–e 的三个例子:野生型抑制 ~5,突变后降到负值)。
Figure 20 · 结构预测能力不输 Boltz-2
这张图想回答:加了设计能力后,BoltzGen 的结构预测精度有没有退化?
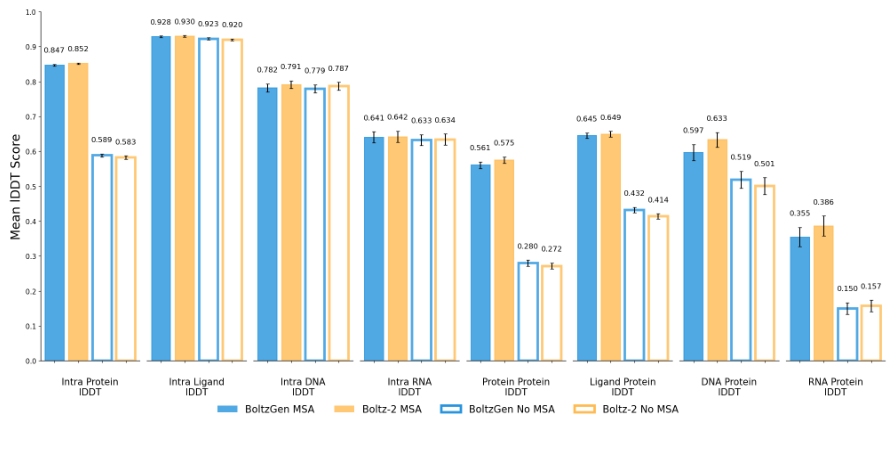
Figure 20. 结构预测评测。各类界面(蛋白内部、配体、DNA、RNA、蛋白-蛋白等)的最佳 lDDT,比较 BoltzGen 与 Boltz-2、有无 MSA 的情形。
成对柱状图里 BoltzGen(蓝)和 Boltz-2(橙)几乎一样高(如 Intra Protein 0.847 vs 0.852、Protein-Protein 0.561 vs 0.575)。这支撑了核心假设:加入设计能力没有牺牲结构预测精度,而「能准确预测相互作用」正是「能设计好界面」的前提。
Figure 21 · 设计是否真的「看着靶标」
这张图想回答:模型是真的根据靶标调整设计,还是在生成与靶标无关的通用结构?
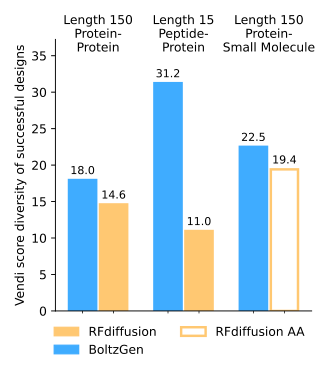
Figure 21. 靶标条件化量化。对 110 个靶标各设计一个结合物,成功重折叠复合物的多样性(Vendi diversity score),对比 RFdiffusion / RFdiffusionAA。
如果模型只会生成千篇一律的结构,对不同靶标的设计就会高度雷同。三组任务(蛋白-蛋白、肽-蛋白、蛋白-小分子)里 BoltzGen 的 Vendi 多样性分都高于 RFdiffusion/RFdiffusionAA,尤其肽-蛋白任务(31.2 vs 11.0)。说明它确实在「看着靶标表面特征」来调整设计,而不是生成与靶标无关的通用骨架。
四、核心贡献总结
上图为全部 8 类湿实验的总览。除新颖靶标外,BoltzGen 还在多种应用场景中进行了验证:
生物活性肽中和物:针对蜂毒肽(melittin)、indolicidin 和 protegrin 三种结构差异很大的抗菌/溶血肽设计蛋白结合物——melittin 结合膜时形成两亲性螺旋,indolicidin 构象柔性且非典型,protegrin 由二硫键稳定形成 β 发夹。每种肽只测试 6 个设计:Melittin 的 Mel2 设计达到 KD = 0.41 μM,indolicidin 的 Indo4 经 SPR 验证达到纳摩尔亲和力,多个设计可中和靶肽的抗菌或溶血活性。这些结果表明设计的结合物具备功能性”封存”能力,可以在体外消除靶肽的生物活性。
RagC 肽设计:针对 RagC GTPase 设计线性肽(5-20 氨基酸),29 个测试中 7 个出现 SPR 结合,最佳 KD = 3.5 μM。部分序列经随机打乱后完全失去结合,证明活性依赖具体序列。针对 RagA:RagC 的二硫键环肽实验中 14/24 出现特异结合,但亲和力较弱(约 80 μM)。
GyrA 抗菌肽大规模筛选:论文中规模最大的实验,共测试 1,808 个针对大肠杆菌 GyrA 的抗菌肽候选。其中 352 个(19.5%)使大肠杆菌生长降低至少 4 倍;对每个设计额外构造了 3 个预测界面残基突变为丙氨酸的对照,54 个设计(3.0%)在突变后显著丧失活性,表明这些肽确实按照预测的方式靶向 GyrA 的特定位点。与随机 eGFP 片段对照相比,BoltzGen 设计产生生长抑制的比例高约 43 倍。
NPM1 无序区域结合:针对 NPM1 蛋白的无序区域设计 40-80 氨基酸的结合肽,利用设计规范语言指定无序区为 binding 区域、结构化的 β 区域为 not-binding 区域,允许无序区在结合时发生共同折叠。测试的 5 个设计中有 1 个在活细胞中富集于核仁,与内源 NPM1 共定位,提供了细胞内结合的间接证据。
小分子结合蛋白:针对 rucaparib(PARP 抑制剂)和一种 rhodamine 衍生物设计蛋白结合口袋。Rucaparib 的 6 个设计中 5 个成功表达且全部出现结合,最佳 43 μM;rhodamine 衍生物 4/4 出现结合,最佳 30.9 μM。这证明通用模型可以从头生成小分子结合口袋,但亲和力与专门化方法已实现的纳摩尔水平仍有明显差距。
基准靶标:在 PD-L1、PDGFR、IL-7Rα、InsulinR、TNFα 五个经典靶标上达到 80% 的靶标成功率,纳米抗体对 IL-7Rα 达到 1.4 nM,蛋白结合物对 PDGFR 的最佳亲和力达 0.81 nM(亚纳摩尔)。但这些靶标在 PDB 中已有大量已知复合物(如 PD-L1 有数十个相关复合物),模型可能学习并重组了已有界面模式,因此证据力度明显低于新颖靶标实验。
五、局限与展望
论文的实验结果均来自”大规模生成 → 严格计算筛选 → 少量实验测试”的流程。典型场景是从 60,000 个候选中挑出 15 个进行验证,因此 66% 的靶标成功率反映的是整套管线的富集能力,随机抽取单个设计的成功概率远低于此。需要注意,设计管线不仅依赖 BoltzGen 模型本身,还依赖 BoltzIF 逆折叠、Boltz-2 重折叠验证和多项物理化学指标筛选——论文中的成功率是整个多阶段漏斗的结果。不同任务间的性能差异也很显著:蛋白和纳米抗体对蛋白靶标可达单位数纳摩尔,但 RagA:RagC 二硫键环肽约 80 μM,小分子结合物约 30-250 μM。”通用”意味着模型能尝试多种任务,并不代表每种任务都达到药物级性能。
作者发现了明确的训练数据记忆问题:设计 73-76 氨基酸长度的蛋白时,模型反复生成类似 ubiquitin 的序列(PDB 中出现超过 1,000 次),在长度 73 的测试中 156 个设计全部与 ubiquitin 序列相似度超过 97%,呈现严重的模式崩塌。此外,选择性验证仍不充分——HSA 非特异性检测只是初步筛查,真正的治疗开发还需要系统检测同源蛋白交叉结合、蛋白组范围脱靶、血清稳定性、聚集倾向和免疫原性等。部分实验的证据强度也参差不齐:NPM1 实验主要依赖核仁共定位而非直接亲和力测量,GyrA 实验中部分肽可能通过膜破坏等非预期机制抑制细菌生长。论文作为 bioRxiv 预印本尚未经过同行评审,部分实验只有单次测量,独立复现和更严格的盲测仍然必要。
通讯作者介绍
Regina Barzilay,MIT 电气工程与计算机科学系教授、AI 与健康 Jameel Clinic 联合负责人,博士毕业于哥伦比亚大学,研究方向为机器学习在药物发现和分子设计中的应用,因对计算生物学和自然语言处理的贡献获得麦克阿瑟天才奖。Tommi Jaakkola 是 MIT 电气工程与计算机科学系 Thomas M. Siebel 讲席教授,CSAIL 与 IDSS 成员,在概率模型、机器学习及其分子应用方面做出多项开创性工作,他所在团队在扩散模型和随机过程上的工作是 Boltz 系列模型的理论基础之一。论文标注的通讯作者是第一作者 Hannes Stark(hstark@csail.mit.edu),Barzilay 与 Jaakkola 是本文的资深作者。本研究由 MIT 与 UCSF 等机构联合完成,38 位作者横跨计算与实验团队。
引用
Stark, H., Faltings, F., Choi, M., Xie, Y., Hur, E., O’Donnell, T., … & Jaakkola, T. (2025). BoltzGen: Toward Universal Binder Design. bioRxiv. https://doi.org/10.1101/2025.11.20.689494