
La-Proteina: Atomistic Protein Generation via Partially Latent Flow Matching
原文链接:全文
作者:Tomas Geffner, Kieran Didi, Zhonglin Cao, …, Arash Vahdat
arXiv,2026 年 5 月 27 日
导读
蛋白质设计最完整的形式是同时生成序列和全原子三维结构,但全原子生成面临离散序列与连续坐标混合、不同氨基酸侧链原子数不同、长蛋白内存爆炸等难题。这篇文章提出了 La-Proteina——一种基于”部分潜变量”表示和流匹配的全原子蛋白质生成模型:将 Cα 骨架坐标显式建模,同时将序列和侧链信息压缩为每个残基一个固定 8 维的连续潜变量,再用流匹配联合生成骨架与潜变量,最后由 VAE 解码器还原完整的全原子结构。La-Proteina 在全原子共设计率上达到 68.4%,是此前最佳方法的近两倍,且能生成长达 800 残基的共设计蛋白质,在原子级 motif scaffolding 任务上也大幅领先。
一、研究问题
理想的蛋白质设计工具应该同时输出氨基酸序列和精确到每个原子的三维结构——即对联合分布 p(序列, 全原子结构) 进行建模和采样。近年来涌现了大量蛋白质生成模型,如 RFDiffusion、Chroma、FrameFlow 等在骨架生成上表现出色,但它们大多只生成骨架,需要后续用 ProteinMPNN 设计序列再用 AlphaFold 预测完整结构。在功能位点设计(如酶活性中心、金属配位位点)中,需要精确控制特定侧链原子在三维空间中的位置和朝向,这种分阶段策略难以保证原子级精度,且各阶段的误差会累积。
直接联合生成序列和全原子结构面临三大障碍。第一,序列是离散类别变量(20 种氨基酸),原子坐标是连续变量,模型需要在同一个框架内同时处理离散和连续空间——纯扩散或纯流匹配天然适合连续空间,加入离散变量需要额外的建模策略。第二,不同氨基酸的侧链原子数差异极大:甘氨酸几乎没有侧链,丙氨酸只有一个甲基碳,而色氨酸有含 9 个重原子的吲哚双环结构。论文采用 Atom37 表示(每个残基统一用 37 个潜在原子槽位),但有效原子数从 4 到 14 不等,导致每个位置的有效输出维度依赖于序列本身,形成循环依赖。第三,如果把每个原子都作为独立的生成对象,一个 500 残基的蛋白质涉及约 4,000 个重原子、12,000 个坐标维度,内存和计算开销急剧增长。论文指出,现有全原子模型如 P(all-atom)、PLAID 等在蛋白质长度超过约 500 残基时往往崩溃——共设计率降至 0%、出现显存溢出、或根本无法产生结构合理的样本。
二、方法核心:部分潜变量表示
La-Proteina 的核心设计选择是将蛋白质信息拆分为两部分:Cα 骨架坐标显式保留,序列和侧链信息压缩为固定维度的连续潜变量。对于长度为 L 的蛋白质,模型实际操作的数据是 Cα 坐标(L × 3 维)加上每个残基的 8 维潜变量(L × 8 维),组成一个统一的连续空间,避免了直接处理离散序列和可变长度侧链的困难。
显式保留 Cα 坐标有四个关键优势:一是可以直接继承成熟的骨架生成架构(如 RFDiffusion、FrameFlow 等已经在骨架生成上表现出色的扩散/流模型);二是保持大尺度几何信息不丢失,不需要从低维潜变量中恢复整个全局形状;三是允许骨架和侧链使用不同的生成速度——实验表明”骨架先快速成形、侧链细节随后补全”是最优策略;四是每个残基仅增加 8 维潜变量,内部序列长度仍然与残基数成正比,保证了对长蛋白的可扩展性。消融实验明确支持这一设计:显式建模 Cα 时全原子共设计率约 82.4%,将 Cα 也编码进潜空间后骤降至 21.2%。
模型由三个网络组成。编码器将完整的全原子蛋白质映射为每个残基的 8 维高斯潜变量:输入特征包括 Atom37 原子坐标、相对 Cα 坐标、氨基酸类型、侧链二面角、骨架二面角以及残基间距离和方向等成对特征。解码器从 Cα 坐标和潜变量重建序列(通过逐残基 20 类 categorical 分布,取 argmax 得到氨基酸类型)和非 Cα 原子坐标(通过固定单位方差的高斯分布,取均值得到原子位置)。联合去噪器(Joint Denoiser)通过流匹配学习从高斯噪声生成 Cα 骨架和潜变量的联合分布。
训练分两阶段。第一阶段训练 VAE(编码器 + 解码器),优化带权重的 ELBO(证据下界)目标:重建损失包括序列交叉熵和原子坐标均方误差,KL 散度正则化权重 β 设为极小的 10⁻⁴,使模型高度重视精确重建。在测试集上实现了平均全原子 RMSD 仅 0.12 Å 和序列恢复率 100% 的重建精度,证明每个残基仅 8 维的潜变量足以无损编码 20 种氨基酸类型和侧链构象。第二阶段冻结 VAE 的编码器和解码器,训练流匹配模型学习真实蛋白质数据对应的 (Cα, z) 联合分布。关键创新是使用独立的双时间变量:Cα 和潜变量分别有各自的去噪时间 t_x 和 t_z,Cα 采用指数调度(更快接近成品),潜变量采用二次调度(较慢补全),训练时通过 Beta(1.9, 1) 和 Beta(1, 1.5) 分布采样时间,使骨架去噪进度系统性领先于侧链细节。消融实验证实,超过 50% 共设计率的配置几乎都满足”Cα 使用更快调度、潜变量使用较慢调度”的模式——”先骨架后细节”是性能的关键经验结论。
生成时从标准高斯噪声出发,用随机微分方程(SDE)进行 400 步数值积分。采样噪声强度 η 控制质量与多样性的权衡:η = 0.1 时共设计率最高(68.4%),η 增大后共设计率下降但氨基酸频率分布更接近 UniProt 天然分布。最终的 Cα 坐标和潜变量通过冻结的解码器还原为完整的全原子蛋白质——序列取分类 logits 的 argmax,非 Cα 坐标取高斯解码分布的均值。网络使用 pair-biased attention 的 Transformer 架构,编码器和解码器各约 130M 参数,流去噪器约 160M 参数。训练在 AlphaFold 数据库(AFDB)的 Foldseek 聚类代表子集上进行,约 4,700 万条蛋白质结构-序列对。
三、看图说话
Figure 1 · 编码器、解码器与联合去噪器
这张图想回答:La-Proteina 怎样把蛋白信息拆成骨架坐标和连续潜变量两部分来生成?
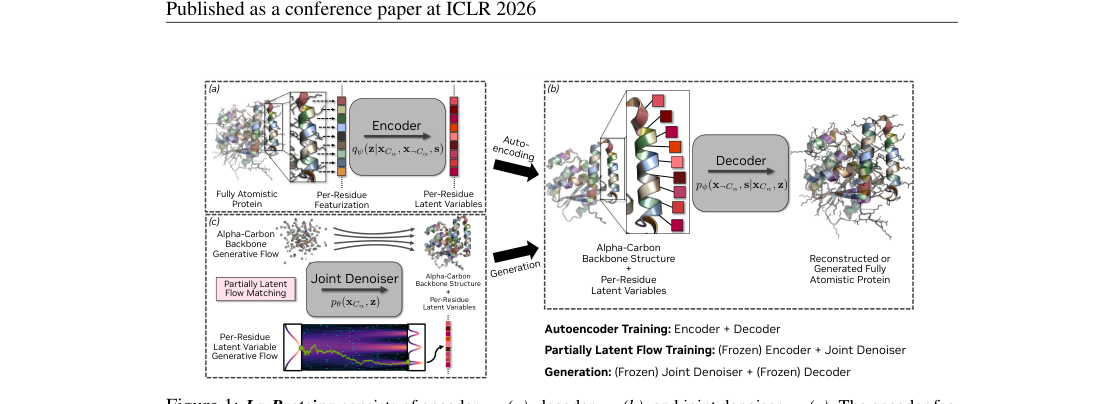
Figure 1. La-Proteina 由编码器 qψ (a)、解码器 pϕ (b) 和联合去噪器 pθ (c) 组成。编码器把全原子蛋白压成每残基的潜变量,去噪器用流匹配联合生成 Cα 与潜变量,解码器再还原全原子结构。
核心表示:Cα 骨架坐标(L×3)显式保留,序列和侧链压成每残基 8 维连续潜变量(L×8),拼成一个统一连续空间,绕开了直接处理离散序列和可变长度侧链的难题。
显式保留 Cα 有四个好处:直接继承成熟骨架架构、不丢全局形状、骨架和侧链能用不同去噪速度、每残基只多 8 维保证长蛋白可扩展。消融证据很硬:显式建模 Cα 时共设计率约 82.4%,把 Cα 也编码进潜空间后骤降到 21.2%。
Figure 2 · 全原子生成样本
这张图想回答:模型直接生成的全原子蛋白长什么样,质量如何?
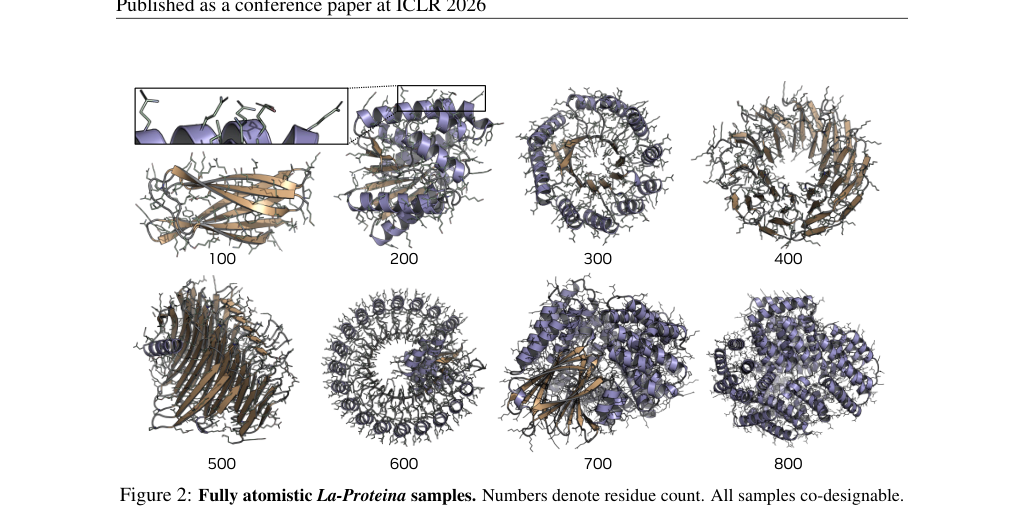
Figure 2. La-Proteina 生成的全原子样本,数字为残基数,所有样本均可共设计。
这些是模型一次性输出的完整全原子结构(骨架 + 侧链 + 序列),覆盖从小到大的不同残基数,全部通过共设计检验。直观展示了「序列和全原子结构联合生成」而非先出骨架再补序列的效果。
Figure 3 · 原子级 motif scaffolding 示例
这张图想回答:给定一个功能位点的原子坐标,模型能否生成包裹它的多样 scaffold?
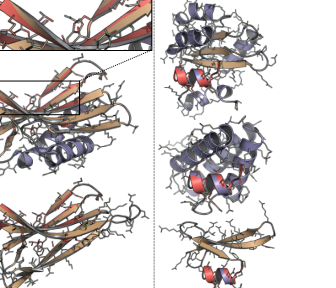
Figure 3. 原子级 motif scaffolding。La-Proteina 准确重建原子级 motif(红),同时生成多样的 scaffold。
红色是给定的功能 motif(原子坐标固定),其余是模型生成、包裹该 motif 的不同蛋白骨架。motif 被原子级精确重建、scaffold 各不相同——这正是酶设计需要的能力:催化三联体等功能位点依赖特定侧链原子的精确排列,只给骨架级条件保证不了原子级精度。
Figure 4 · 无条件生成的共设计率
这张图想回答:无条件全原子生成上,La-Proteina 的共设计率比现有方法高多少?
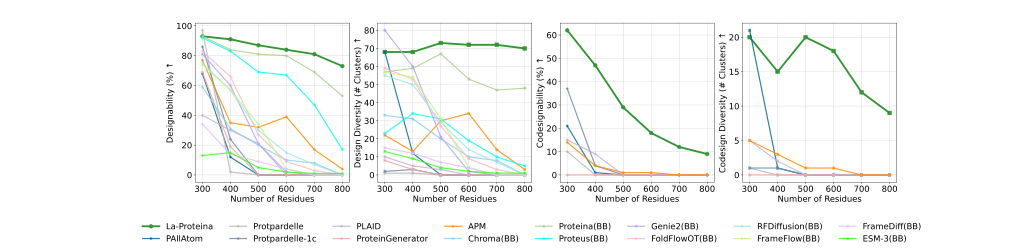
Figure 4. 无条件长度生成表现。随残基数变化的 designability、diversity、co-designability 等指标,La-Proteina(绿)对比十余种基线。
绿色的 La-Proteina 在各长度上都明显高于其它方法。全原子共设计率 68.4%,是此前最佳(P(all-atom) 36.7%)的近两倍(加三角乘法层的 tri 版本到 75.0%,但更吃显存)。更关键的是长蛋白:其它全原子基线在 500 残基附近共设计率就掉到 0%、甚至显存溢出,而 La-Proteina 到 800 残基仍保持约 80% 骨架 designability、近 60% 全原子共设计率。
Figure 5 · 结构的化学合理性
这张图想回答:生成的结构在键长键角、碰撞、离群值等化学指标上干净吗?
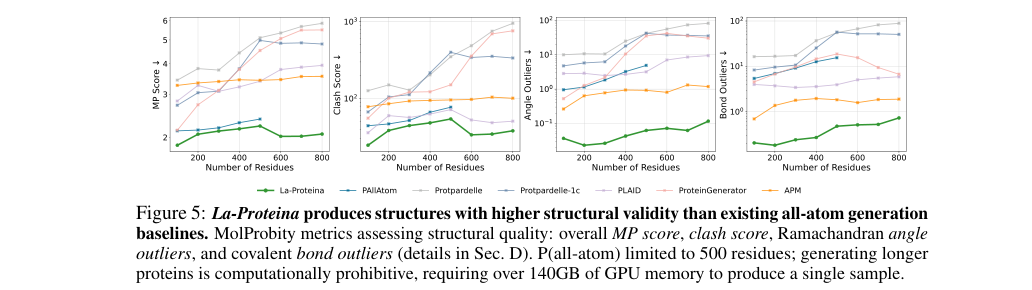
Figure 5. La-Proteina 的结构有效性高于现有全原子基线。MolProbity 指标:MP score、clash score、Ramachandran angle outliers、covalent bond outliers(越低越好)。
四张图分别是整体 MP score、原子碰撞、Ramachandran 角度离群、共价键离群,纵轴越低越好。绿色的 La-Proteina 在四项上都压在最低,说明生成结构更符合真实蛋白的化学约束,而不是只看着像、细节违例。注意图注也点明:全原子打分受算力限制只做到 500 残基,更长的生成一个样本就要 140 GB 以上显存。
Figure 6 · 侧链 rotamer 分布还原
这张图想回答:模型能不能还原真实蛋白里侧链二面角的多个稳定态分布?
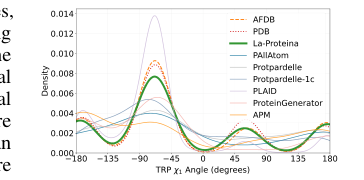
Figure 6. 色氨酸 χ₁ 二面角分布。对比 AFDB、PDB 参考与 La-Proteina 及各基线。
以色氨酸 χ₁ 为例,真实蛋白(AFDB/PDB)在 −60°、60°、180° 有三个主要稳定态。La-Proteina(绿)准确还原了这三个峰的位置和相对高度,而部分基线会漏掉某个 rotamer 或频率严重偏离——意味着它们覆盖不了真实的侧链构象空间。附录对几乎所有有侧链二面角的氨基酸都做了同样分析,结论一致。
Figure 7 · 26 个 motif scaffolding 任务的成绩
这张图想回答:在严格的原子级 motif scaffolding 基准上,La-Proteina 比对手强多少?
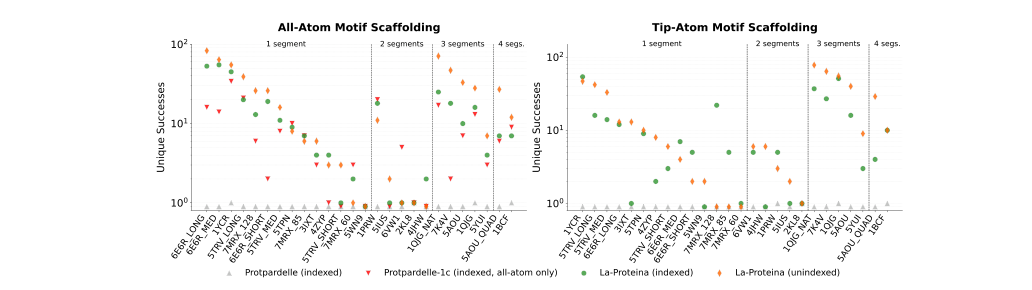
Figure 7. 26 个原子级 motif scaffolding 任务(x 轴),左为 all-atom、右为 tip-atom 设定,对比 Protpardelle、Protpardelle-1c 与 La-Proteina(indexed / unindexed)。
两个设定:all-atom 给 motif 全部原子,tip-atom 只给侧链末端功能原子(模型还要自己推整条侧链和骨架位置),后者更难。成功标准很严(motif 序列全恢复、Cα RMSD 小)。绿色/橙色的 La-Proteina 的 unique successes 在绝大多数任务上都高于 Protpardelle 系列(灰色三角几乎贴地),indexed 与 unindexed 都明显领先。
Figure 8 · 潜空间的化学意义
这张图想回答:那 8 维潜变量到底学到了什么?它是局部的还是全局耦合的?
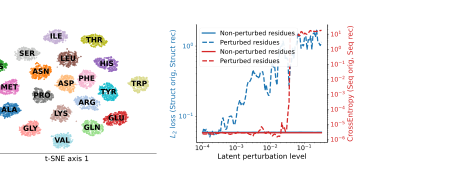
Figure 8. 潜空间分析。左:潜变量的 t-SNE。右:对潜变量做扰动的局部性分析(结构与序列重建误差随扰动强度变化)。
左 t-SNE:20 种氨基酸在 8 维潜空间里形成清晰聚类,且化学相似的靠在一起(Phe/Tyr/Trp 芳香族一簇,Gln/Glu、Asn/Asp 各自相邻)——说明潜空间距离约等于残基的化学相似度。右扰动分析:改一个残基的潜变量只显著影响该残基的重建、几乎不动其它残基——尽管用的是全局注意力,模型却自动学出了按残基对齐的局部表示,因此天然适合局部编辑和功能位点设计。
四、核心贡献总结
作者在长度 100、200、300、400、500 残基上各生成 100 个蛋白质,系统评估无条件全原子生成能力。核心指标是全原子共设计率:让 ESMFold 折叠模型生成的序列,如果预测结构与模型直接生成的全原子结构的 RMSD 小于 2 Å,则视为共设计成功。与 P(all-atom)(36.7%)、Protpardelle-1c(35.8%)、APM(19.0%)、PLAID(11.0%)、ProteinGenerator(9.8%)和 Protpardelle(8.8%)等六种公开可用的全原子生成基线对比,La-Proteina 的全原子共设计率达到 68.4%,是此前最佳方法的近两倍。加入三角乘法更新层(类似 AlphaFold2 Evoformer 中的 triangular multiplicative update)的 La-Proteina tri 版本进一步提升至 75.0%,但计算和显存开销更高,主要局限于短蛋白。La-Proteina 在共设计样本的 pLDDT(72.2)、ProteinMPNN-8 designability(93.8%)和 ProteinMPNN-1 designability(82.6%)等指标上也均表现出色,且在结构和序列的联合多样性上维持了 301 个独立聚类。
尤其值得关注的是长蛋白生成能力。作者额外在 AFDB 上训练了长蛋白版本(样本长度可达 896 残基),在 300–800 残基的长度范围内与包括纯骨架模型在内的 12 种方法对比。所有全原子基线在 500 残基附近已基本崩溃(共设计率降至 0%),部分模型甚至因显存溢出无法生成样本。相比之下,La-Proteina 在 800 残基时仍保持约 80% 的骨架 designability 和近 60% 的全原子共设计率,同时维持约 20 个独立聚类的结构多样性。即便与纯骨架模型(如 RFDiffusion、FrameFlow、Genie2 等在骨架 designability 上强劲的方法)相比,La-Proteina 的骨架质量也毫不逊色,同时还额外提供了序列和全原子结构——这证明部分潜变量框架没有为全原子能力牺牲骨架质量。这一可扩展性源于”部分潜变量”表示的效率——每个残基仅增加 8 维潜变量,内部序列长度始终与残基数 L 成正比。
生物物理质量分析进一步证实了生成结构的化学合理性。使用 MolProbity 工具评估键长、键角、Ramachandran 离群值和共价键离群值等指标,La-Proteina 在所有维度上均优于全原子基线。侧链 rotamer 分布的定量验证尤为重要:以色氨酸 χ₁ 二面角为例,La-Proteina 准确还原了 PDB 和 AFDB 参考数据中 −60°、60° 和 180° 三个主要稳定态的位置和相对频率。对比之下,部分基线会遗漏某些 rotamer 模式或频率分布严重偏离,意味着它们无法覆盖真实蛋白质中的全部侧链构象空间。论文附录对几乎所有具有侧链二面角的氨基酸做了类似分析,La-Proteina 在各氨基酸上均表现一致。
原子级 motif scaffolding
La-Proteina 的全原子能力使其可以完成原子级的条件设计——给定功能位点(motif)的原子坐标,生成包裹该 motif 的完整蛋白质 scaffold。这类任务在酶设计中尤为关键:催化位点的功能往往取决于特定侧链原子的精确空间排列(如催化三联体中的丝氨酸羟基、组氨酸咪唑环和天冬氨酸羧基),仅靠骨架级条件无法保证这种原子级精度。
作者在 26 个 motif scaffolding 任务上评估了四种设置:all-atom(给定 motif 残基的全部主链和侧链原子坐标及氨基酸类型)、tip-atom(只给侧链末端的功能性原子,如催化氮、配位金属的原子,模型还需推断整条侧链的构象和骨架位置)、indexed(预先指定 motif 残基在新蛋白质序列中的位置)和 unindexed(位置也由模型自行决定)。成功标准非常严格:motif 序列必须完全恢复、motif Cα RMSD < 1 Å、motif 全原子 RMSD < 2 Å、且整个蛋白质满足全原子共设计。La-Proteina 在四种设置下均大幅领先 Protpardelle 基线,能成功解决 26 个任务中的 21–25 个(Protpardelle 仅约 4 个),且在每个任务上产生更多结构独特的成功 scaffold。一个有趣的发现是,对于由三或四段不连续序列组成的复杂 motif,unindexed 模式反而优于 indexed——indexed 设置固定了 motif 片段之间的序列间隔和在链上的绝对位置,可能过度限制了 scaffold 的拓扑选择空间,使得环区长度和整体折叠难以最优化。
潜空间分析揭示了模型有效性的结构性来源。t-SNE 可视化显示 20 种氨基酸在 8 维潜空间中形成清晰聚类,且化学性质相似的氨基酸彼此靠近:Phe、Tyr、Trp 三种芳香族氨基酸聚在一起,Gln/Glu 和 Asn/Asp 这两对侧链骨架相似但末端基团不同的氨基酸也各自相邻。这说明潜变量学到的连续表示具有化学意义上的距离关系,可以理解为”潜空间距离约等于残基在结构和化学上的相似程度”。局部扰动实验进一步表明,改变单个残基的潜变量只显著影响该残基的重建误差,对链上其他残基几乎无影响——尽管编码器和解码器使用了全局注意力的 Transformer,模型仍自动学习出了按残基对齐的局部性表示。这种局部性使 La-Proteina 天然适合局部编辑和功能位点设计:保持整体骨架不变、仅修改特定位点的序列和侧链构象。
五、局限与展望
几个需要留意的点。算力与显存:精度更高的 tri 版本(加三角乘法层)计算和显存开销大,基本只能用于短蛋白;全原子 MolProbity 评估也因算力限制只做到 500 残基,更长的生成一个样本就要 140 GB 以上显存。
质量与多样性的权衡:采样噪声强度 η 要折中——η = 0.1 时共设计率最高(68.4%),η 增大后共设计率下降、但氨基酸频率更接近天然分布。此外所有评估都是计算验证(ESMFold 共设计、MolProbity、t-SNE 等),尚无湿实验确认生成蛋白能真实表达、折叠和具备功能。
尽管如此,「部分潜变量」这一表示——把骨架显式保留、把序列和侧链压成每残基几维连续潜变量——为全原子生成同时解决了离散/连续混合、可变侧链和长蛋白可扩展三个难题,是很有借鉴意义的框架。后续工作(Didi 等 2026)已把它用到结合物设计上。
通讯作者介绍
Karsten Kreis,NVIDIA Research 高级研究科学家,主要研究方向为深度生成模型及其在科学领域的应用。Kreis 本科和硕士毕业于德国亚琛工业大学物理系,在加拿大滑铁卢大学获得统计物理方向的博士学位,研究液晶和软物质系统的计算模拟,随后在多伦多大学与机器学习领域知名学者合作从事博士后研究,后加入 NVIDIA Research。他在能量模型、评分匹配、去噪扩散模型和流匹配等生成模型方向有广泛的方法论贡献,代表性工作包括改进 score-based 模型的训练稳定性和采样效率。近年来 Kreis 将研究重心转向科学领域,将这些生成模型框架应用于蛋白质从头设计和分子生成等关键问题。Arash Vahdat 为共同通讯作者,同为 NVIDIA Research 的资深研究科学家和研究总监,在变分自编码器(VAE)和扩散模型领域发表了大量有影响力的工作。第一作者 Tomas Geffner 来自 NVIDIA,共同第一作者 Kieran Didi 的署名单位为 NVIDIA 与牛津大学,团队成员还包括来自 NVIDIA、Mila(魁北克人工智能研究所)和蒙特利尔大学的多位研究者。论文代码已在GitHub开源(github.com/NVIDIA-Digital-Bio/la-proteina),便于研究者复现和扩展。Didi等人(2026)已将La-Proteina进一步应用于蛋白质结合物从头设计,证明了该框架在实际蛋白质工程场景中的应用潜力。
引用
Geffner, T., Didi, K., Cao, Z., Reidenbach, D., Zhang, Z., Dallago, C., … & Vahdat, A. (2026). La-Proteina: Atomistic Protein Generation via Partially Latent Flow Matching. arXiv. https://doi.org/10.48550/arXiv.2507.09466