
Comprehensive evaluation of artificial intelligence-empowered approaches for protein–aptamer complex prediction
原文链接:全文
作者:Jiani Zhao, Kha Tram, Hongbin Yan, Yifeng Li
Briefings in Bioinformatics,2026 年 5 月 1 日
导读
适配体(aptamer)是长度约 15–100 nt 的单链 DNA 或 RNA,因其高亲和力、高特异性和低免疫原性而被视为极具潜力的核酸药物。然而,当 AlphaFold3、Chai-1、Boltz-2 和 RF2NA 四大 AI 结构预测模型被系统应用于 11 个蛋白质–适配体复合物时,一个令人警惕的现象浮出水面:将蛋白质与完全不相关的适配体配对,甚至将适配体序列随机打乱后,模型仍然能够生成在分子动力学模拟中稳定存在、结合能有利、氢键持续的”复合物”。换言之,这些模型已经擅长回答”如何把两条链拼成一个看起来合理的复合物”,但尚无法回答”这两个分子是否真正存在特异性结合”。
一、研究问题
近年来,AI 驱动的蛋白质结构预测取得了突破性进展,从 AlphaFold2 到 AlphaFold3、Chai-1 和 Boltz-2,模型已能够处理蛋白质、核酸、小分子和离子的多类型复合物。但在蛋白质–适配体体系中,这些模型面临独特挑战。适配体是通过 SELEX(指数级富集配体的系统进化)筛选出的功能性核酸,能折叠成特定三维结构并以纳摩尔级亲和力结合靶蛋白,因此常被称为”核酸版抗体”。然而,公开的蛋白质–适配体复合物结构极其稀少(远少于蛋白质–蛋白质或蛋白质–配体),适配体本身高度柔性,游离态和结合态构象差异巨大,G-四链体等特殊二级结构依赖 K⁺、Mg²⁺ 等离子的精确配位。更根本的问题在于:结构预测模型的训练目标是”给定这些链,把它们组装成合理的复合物”,而适配体药物设计真正需要的能力是判断”这个特定适配体序列是否会与这个特定蛋白特异性结合”——这是截然不同的两个问题。
本文作者构建了迄今最系统的蛋白质–适配体结构预测基准。他们从 PDB 中收集了 11 个实验解析的蛋白质–适配体复合物(均为 2021 年 9 月 30 日之前解析,以尽量避免 AF3、Chai-1 和 RF2NA 在训练中直接见过测试结构),涵盖 HIV-1 逆转录酶–DNA 适配体、人凝血酶–DNA 适配体(包括 G-四链体构象)、SARS-CoV-2 核衣壳蛋白–DNA 适配体、转铁蛋白受体和纳米抗体等多种靶蛋白。为了严格检验模型是否学会了序列特异性识别,作者精心设计了两类负对照。
二、方法核心:基准设计:正样本、错配和序列打乱
基准测试评估了四种深度学习模型和一种模板方法。AlphaFold3(AF3)通过扩散模型统一预测蛋白质、核酸、配体和离子。Chai-1 在 AF3 架构基础上引入了蛋白质语言模型表示并支持接触约束。Boltz-2 支持结构可控生成和亲和力预测模块。RoseTTAFold2NA(RF2NA)是专门针对蛋白质–核酸体系设计的模型,采用刚体框架和扭转角建模。3dRNA/DNA 则是一种模板组装方法,将核酸拆分成二级结构单元再利用已知模板拼接三维结构。对于前四种深度学习模型,每个蛋白质–适配体组合生成 25 个预测结构(5 个随机种子 × 5 个扩散样本;RF2NA 为 25 次独立预测),选取置信度最高的两个结构进行 20 ns 全原子分子动力学(MD)模拟,评估结构稳定性和界面质量。
(A)以 iLDDT(界面局部距离差异测试)衡量预测界面的几何准确性,Boltz-2 总体表现最优(All 组,见图 2A),AF3 略低于 Boltz-2,Chai-1 居第三(79.9),RF2NA 较弱(0.7)。但一个关键背景是:11 个测试复合物中有 6 个可能出现在 Boltz-2 的训练集内(训练数据截止 2023 年 6 月 1 日)。当只看训练集中未出现的 5 个复合物(D2 子集)时,所有模型的 iLDDT 均显著下降——Boltz-2 从 92.1 降至 36.6,AF3 从 51.6 降至 74.8(D2 中 AF3 反超 Boltz-2),说明模型对未见过的蛋白质–适配体复合物的泛化能力仍然有限。(B)热力图进一步展示了每个模型在每个复合物上的 iLDDT 中位数,8TFD、8ZBF 和 9GXH 等复合物对所有模型都构成挑战。
负对照的设计是本研究最重要的实验策略。错配负样本:将每个蛋白质与另一个复合物的适配体配对(例如将 HIV-1 逆转录酶与凝血酶适配体配对),同时避免将适配体重新配给同源蛋白,确保负样本确实是功能上不相关的组合。序列打乱对照(仅限 AF3):保持适配体长度和碱基组成(A、T、G、C 总比例)不变,随机打乱核苷酸顺序,要求至少 80% 的位置与原始序列不同。如果模型确实学到了碱基排列和结合基序的信息,打乱序列产生的预测结构应当在结合能、口袋占有率和界面氢键等指标上显著劣于天然序列。
三、看图说话
Figure 1 · 结合自由能的相关性
这张图想回答:模型预测结构算出的结合自由能与实验值相关吗?正样本和负样本能区分开吗?
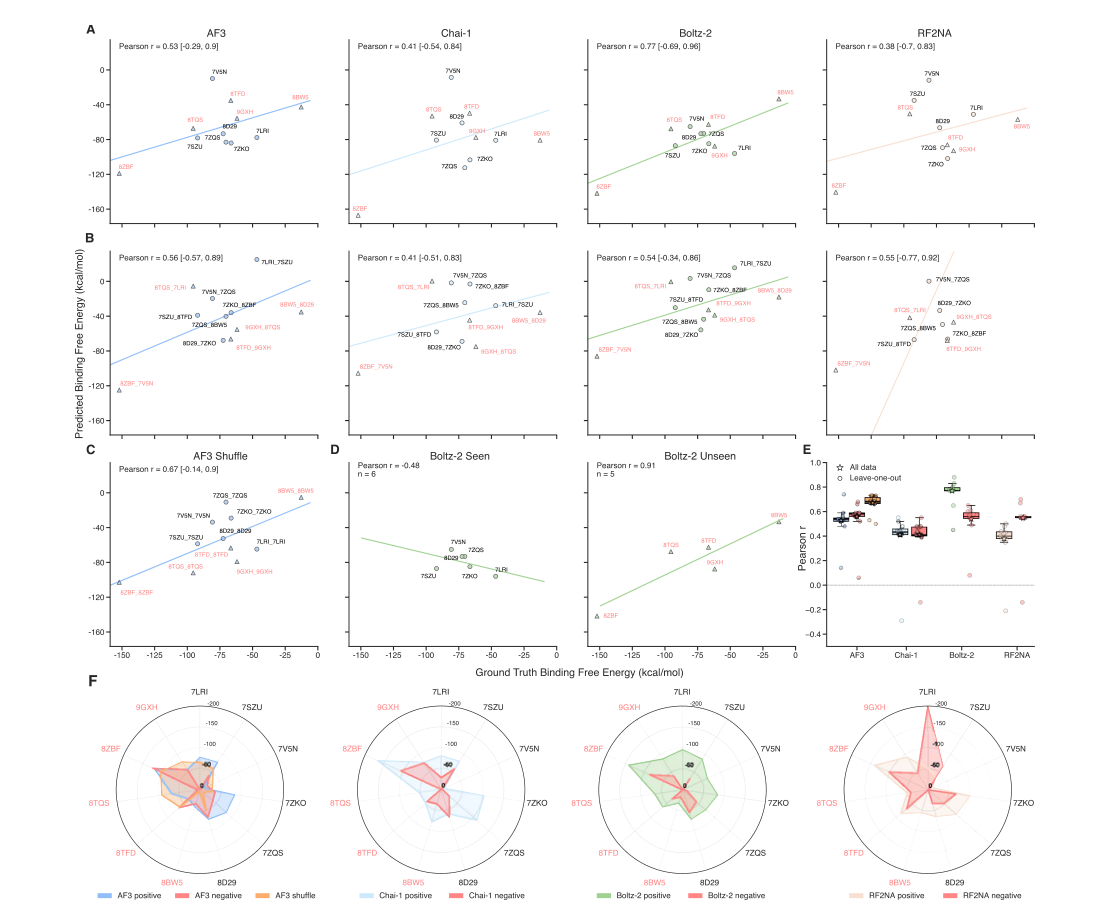
Figure 1. 预测结构与实验结构的 ΔG_bind 相关性。(A) 正样本、(B) 错配负样本、(C) AF3 打乱序列对照,横轴为实验结构的 ΔG_bind。(D) Boltz-2 按训练集内外拆分。(E) 留一法稳定性。(F) 雷达图。
- Panel A:正样本里 Boltz-2 的 Pearson r = 0.77、AF3 0.53、Chai-1 0.41、RF2NA 0.38,表面看模型抓到了结合强弱的趋势。
- Panel B、C 是关键反证:把蛋白和不相关适配体错配后,相关系数几乎不降(AF3 0.56→0.54);AF3 把序列完全打乱后 r 反而升到 0.67,比天然序列还高。这说明相关性多半来自蛋白大小、适配体长度、表面电荷这些整体理化量,而非真正的序列特异性识别。
- Panel D–F:Boltz-2 训练集内 6 个复合物呈负相关(−0.48)、训练集外 5 个高达 0.91,说明相关性对样本组成极敏感;留一法下各模型 r 波动剧烈(样本仅 11 个),雷达图进一步显示能量分不开真假配对。
Figure 2 · 界面几何精度 iLDDT
这张图想回答:四个模型预测的界面几何有多准?在没见过的复合物上还成立吗?
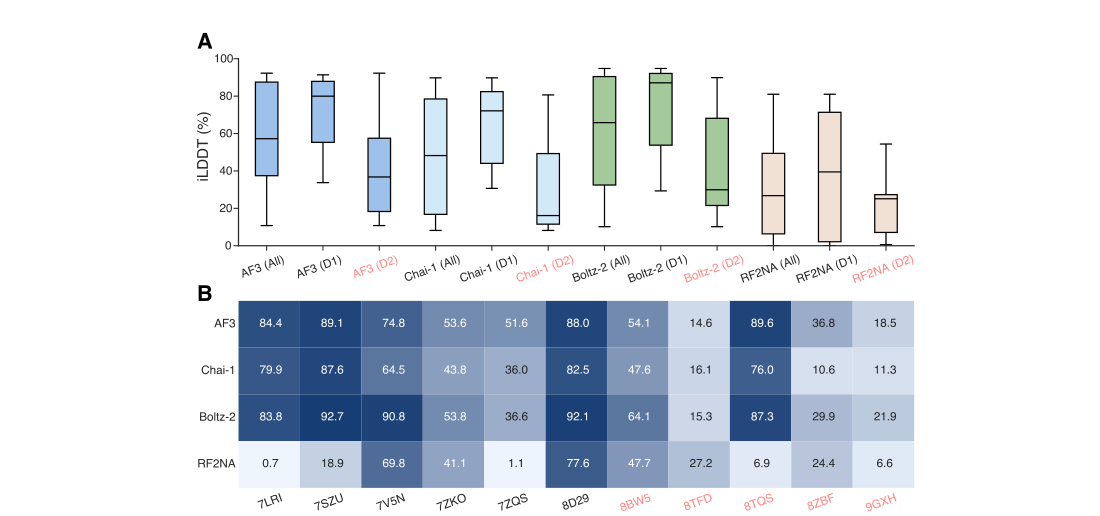
Figure 2. 预测界面的 iLDDT。(A) 各模型在全部复合物上的 iLDDT 分布。(B) 每个模型在每个复合物上的 iLDDT 中位数热图。
- Panel A:全体上 Boltz-2 中位 iLDDT 83.8、AF3 84.4、Chai-1 79.9,RF2NA 很弱。但 11 个复合物里 有 6 个可能在 Boltz-2 训练集内;只看训练集外的 5 个(D2 子集)时所有模型都大跌,Boltz-2 从 92.1 掉到 36.6,此时 AF3 反超——对未见过的复合物泛化仍有限。
- Panel B:逐复合物热图显示 8TFD、8ZBF、9GXH 等对所有模型都是难题。
Figure 3 · 界面氢键:数量对了,位置未必对
这张图想回答:模型能恢复多少真实界面氢键?精确率和召回率差多少?
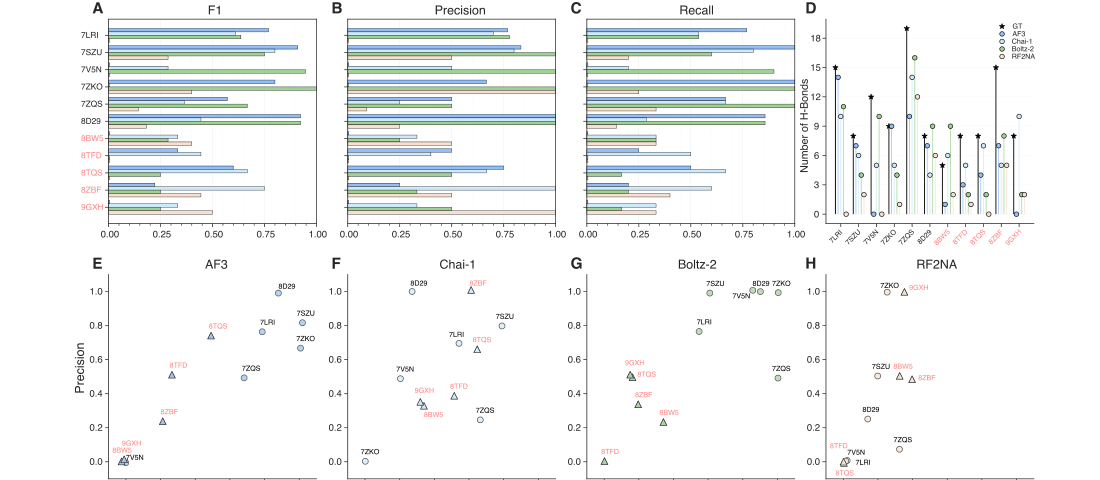
Figure 3. 界面氢键分析。(A–C) F1、精确率、召回率。(D) 氢键总数对比。(E–H) 各模型逐复合物的精确率散点。
- Panel A–C:AF3、Chai-1、Boltz-2 在部分复合物(7SZU、7V5N、7ZKO)上能恢复较多真实氢键,但体系间差异悬殊,RF2NA 普遍偏低。Panel D:实验结构每个复合物有 3–18 个界面氢键,总数接近不等于身份正确——预测的 10 个氢键里可能只有 5 个与实验重合,另 5 个是模型「发明」的。
- Panel E–H:逐复合物精确率波动极大,如 AF3 在 8D29 接近 1.0、在 8ZBF 仅约 0.25、8BW5 几乎为零;Boltz-2 训练集外的 8TFD 精确率近零。成功高度集中在特定组合上,缺乏跨体系泛化。
Figure 4 · MD 中的氢键与回转半径
这张图想回答:20 ns 模拟里,预测复合物的界面氢键和整体尺寸稳不稳定?
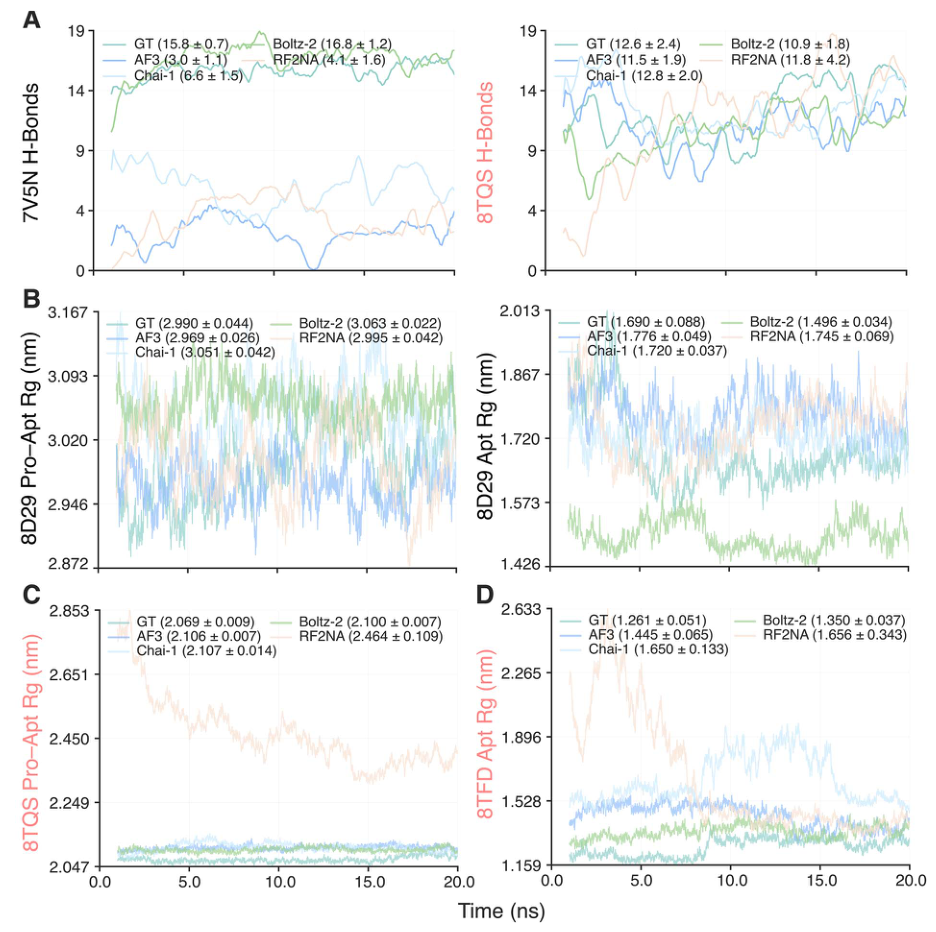
Figure 4. 20 ns MD 中的氢键与回转半径(Rg)曲线(从 1 ns 起算以排除初始平衡)。(A) 7V5N、8TQS 的界面氢键曲线。(B–D) 8D29、8TQS、8TFD 的 Rg 曲线,括号内为均值±标准差。
每条曲线是一种模型在整条轨迹上的表现。Panel A 的界面氢键数在整段模拟里保持平稳,Panel B–D 的 Rg 也基本是平直的水平线,说明预测复合物在 MD 里不会散架、尺寸稳定。问题恰恰在这里:连错配和打乱序列的组合都能生成这样稳定的「复合物」,所以 MD 稳定本身并不能证明结合真实。
Figure 5 · MD 中适配体的 RMSD
这张图想回答:模拟中适配体相对蛋白、以及单独模拟时漂移多大?正负样本有区别吗?
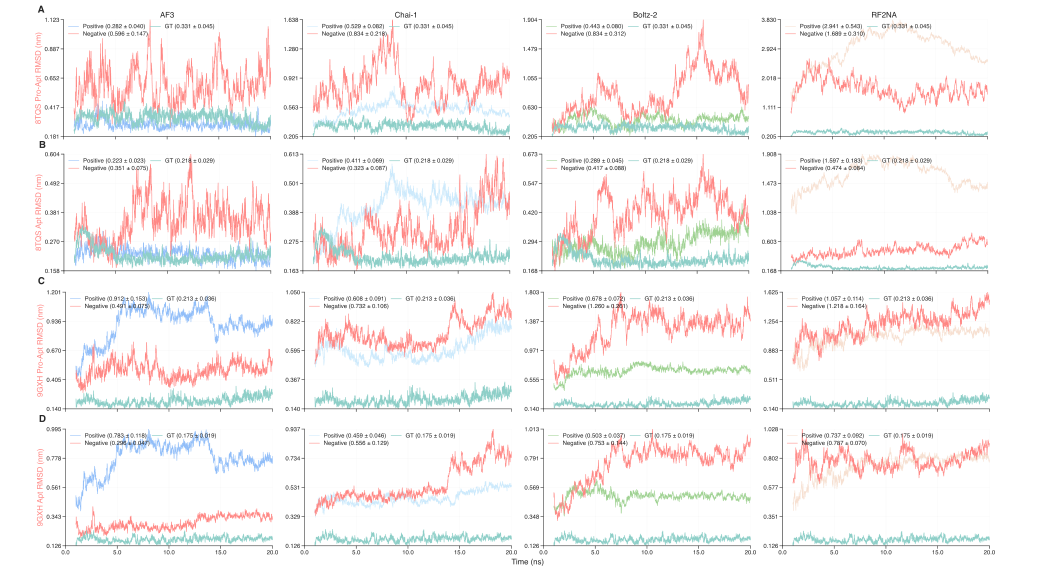
Figure 5. 20 ns MD 中适配体的 RMSD。(A, C) 适配体相对复合物内蛋白骨架的 RMSD。(B, D) 单独模拟适配体的 RMSD。曲线为 GT 与正样本预测,红色为错配负样本。
四列是四个模型。Panel A、C 看适配体相对蛋白骨架的 RMSD,Panel B、D 看把适配体单独拿出来模拟时的 RMSD。多数体系里 GT 和正样本(偏蓝/绿)RMSD 较低、较稳,红色的错配负样本漂移更大,但两者分布高度重叠,没有一个能把真假配对清晰分开的阈值。
Figure 6 · 代表性复合物的结构对比
这张图想回答:把四个模型的预测和实验结构摆在一起,适配体部分错在哪?
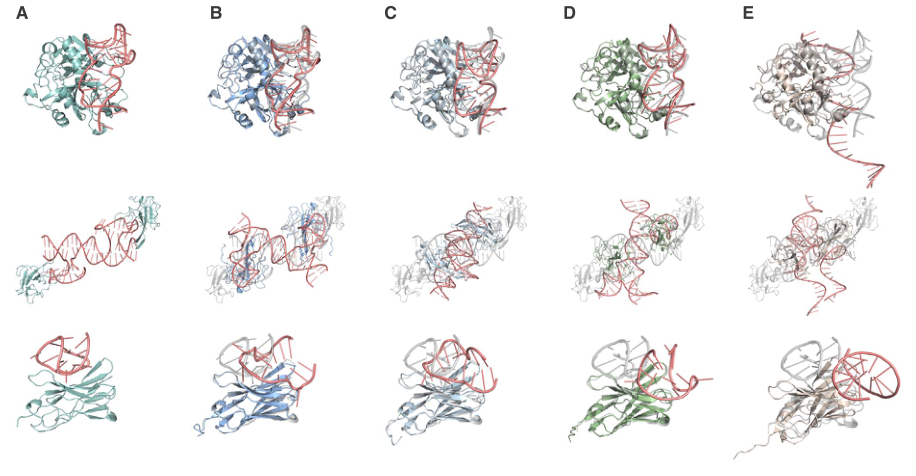
Figure 6. 代表性蛋白–适配体复合物(8TQS、8ZBF、9GXH)。每个复合物:(A) 实验参考,(B) AF3,(C) Chai-1,(D) Boltz-2,(E) RF2NA。
红色是适配体、彩色/灰色是蛋白。对比各列能直观看到:蛋白部分普遍预测得好,主要误差集中在适配体——折叠方向、在界面上的落点、G-四链体等特殊结构经常错位。适配体的高柔性和构象多样性是所有模型共同的难点。
Figure 7 · 单独预测适配体的表现
这张图想回答:脱离蛋白、单独预测适配体结构时,模型表现如何?
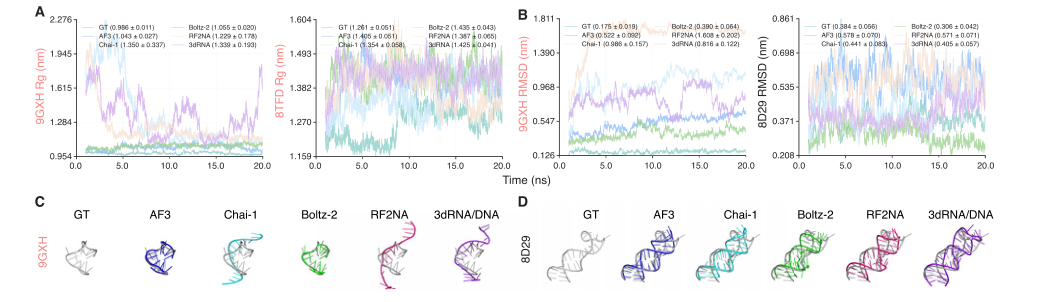
Figure 7. 单独适配体结构 20 ns MD 的 Rg、RMSD 及代表性结构。适配体序列取自实验复合物,用五个模型分别生成单独结构。
- Panel A、B 的 Rg/RMSD 曲线显示,离开蛋白后适配体构象更不稳定、模型间差异更大;Panel C、D 的代表结构(GT 与五个模型并排)可以看到各模型给出的单链折叠形态各异。这印证了问题根源在适配体本身的柔性,而不只是复合物界面。
Figure 8 · 模型自报的置信度可靠吗
这张图想回答:ipTM / iLDDT 这些置信度,能不能用来判断预测对不对?
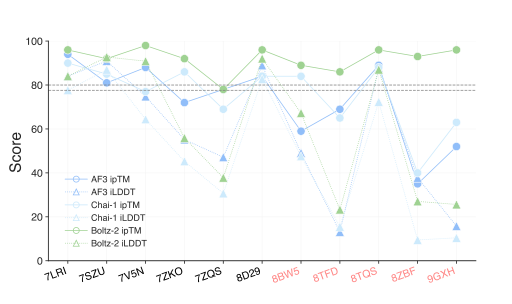
Figure 8. 各复合物预测结构的 ipTM 与 iLDDT(红色标签为训练集外复合物)。
横轴是各复合物,线条是不同模型的 ipTM 和 iLDDT。Boltz-2 对 8TFD、8ZBF、9GXH 这些界面其实偏差很大的预测仍给出很高 ipTM,明显过度自信;AF3、Chai-1 的 ipTM 与 iLDDT 整体更一致,但也不能单靠置信度判断对错。实际用模型筛适配体时,不能只看它自报的分数。
Figure 9 · 离子对结合能的影响
这张图想回答:显式加入离子后,正负样本的结合能关系会被区分开吗?
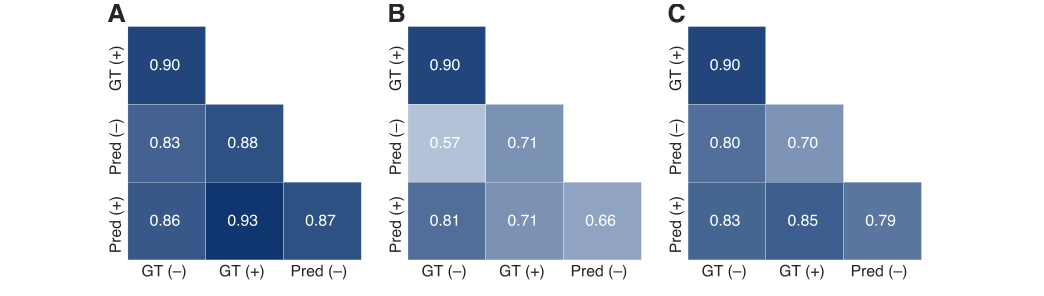
Figure 9. 九个复合物的 ΔG_bind 交叉相关。(A–C) 分别为 AF3、Chai-1、Boltz-2。「+」「−」表示有无离子,「Pred」为预测结构。
三张热图比较了 GT/预测结构在有无离子条件下 ΔG_bind 的两两相关。显式加入实验离子后,AF3、Chai-1 的 iLDDT 没有明显改善,Boltz-2 只有小幅提升,而且离子位置常常放错——放到实验位置的另一侧、异常聚集,Chai-1 有时甚至没把输入离子留在最终结构里。模型对离子介导的适配体折叠稳定化机制理解仍很有限。
四、核心贡献总结
本文最重要的结论可以分三个层次理解。第一层:AF3 和 Boltz-2 已经能够为部分蛋白质–适配体复合物生成几何上相当准确的界面结构,蛋白质部分通常比适配体部分更准确,主要误差来源集中在适配体的折叠方向、界面位置和 G-四链体等特殊结构的恢复上——适配体的高度柔性和构象多样性仍然是当前所有模型的核心难题。第二层:错配负样本和序列打乱对照在 20 ns MD 中同样表现出有利的结合能、持续的口袋占有率和稳定的氢键——模型能够为生物学上不应结合的组合生成”稳定的错误复合物”。作者定义口袋占有率为每帧中位于蛋白质结合界面 4.5 Å 以内的适配体原子占总数的比例,结果显示部分错配组合的口袋占有率甚至高于正样本,说明适配体停留在蛋白质表面可能只是反映了核酸与蛋白质之间的非特异性静电吸附。第三层:模型内部置信度(ipTM)同样不可靠——Boltz-2 对 8TFD、8ZBF 和 9GXH 等实际界面偏差很大的预测仍给出极高的 ipTM 值,存在明显的过度自信;AF3 和 Chai-1 的 ipTM 与 iLDDT 整体上更一致,但也不能单独作为预测正确性的判据。
五、局限与展望
测试集仅 11 个复合物,统计效力有限,Bootstrap 置信区间普遍较宽;MM/GBSA 未包含熵修正,且 MD 统一使用 NaCl 离子环境,未重现各体系特异性的 Mg²⁺ 或 K⁺ 条件;Boltz-2 的训练集重叠使其结果难以公平比较;20 ns 模拟时长可能不足以观察到错误结构的解离。此外,作者对 9 个含实验离子的复合物显式加入相应离子类型和数量后进行了附加测试:AF3 和 Chai-1 的 iLDDT 无显著改善,Boltz-2 仅有小幅但统计显著的提升,且离子位置预测经常不正确——有些离子被放在实验位置的另一侧,有些出现异常聚集,Chai-1 在个别体系中甚至没有将输入离子保留在最终结构中。当前模型对离子介导的适配体折叠稳定化机制的理解仍很有限。尽管如此,作者建议在实际使用 AI 模型筛选适配体时,必须同时纳入打乱序列和非靶蛋白的负对照,比较天然候选与负对照的相对表现,并检查具体界面接触(碱基–残基相互作用、盐桥和碱基堆叠),最终仍需通过 SPR、BLI、ITC 或竞争结合实验验证特异性。
通讯作者介绍
Yifeng Li,加拿大 Brock University 计算机科学系和生物科学系联合任职,研究方向为生物信息学与人工智能在核酸药物设计中的应用,长期关注深度学习方法在生物分子结构预测和药物发现中的系统基准测试与方法开发,研究团队横跨计算机科学、化学和生物科学三个学科。第一作者 Jiani Zhao 在 Brock University 计算机科学系完成数据集构建、多模型评估、分子动力学模拟和统计分析等核心工作。合作者 Kha Tram 来自加拿大生物技术公司 Cytodiagnostics Inc.,在适配体应用方面具有产业经验。Hongbin Yan 在 Brock University 化学系和生物科学系任职,提供了化学和结构生物学方面的学科支持。Brock University 位于加拿大安大略省圣凯瑟琳斯市(St. Catharines)。
引用
Zhao, J., Tram, K., Yan, H., & Li, Y. (2026). Comprehensive evaluation of artificial intelligence-empowered approaches for protein–aptamer complex prediction. Briefings in Bioinformatics, 27(3), bbag206. https://doi.org/10.1093/bib/bbag206