
Two Stages of Folding: Convergent Mechanisms in AI Protein Folding Trunks
原文链接:全文
作者:Kevin Lu, Jannik Brinkmann, Stefan Huber, …, Chris Wendler
arXiv,2026 年 6 月 24 日
这是「拆开蛋白折叠 AI 黑箱」系列的第三篇。前两篇我们分别聊了用稀疏自编码器分解蛋白语言模型的内部特征,以及 AlphaFold2 的行为分析。这一篇更进一步:直接打开 folding trunk,用因果干预的方法追问——模型究竟是怎么一步步把氨基酸序列变成三维结构的?
结论出人意料地统一:ESMFold、OpenFold、Boltz-1 三种架构的 folding trunk 都收敛到了相同的两阶段计算机制——前期把序列中的生化信息(尤其电荷)写入 pairwise representation,后期在 pairwise representation 中形成几何信息(距离/接触),驱动最终折叠。更关键的是,不同模型的 pairwise representation 可以线性对齐、甚至跨模型替换后仍然有效。
一、研究问题
过去几年,社区对 AlphaFold/ESMFold 这类模型的关注更多停留在“预测得准不准”。但这篇文章问的是一个更根本的问题:
这些模型内部到底做了什么计算,才把氨基酸序列变成三维结构?
具体来说,作者围绕三个子问题展开:
1)模型什么时候决定一个局部结构会变成 helix 还是 hairpin?也就是说,在 trunk 的第几层,结构命运被”定下来”?
2)这个决定依赖什么特征?是某些生化性质(如电荷),还是空间几何(如距离和接触图)?
3)不同模型内部用了相同的”逻辑”吗?ESMFold 用单序列语言模型,OpenFold/Boltz-1 用 MSA,它们的内部表示有没有共性?
为了让问题可操作,作者聚焦于两个最经典的二级结构决策——alpha helix 和 beta hairpin。它们足够简洁可解释,但 hairpin 需要序列上相距较远的残基协调形成接触,比纯局部决策更复杂,适合做因果分析。
二、方法核心:背景:Folding Trunk 的双轨结构
要理解这篇文章的核心发现,需要先搞清楚 folding trunk 内部的信息组织方式。以 ESMFold 为例,模型分三个模块:
(1)Sequence encoder(ESM-2 语言模型):把氨基酸序列编码成初始的 sequence representation s
(2)Folding trunk:48 个 block 迭代更新两条表示轨道
(3)Structure module:把最终表示解码成 3D 坐标
其中 folding trunk 维护的两条表示轨道是全文的主角:
Sequence representation s(k)
维度为 L × ds。对蛋白中每个残基 i,模型维护一个 ds 维向量 si(k),承载单残基级别的信息:氨基酸类型、局部序列上下文、化学属性等。类比 NLP 中 token 的 hidden state。
Pairwise representation z(k)
维度为 L × L × dz。对每一对残基 (i, j),模型维护一个 dz 维向量 zij(k),承载成对关系信息:两个残基是否接触、距离多远、有没有几何约束。如果说 s 是”节点特征”,z 就是”边特征”。
上标 (k) 表示经过第 k 个 trunk block 之后的状态。两条轨道通过两条跨表示通路相互作用:
seq2pair:s → z
从 sequence representation 构造 pairwise update。具体来说,对残基 i 和 j 的表示做线性投影得到 ui 和 vj,然后用逐元素乘积和差拼接:φij = [ui ⊙ vj ; ui − vj],再经 triangular update 和 attention 写入 z。直觉:用两个残基各自的状态组合成它们之间关系的候选特征。
pair2seq:z → s
pairwise representation 生成 attention bias,调制 sequence self-attention:Aij(h) = ⟨qi, kj⟩ / √dh + βij(zij)。直觉:如果 zij 表示两个残基在空间上很接近,那 sequence attention 就更倾向于让 i “看” j——pairwise 空间形成的几何关系反过来引导 sequence 计算。
作者的关键发现是:patch encoder 或 structure module 基本不影响结构决策,真正进行 folding computation 的地方是 trunk。这也是全文聚焦于 trunk 内部的原因。
三、看图说话
这篇文章最核心的方法论价值在于:它用三种互补手段建立了完整的因果证据链。
3.1 Activation Patching:定位”什么时候”和”哪条轨道”
这张图想回答:Activation patching 如何揭示 sequence 和 pairwise 表示在不同层的因果作用?
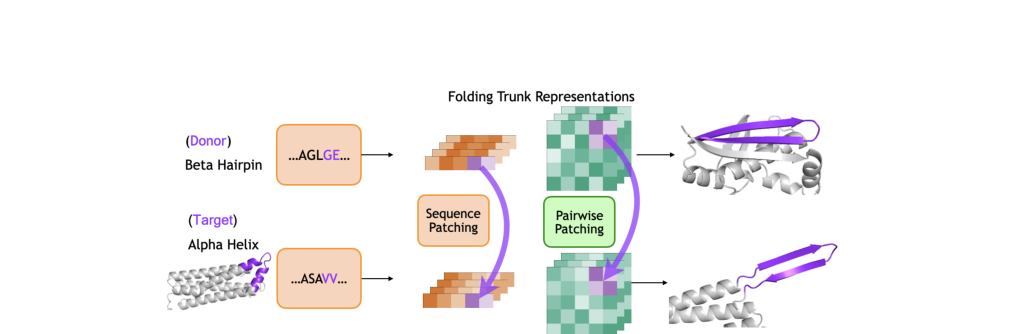
Figure 3. Activation patching 实验设置:将 donor(beta hairpin)的 sequence 或 pairwise 表示替换到 target(alpha helix)的 forward pass 中,观察输出结构是否被改变。
Activation patching 是 NLP mechanistic interpretability 领域发展出来的因果推理工具。核心逻辑如下:
Step 1:选一对蛋白——donor(含 beta-hairpin)和 target(含 helix-turn-helix)。
Step 2:分别跑过模型,取出每一层 trunk 的内部表示 s(k) 和 z(k)。
Step 3:在 target 的 forward pass 中,将某一层、某个局部区域的表示替换为 donor 的对应表示。
Step 4:观察替换后 target 输出的结构是否”变成了 donor 的 motif”。
为什么这能证明因果关系?
纯 probing 只能告诉你”某个信息存在于某一层”,但无法区分这个信息是真正驱动计算的,还是只是冗余的附带产物。而 activation patching 直接做干预:如果把 donor 的 hairpin 表示”移植”到 target 上,target 真的折出了 hairpin,那就证明被替换的那个表示因果上参与了 hairpin 形成。这是从”相关”到”因果”的关键一步。
作者构建了一个大规模实验:200 个 target 蛋白 × 约 130,000 个 donor motif region,产生约 10,000 个 patching 实验。更关键的是,他们分开做 sequence patch(只替换 s(k))和 pairwise patch(只替换 z(k)),而且逐层做 single-block patching,从而精确定位是第几层、哪条轨道在起作用。
3.2 Linear Probing:读出模型内部编码了什么信息
Probing 是在模型表示之上训练一个简单的线性分类器或回归器,检查某一层的表示是否编码了特定信息。在这篇文章中,作者主要用了两种 probe:
Charge probe:在 sequence representation s(k) 上训练线性分类器,判断残基是正电(K, R, H)还是负电(D, E)。
Distance probe:在 pairwise representation zij(k) 上训练线性回归器,预测残基对的 Cα 距离。
Probe 告诉我们信息在哪里、什么时候出现,但证明不了因果性。所以作者用第三种方法补上这个环节。
3.3 Representation Steering:直接”操纵”模型内部变量
如果 probe 发现某个特征(比如电荷)在表示空间中是线性编码的,那它的权重方向就是一个”操纵杆”。沿着这个方向推表示,就能人为增强或削弱这个特征——这就是 steering。
Steering 的逻辑是:
如果沿着”charge 方向”push si,模型的输出结构真的发生了与电荷效应一致的变化(比如异号电荷吸引、同号排斥),那就证明charge 信息真的是模型内部的因果性计算变量,模型在用这个信号做折叠决策。同理,如果沿着”distance 方向”push zij,残基间距离真的相应改变,就证明 z 中的距离编码是因果性的。
四、核心贡献总结
这张图想回答:三种不同架构的折叠模型是否都呈现相同的两阶段计算模式?
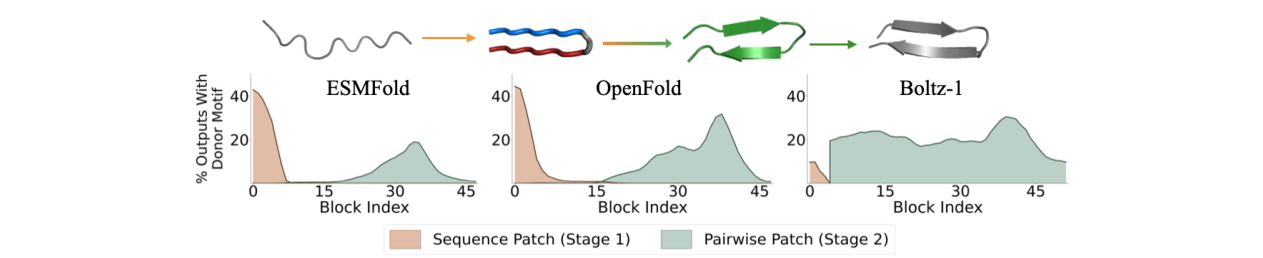
Figure 1. 三种模型的 single-block patching 结果。橙色:sequence patch 有效(Stage 1);绿色:pairwise patch 有效(Stage 2)。三种架构都呈现相同的两阶段模式。
全文最核心的结果来自 single-block patching 实验(Figure 1)。作者在每个 block 分别只 patch sequence 或 pairwise 表示,发现了一个非常清晰的模式:
Stage 1(早期 blocks,约 0-7):sequence patch 有效
在前几个 block patch sequence 表示,成功率最高(约 40%)。越往后 sequence patch 效果越弱。这说明早期由 sequence side 主导,模型在这里根据序列信息决定”这段将来更像 hairpin 还是 helix”。
Stage 2(中后期 blocks,约 25-40):pairwise patch 有效
到中后期,patch pairwise 开始有效并在 30-40 block 达到峰值。这说明后期由 pairwise side 主导,模型在这里把已形成的结构倾向精化成几何约束和空间排布。
这个模式在 ESMFold、OpenFold、Boltz-1 三种架构里都出现了,尽管它们的训练数据、输入模态和架构细节各不相同。这就是标题里的 Two Stages of Folding。
Stage 1 详解:把生化信息写入 Pairwise 空间
为什么 sequence patch 只在早期有效?作者提出并验证了一个假设:早期 trunk 的作用是把 sequence 中的生化信息通过 seq2pair 通路写入 pairwise representation z。
这张图想回答:Stage 1 中 sequence 到 pairwise 的信息流在前 10 层是否占主导?
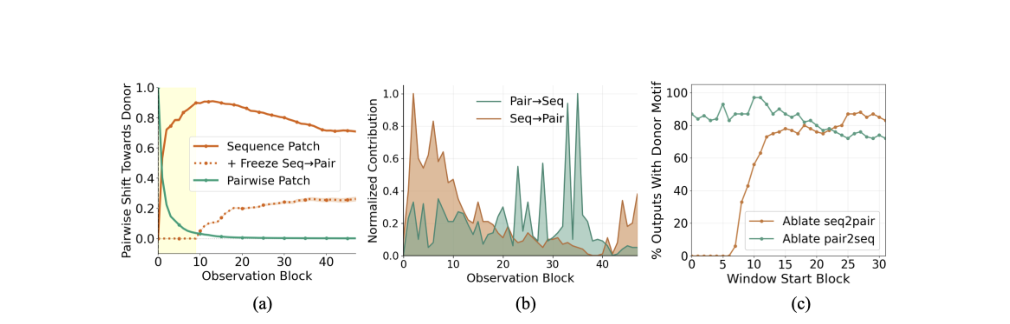
Figure 4. (a) Sequence patch 后 z 的变化:前 10 层迅速漂向 donor,冻结 seq2pair 则漂移消失。(b) seq2pair 贡献在前 10 层最强,pair2seq 在后期才升高。(c) 早期 ablate seq2pair 几乎完全破坏 hairpin 形成。
5.1 三层证据证明”序列信息通过 seq2pair 写入 z”
证据 1:sequence patch 后,z 在前 ~10 层变得像 donor。作者定义了一个插值系数 α,衡量 patched target 的 z 更像 donor 还是 target。在 block 0 patch sequence 之后,pairwise state z 在前约 10 个 block 快速向 donor 漂移,之后变化趋缓。如果把早期的 seq2pair 通路冻结,这个漂移消失。这几乎是直接的因果证据:seq2pair 是把 sequence 信息写入 z 的关键通道。
证据 2:通路贡献大小支持两阶段。测量各 block 中 seq2pair update 和 pair2seq update 的范数(Figure 4b),seq2pair 在前 10 层最强,pair2seq 在后面越来越强——和 patching 的两阶段窗口高度一致。
证据 3:ablation 确认方向性。在 block 0 做 sequence patch 的同时,用 sliding-window 把某一段 block 的 seq2pair 或 pair2seq 删掉(Figure 4c)。早期删掉 seq2pair,hairpin formation 几乎归零;早期删掉 pair2seq,影响很小。所以第一阶段的关键是特定方向的 sequence → pairwise 写入。
5.2 写入的是什么?Charge(电荷)
作者重点分析了 charge,原因在于 beta-hairpin 的两条 strand 之间常见异号电荷的互补稳定作用(盐桥)。如果模型学会了利用电荷信息做折叠决策,那 charge 应该能在表示中被找到。
这张图想回答:用静电互补性来 steering pairwise representation,能否可控地诱导目标结构?
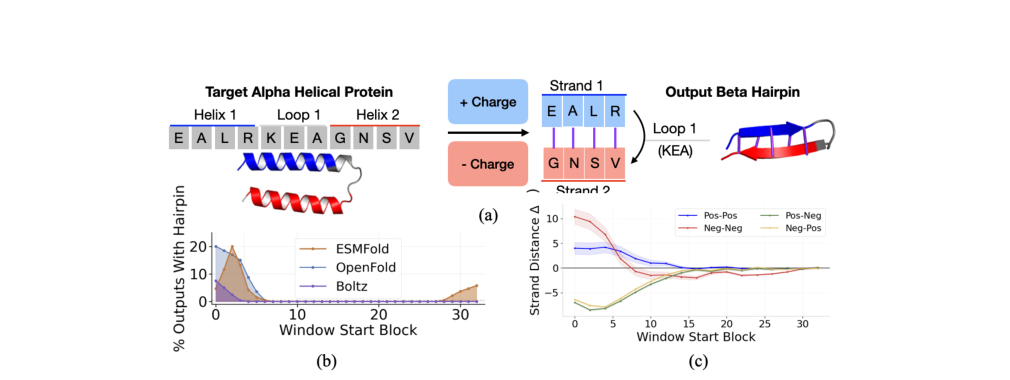
Figure 5. (a) Charge steering 实验设计:对 helix-turn-helix 的两段 helix 分别加”正电”和”负电”扰动,模拟 hairpin 跨链互补电荷。(b) 三种模型中都成功诱导 hairpin,效果集中在 early blocks。(c) 控制实验:同号电荷排斥(距离增大)、异号电荷吸引(距离减小),呈平滑 dose-response。
构造 charge direction 的方法非常直接。取正电氨基酸(K, R, H)的 sequence representation 均值减去负电氨基酸(D, E)的均值,得到 vcharge。验证发现三个模型里都能以高 AUC 线性分离正负电——说明charge 在 sequence representation 中是一个稳定存在的线性方向。
charge 确实被写入了 pairwise representation。在 z 上训练 probe 预测残基 charge,block 0 时几乎读不出 charge,但在早期 blocks probe accuracy 明显上升——上升窗口正好对应 seq2pair 活跃窗口。charge 不是一开始就在 z 里,而是通过早期 seq2pair 被写进去的。
最关键的实验:直接”操纵电荷方向”诱导 hairpin。因为 charge direction 是线性的,作者对 helix-turn-helix target 的一段 helix 加”正电”扰动(s’i = si + α · vcharge),对另一段加”负电”扰动(s’i = si − α · vcharge),人为制造类似 hairpin 跨链互补电荷的模式。
结果(Figure 5b):三种模型里都能显著诱导 hairpin formation,效果集中在 early blocks。
控制实验同样漂亮(Figure 5c):
- 同号电荷加到 hairpin 两股上 → strand 距离增大约 10 Å(排斥)
- 异号电荷加到 helix 两侧 → 距离减小(吸引)
效果随 steering 强度平滑变化,呈单调 dose-response,说明模型在用”连续的电荷信号”做结构推断。
Stage 2 详解:Pairwise Representation 变成几何表示
第一阶段是”化学写入”,那第二阶段呢?作者的回答是:late blocks 中,pairwise representation z 逐渐编码近似的空间几何,尤其是 residue pair 的距离和接触。
6.1 下游计算把 z 当几何通道来读
pair2seq bias 对准 contact map。在中后期 block,pair2seq 通路产生的 attention bias 能以高 ROC-AUC 区分 contacting pairs(Cα < 8Å)和 non-contacting pairs。可视化时,正 bias 明显集中在真实空间接触位置。这意味着late-stage 的 sequence attention 是沿着 contact map 被路由的。
structure module 读 z 作为几何信号。作者做了一个很巧的实验:在进入 structure module 前,缩放 z 的大小同时保持 s 不变。结果:缩放 z 会单调改变输出结构的平均 pairwise 距离(放大 z 结构膨胀、缩小 z 结构收缩),而缩放 s 基本没影响。这说明对 structure module 来说,真正承载几何尺度的是 z。
6.2 距离在 z 中可以被线性预测
这张图想回答:后期 block 中 pairwise representation 是否线性编码了残基对的空间距离?
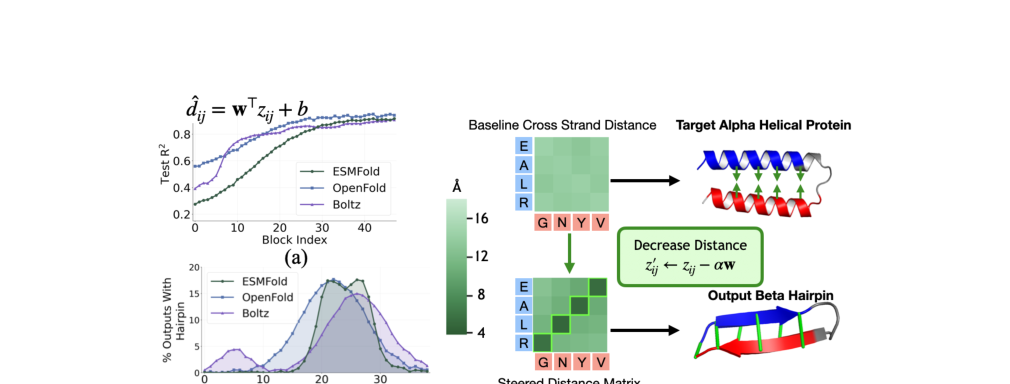
Figure 7. (a) Distance probe 的 R² 从 block 0 接近零上升到 late blocks 的 ~0.9。(b) Distance steering 在中后期 blocks 成功诱导 hairpin。(c) 实验设计:沿 probe 权重方向推 zij,使跨链残基对距离减小。
作者训练线性 probe(d̂ij = wT zij + b)从每层的 zij 预测残基对 Cα 距离。结果(Figure 7a):block 0 几乎没法预测(z 初始化为位置编码),随着层数增加 R² 持续上升,late blocks 达到 R² ≈ 0.9。三个模型都是如此。这说明 late-stage 的 pairwise representation 已经近似是”线性可读的距离图”了。
6.3 Distance steering:沿距离方向操纵 z 诱导 hairpin
既然距离 probe 是线性的,其权重方向 w 就对应”让距离变小”的方向。作者针对目标 hairpin 应该形成接触的跨链 residue pairs,直接对 z 做 steering:z’ij = zij − α · ŵ(朝目标距离 5.5 Å 推)。
结果(Figure 7b):三个模型里都能降低跨链距离并诱导 hairpin,效果峰值出现在中后期 blocks,和 stage 2 的时间窗口完全吻合。
所以第二阶段的证据链也是完整的:probe 发现距离信息 → 下游计算依赖这个信息 → steering 证明它是因果性可操控的。
跨模型共享表示:Platonic Representation
前面只是说”三个模型都表现出类似的两阶段”。这一部分更进一步:它们的 pairwise representations 能否彼此对齐,甚至互换?
这张图想回答:三种不同架构学到的 pairwise 表示在几何层面是否对齐?
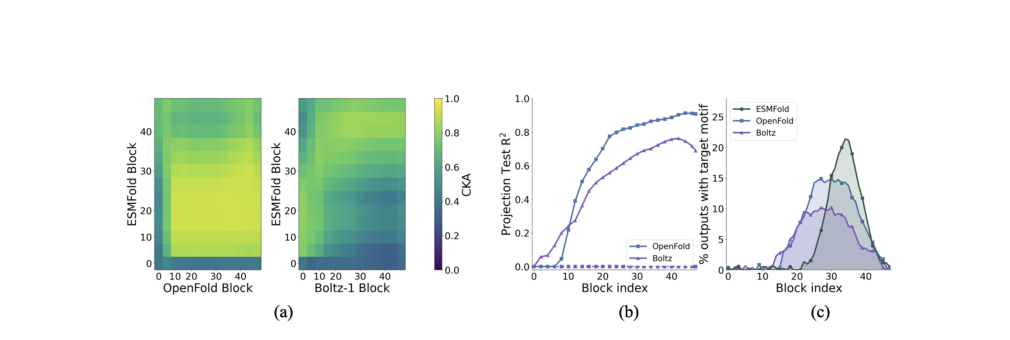
Figure 8. (a) CKA 热力图:ESMFold-OpenFold 和 ESMFold-Boltz-1 的中后期 block 间相似度高。(b) Whitened Procrustes 线性对齐 R²:OpenFold→ESMFold 达 ~0.9,Boltz-1→ESMFold 达 ~0.75。(c) 跨模型 patch:对齐后的 OpenFold/Boltz-1 表示仍能在 ESMFold 中诱导 hairpin。
7.1 CKA 相似性分析
作者计算不同模型不同 block 之间的 Centered Kernel Alignment(CKA)。结果(Figure 8a):中后期 block 之间相似性很高,且主要沿对角线集中——一个模型的 late block 最像另一个模型的 late block。ESMFold-OpenFold 相似度最高,与 Boltz-1 略低但仍然明显。
7.2 Whitened Procrustes 线性对齐
CKA 只说明”形状相似”,但不能证明可以互换。作者进一步用 whitened Procrustes 方法:先对两个模型的 pairwise representation 做白化(去均值、除以协方差矩阵平方根),再找最优旋转矩阵 R 使二者对齐。
结果(Figure 8b):block 0 对齐很差(主要是位置编码差异),5-15 以后快速上升。plateau 时 OpenFold → ESMFold 可达 R² ≈ 0.9,Boltz-1 → ESMFold 可达 R² ≈ 0.75。shuffled correspondence 基本接近零,排除了虚假维度匹配。
7.3 跨模型 patching:对齐后的表示真能”替换使用”
这是最强的结论。作者把 OpenFold 或 Boltz-1 的 donor pairwise representation 先线性投到 ESMFold 空间,再 patch 到 ESMFold 的 forward pass 中。
结果(Figure 8c):跨模型 patch 仍能在 ESMFold 的 late blocks 诱导 hairpin,时序窗口和 ESMFold 自己的 pairwise patch 一致,成功率随对齐质量变化。
这说明不同模型学到的不仅是功能类似的表示,而且是几何上可对齐、功能上可互换的共享 representational geometry。这是 Platonic Representation Hypothesis 在蛋白折叠领域的有力实例——不同架构、不同输入、不同训练过程的模型,收敛到了相同的内部组织方式。
总结证据链与意义
这篇文章最强的地方是证据链的完整性,层层递进:
第一步:定位”什么时候”
Single-block patching → early: sequence patch 有效;late: pairwise patch 有效
第二步:解释 early stage 在干什么
sequence patch 让 z 变 donor-like → 冻结 seq2pair 就失效 → 早期 ablation seq2pair 破坏 hairpin → charge 从 s 写入 z → charge steering 可诱导 hairpin
第三步:解释 late stage 在干什么
pair2seq bias 对准 contact → structure module 读 z 作为几何信号 → distance 可从 z 线性读出 (R²≈0.9) → distance steering 可诱导 hairpin
第四步:说明这是普遍机制
三种架构都复现 → 中后期 pairwise representation 可线性对齐 → 对齐后还能跨模型 patch
一句话概括整篇文章的核心图景:
Folding trunk 的工作可以理解成:先把序列化学整理进 pairwise 空间,再在 pairwise 空间里逐步几何化。
局限性
1)只分析了局部 motif。研究聚焦于 12-25 残基的 beta-hairpin 和 helix 决策,尚不能直接推广到整个蛋白的长程折叠、domain packing 或复杂 β-sheet 组装。
2)依赖显式 pairwise trunk 架构。如果未来出现没有显式 pairwise representation 的新架构(如 SimpleFold),两阶段机制是否仍以某种形式存在仍是开放问题。
3)干预产生的 counterfactual 结构不一定物理可行。patching 后的结构虽然 DSSP 上像 hairpin,但可能 pLDDT 低、有 steric clash。实验说明的是模型内部存在这样的因果控制变量,但这些控制后的结构在真实物理世界中未必稳定。
4)成功率有限。Full patching 约 40%,单层 patch 更低。这说明 motif transfer 受上下文和 flanking interactions 影响,trunk 之外的因素仍然重要。
通讯作者介绍
论文标注的通讯作者是第一作者 Kevin Lu 与 Chris Wendler,两人均来自 Northeastern University(通讯邮箱 lu.kev@northeastern.edu、ch.wendler@northeastern.edu)。同为核心贡献者的 David Bau 是 Northeastern University 计算机科学系教授,是 AI 可解释性(interpretability)领域的代表性研究者之一。他在 MIT 获得博士学位,长期从事神经网络内部表示的理解与编辑工作。他早期关于网络神经元语义可视化(Network Dissection)和表示编辑(如 ROME、Locating and Editing Factual Associations)的工作在 NLP 和计算机视觉领域产生了广泛影响,为”打开黑箱”这个方向建立了一套系统性的研究范式。这篇文章将他在语言模型 interpretability 中发展出的方法论(activation patching、linear probing、representation steering)迁移到蛋白折叠模型中,展示了 mechanistic interpretability 跨领域应用的潜力。
共同通讯作者 Chris Wendler 在本文的署名单位为 Northeastern University,主要研究方向为深度学习模型的机制分析与可解释性。他是本文的共同通讯作者,在跨模型表示对齐与因果干预方法的设计中发挥了重要作用。
第一作者 Kevin Lu 来自 Northeastern University,同时也是共同通讯作者,主导了本文的实验设计与大规模 patching 实验的实现。
引用
Lu, K., Brinkmann, J., Huber, S., Mueller, A., Belinkov, Y., Bau, D., & Wendler, C. (2026). Two Stages of Folding: Convergent Mechanisms in AI Protein Folding Trunks. arXiv. https://doi.org/10.48550/arXiv.2602.06020