
Probing and steering biology across Boltz-1s trunk-diffusion boundary
原文链接:全文
作者:Piotr Jedryszek, Tongmeng Xie, Adam Winnifrith, …, Oliver M. Crook
arXiv,2026 年 8 月 11 日
拆开蛋白折叠 AI 黑箱 · 第四篇
AlphaFold3 一类的结构预测模型由两大模块组成:一个学习表征的 Pairformer trunk,和一个生成原子坐标的 diffusion module。但生物信息在穿过这道架构边界时究竟发生了什么变化?哪些知识被保留,哪些被丢弃?
Oxford 团队用 linear probes、稀疏自编码器(SAE)和因果干预三把手术刀,系统解剖了开源模型 Boltz-1 的 trunk 和 diffusion module。他们发现了一个关键的分裂:二级结构信息完整穿越边界,序列化学信息却被大幅衰减。
更深刻的发现是:用 helix 和 coil 方向 steering 模型可以剂量依赖性地改变预测结构,但一个预测性极高的 beta-strand 方向(F1=0.82)却完全无法增加 strand 含量——线性可解码性并不等于因果影响力。这对所有试图从模型表征中”读出”生物学知识的工作都是一记警钟。
一、研究问题
AlphaFold3 和 Boltz-1 这类结构预测模型的架构可以分为两个阶段:
Pairformer Trunk(表征学习)
接收序列和上下文信息(包括 MSA),通过 48 层 Pairformer 迭代更新两种表征:per-residue 的 single representation s 和 residue-pair 的 pair representation z。这个阶段负责”理解”蛋白质的序列和进化信息。
Diffusion Module(坐标生成)
以 trunk 的输出 s 和 z 为条件,通过 22 层 diffusion transformer 逐步去噪,最终生成三维原子坐标。这个阶段负责从”理解”转化为”结构”。
这两个模块之间存在一道清晰的架构边界。trunk 的输出 conditioning 了 diffusion module,但 diffusion module 内部有自己独立的表征学习过程。一个自然的问题是:
trunk 编码的生物信息,在穿过这道边界后是否完整保留?如果发生了变化,哪些信息被保留、哪些被丢弃?可解码的信息是否真的被模型”使用”?
此前有一些零散的工作分别探测过 trunk 或 diffusion module 的内部表征(如 Feldman & Skolnick 分析 AlphaFold3 的 Pairformer,Lu et al. 用 activation patching 研究 ESMFold),但没有人系统性地对比过 trunk 和 diffusion module,也没有人将可解码性(decodability)和因果影响力(causal steerability)结合起来检验。这篇论文填补了这个空白。
二、方法核心:三把手术刀
作者用三种互补的方法来回答上述问题。理解这三种方法的区别和关系,是读懂这篇论文的关键。
方法一:Linear Probes(线性探测)——”信息在不在?”
最直接的问题:模型的某一层表征里,是否包含特定的生物学信息?
做法
对于每个生物学概念(如”这个残基是 helix”),在模型某一层的 per-residue 激活向量上训练一个逻辑回归分类器(logistic probe)。如果这个线性分类器的 F1 分数远高于随机基线,就说明该概念在该层的表征中是线性可解码的(linearly decodable)。
作者称这个方法为 probe-raw——直接在原始激活上训练的探测器。
覆盖范围
从 trunk 的 48 层中每隔一层取一层(layers 0-47),从 diffusion module 的 22 层中同样每隔一层取一层,同时覆盖 diffusion 的所有 sampling step(steps 0-199)。这样得到一个 layer x step 的完整网格。
探测的概念分为两大类:
- 几何信息(geometry):二级结构(helix, strand, coil)、无序区(disorder)
- 序列化学信息(sequence chemistry):氨基酸种类、信号肽(signal peptide)、二硫键(disulfide bond)、糖基化位点等
评估细节
评估使用 486 个蛋白的固定测试集(含 SwissProt、AlphaFold DB 与 Boltz-1 预测结构三套标签)。Probes 按蛋白分组做 5-fold 交叉验证(同一蛋白的残基不会同时出现在训练集和测试集)。F1 使用 domain-level 指标(precision 按残基计,recall 按 domain 计——只要一个 domain 中至少有一个残基被命中就算 recall 成功)。
氨基酸种类作为正控制(positive control):如果 probe 能完美恢复氨基酸种类(F1 ≈ 1.0),就确认 label 和 activation 的对齐是正确的。
方法二:Sparse Autoencoders(SAE)——”信息存在哪些特征里?”
Linear probe 告诉我们信息”在不在”,但不告诉我们信息由哪些具体的内部特征承载。SAE 试图回答这个更细粒度的问题。
SAE 的核心思想
将模型每个残基的 activation 向量分解为少数几个 “dictionary feature” 的线性组合。通过 TopK 稀疏化(每次只激活 k=256 个 latent,总共 2048 个),迫使每个 latent 尽量对应单一的生物学概念。
SAE 在 84,074 个无标签蛋白(21.9M 残基)上训练,使用 l2 weight regularization。每个维度的训练集均值被减去——因为作者发现少数高方差维度会主导学习。
四种 readout 方式的区别
- probe-raw:在原始激活上训练 logistic probe(上述方法一)
- probe-SAE:在 SAE 的 latent 空间上训练 logistic probe
- SAE-1feat:找到与目标概念最匹配的单个 SAE latent(不训练额外分类器)
- neuron-1feat:找到最匹配的单个原始神经元(对照基线)
这四种 readout 的关系很重要:probe-raw 和 probe-SAE 是监督方法,利用了标签信息;SAE-1feat 和 neuron-1feat 是无监督方法,只看单个特征与标签的对齐程度。后面的结果会反复比较这四种 readout。
方法三:Causal Steering(因果干预)——”信息被使用了吗?”
可解码性只是”信息存在”的证据。模型可能编码了某个特征但从不使用它——就像大脑中可能存在某种信号但不影响行为。要证明信息被”使用”,需要因果实验。
Steering 的做法
找到 probe 或 SAE decoder 学到的”概念方向”(一个单位向量 u),将其加到 trunk 最终层的 single representation s 上:
s’ = s + k · mean|(x - μ) · u| · u
其中 k 是剂量倍数(1, 2, 4, 8, 16)。然后用修改后的 s’ 重新跑 diffusion module,生成新结构,看 DSSP 指定的二级结构比例是否发生了预期变化。
关键设计:pair representation z 保持不变。steering 只修改 single representation s——这是 diffusion module 的条件输入之一。
对照设计
- matched-norm random:替换概念方向为随机方向(与概念方向等范数),检验效果是否特异于概念方向
- 19-direction random null:对同一批蛋白用 19 个不同的随机方向做 steering,构建随机基线分布
- ablation 实验:把概念方向从 s 中减去(而非加入),测试去除该方向后结构是否变化
- pLDDT 监控:确认 steering 后预测置信度 pLDDT 保持稳定(约 79),证明干预在模型学到的表征分布范围之内,没有推到”离轨”的区域
数据拆分:389 个蛋白用于训练 steering 方向,97 个 held-out 蛋白用于评估。训练集按 helix 含量分层抽样,评估集固定且在 steering 前就已确定,确保 held-out 评估是公平的。
三、看图说话
Figure 1 · Trunk 保留一切,Diffusion Module 只留几何
这张图想回答:trunk 和 diffusion module 的输出表征中,哪些生物学概念是可解码的?两个模块之间有什么差异?
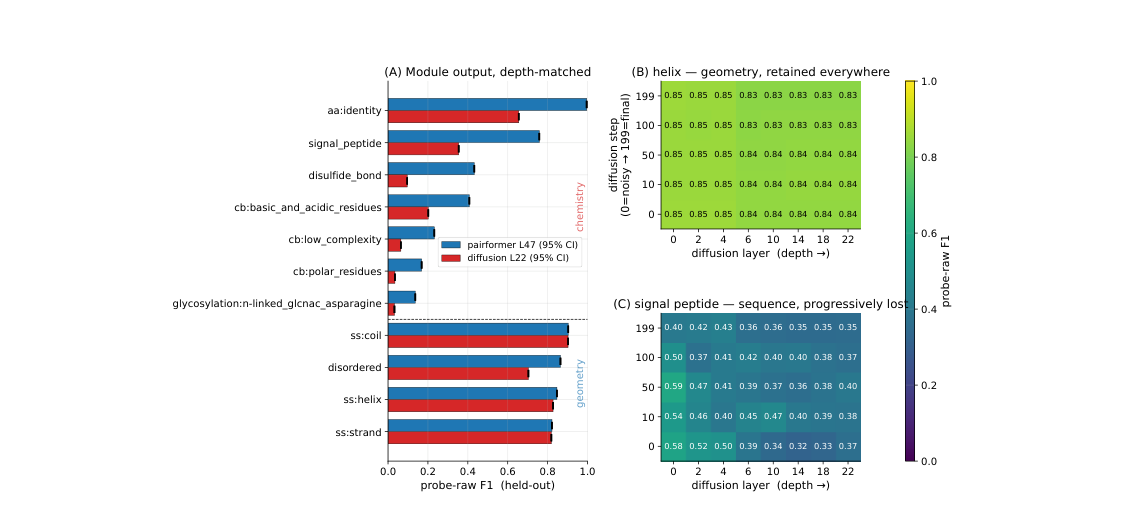
Figure 1. (A) depth-matched 对比:trunk L47 vs diffusion L22 的 probe-raw F1。几何概念在两个模块中分数相近,序列化学概念在 diffusion module 中显著下降。(B) Helix 的 diffusion layer x sampling step 热力图——全网格明亮,几何信息被稳定保留。(C) Signal peptide 的热力图——随 depth 和 step 逐渐衰减。
怎么读这张图
- Panel A 是核心:横轴是 probe-raw 的 held-out F1 分数,纵轴列出了各种生物学概念。蓝色条(trunk L47)和红色条(diffusion L22)的对比一目了然。几何类概念(helix, strand, coil, disorder)在两个模块中得分几乎相同。但序列化学类概念出现了系统性的衰减:signal peptide 从 0.76 降到 0.35,disulfide bond 从 0.43 降到 0.10,氨基酸种类从接近 1.0 降到 0.66。
- Panel B 展示了 helix 在 diffusion module 整个 layer x step 网格上的 F1——全网格明亮(约 0.83-0.85),说明 helix 信息从最嘈杂的初始 step 开始就已经被稳定编码,且跨所有 layer 一致。这意味着 diffusion module 从一开始就”知道”哪些残基应该是 helix。
- Panel C 形成鲜明对比:signal peptide 的热力图沿两个轴都在衰减。越深的 diffusion layer、越晚的 sampling step,信号越弱。这表明 diffusion module 在处理过程中逐步丢弃序列化学信息——因为计算几何不需要它。
Figure 2 · Steering 结果:Helix/Coil 可控,Strand 失灵
这张图想回答:可解码的概念方向能否用来 steering 模型的结构预测?哪些概念可以 steering,哪些不行?
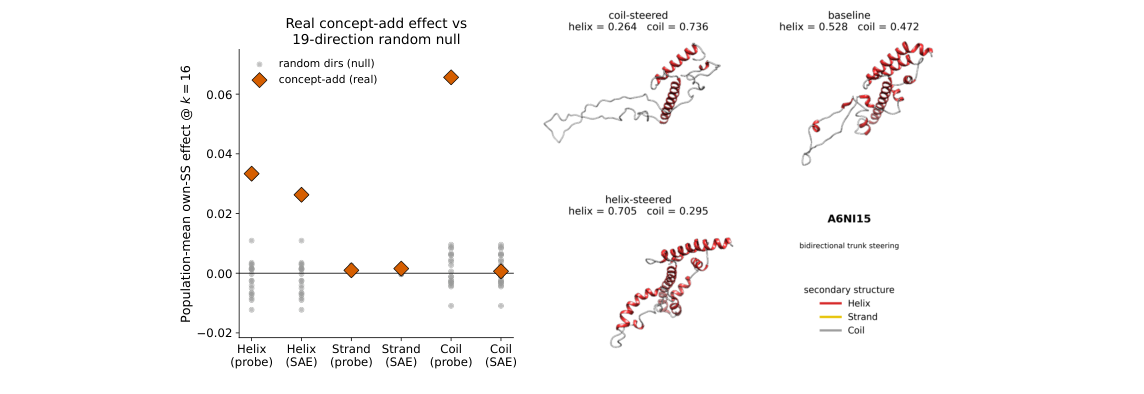
Figure 2. 左:各概念方向的 steering 效果(concept-add vs 19-direction random null)。Helix 和 coil 方向(probe 和 SAE)显著高于随机对照,strand 方向无效。右:蛋白 A6NI15 在 helix steering 和 coil steering 下的结构变化——helix 和 coil 比例发生双向调控。
怎么读这张图
左侧散点图展示了 97 个 held-out 蛋白的群体平均 steering 效果(k=16)。黄色菱形是概念方向的效果,灰色点是 19 个随机方向的 null 分布。Helix(probe 和 SAE 两种方向都有效)和 coil(probe 方向有效)显著高于随机对照。Strand 的两种方向(probe 和 SAE)都淹没在随机噪声中。
右侧蛋白结构是一个直观的案例:蛋白 A6NI15 在 baseline 下 helix 含量 52.8%、coil 47.2%。用 helix 方向 steering 后 helix 升至 70.5%、coil 降至 29.5%;用 coil 方向 steering 后效果反转,helix 降至 26.4%、coil 升至 73.6%。这表明 helix 和 coil 方向位于同一条反平行轴上(cos = -0.69),推一端就拉另一端。
四、核心贡献总结
发现一:Trunk 是”全能型”,Diffusion Module 是”几何专家”
trunk 的最终层(L47)表征中,几何信息和序列化学信息都高度可解码:
- 几何类:helix F1 = 0.79-0.90,strand F1 ≈ 0.83,coil F1 ≈ 0.86,disorder F1 ≈ 0.86
- 序列化学类:signal peptide F1 ≈ 0.76,disulfide bond F1 ≈ 0.43
- 正控制:氨基酸种类 F1 = 0.996(trunk 输出),确认 label-activation 对齐正确
进入 diffusion module(L22)后,两类信息发生了戏剧性的分裂:
- 几何类基本不变:helix、strand、coil 的 F1 变化幅度不超过 0.02
- 序列化学类大幅衰减:signal peptide 从 0.76 降到 0.35,disulfide bond 从 0.43 降到 0.10,氨基酸种类从 1.00 降到 0.66
作者对此给出的解释是:diffusion module 以 trunk 的 s 为条件来计算几何(坐标),它可以消费序列化学信息而不需要重新表征它。就像你用地图导航时,大脑”消费”了地图上的信息来计算路线,但意识中不再保留地图的原始细节。随着 diffusion layer 的加深和去噪步骤的推进,序列化学信号被逐步耗尽。
发现二:Helix/Coil 可 Steering,Strand 不行
Steering 实验的结果更出人意料:
Helix 和 Coil:可控
在 trunk 的 single representation 上加入 helix 方向,held-out 蛋白的 helix 含量剂量依赖性地增加,显著高于 matched-norm 随机对照和 19-direction random null。Coil 方向同理。pLDDT 保持在约 79,说明干预没有”搞坏”模型——它仍然在自信地生成结构,只是结构内容变了。
更有趣的是,helix 和 coil 方向近似反平行(cos = -0.69),说明它们编码在同一条轴上。推向 helix 端自然减少 coil,反之亦然。这为蛋白质设计提供了一个连续可调的”旋钮”。
Strand:预测性极高但无法 Steering
Strand 方向在 trunk 中的预测性极高:probe F1 = 0.82,precision ≥ 0.93。它精准地”知道”哪些残基是 beta-strand。但当用这个高度预测性的方向做 steering 时,strand 含量没有任何可测量的增加。steering 的效果完全淹没在随机噪声中。
更令人困惑的是:加入 strand 方向后,产生的效果反而是把 helix 转化成 coil——就好像模型”听到了干预”,但给出了完全不同的回应。
“线性可解码 ≠ 因果控制”的深层含义
Strand 的例子是这篇论文最深刻的发现。它揭示了一个容易被忽略的陷阱:从模型表征中能”读出”某个概念,并不意味着在同一个位置干预该概念就能改变输出。
为什么 Strand 不能 Steering?作者的假说
理解这个结果需要回到 beta-strand 的物理本质。Beta-sheet 由序列上距离很远的残基之间的主链氢键定义。这种长程配对信息天然是 pair-wise 的——它编码在 pair representation z 中。
在 Boltz-1 中,信息流是 z → s(pair 向 single 单向流动)。Trunk 的 single representation s 可以接收来自 z 的 strand 信息,所以 probe 能从 s 中解码出 strand。但 steering 修改的是 s,而 s 无法反向影响 z。diffusion module 在生成 strand 时依赖的是 z 中的配对信息,单纯在 s 上加入 strand 方向到不了 strand 形成的真正因果位点。
打个比方
想象一个温度计放在窗户旁边。你可以从温度计上”读出”外面的温度(可解码),但拿吹风机加热温度计并不能改变外面的天气(无因果控制)。温度计是外部温度的被动读数器,它所在的位置不具有因果影响力。Strand 信号在 single representation 中就像这个温度计——可以被读到,但干预它不影响输出。
对比之下,helix 和 coil 由局部主链构象定义——局部扭转角和局部氢键就足以确定。这种信息可以完全由 single representation 承载,所以在 s 上 steering 就能直接影响 diffusion module 的几何生成。
消融实验的佐证
作者做了消融实验来进一步验证这个假说。他们尝试从 trunk、diffusion module、或两者同时去除 helix 方向,结果:
- 从 trunk 去除 helix 方向:helix 含量几乎不变(+0.003)
- 从 diffusion module 去除:同样几乎不变(-0.001)
- 从两者同时去除:仍然不变(+0.001)
这说明 helix/coil 的几何信息是冗余编码的——trunk 的 single-representation 方向足以 steering(充分性),但去掉这个方向后模型仍能从其他来源重建几何(非必要性)。Steering 方向是充分但非必要的因果因素。
对可解释性研究的方法论警示
这个发现对整个 ML 可解释性领域(不仅限于蛋白质)提出了三条方法论建议:(1) 指明 readout 类型——”模型表征了 X”这句话不充分,必须说明是哪种 readout(probe、SAE、单特征?)以及使用了什么标签;(2) 因果结论必须限制在测试过的干预位点和方式上——在 s 上 steering 有效不代表在 z 上也有效,反之亦然;(3) 评估稀疏注释时必须控制缺失标签——否则假阳性会系统性地膨胀。
发现三:SwissProt 注释的稀疏性让所有评估分数成为下界
作者还揭示了一个被广泛忽视的评估陷阱。当用 SwissProt 的稀疏实验注释做标签时,probe 的 F1 显著低于用 DSSP 的密集计算标签做标签:
- Helix:dense DSSP F1 = 0.85 vs sparse SwissProt F1 = 0.42(差距 0.43)
- Strand:dense DSSP F1 = 0.83 vs sparse SwissProt F1 = 0.33(差距 0.50)
原因很简单:SwissProt 只注释了实验验证过的区域,大量真实的 helix/strand 残基没有注释。当 probe 正确预测了这些未注释的残基时,它们被计为假阳性——模型做对了反而被扣分。
作者通过自一致性检查排除了模型预测错误的可能性:用 Boltz-1 自己的预测结构算 DSSP,与用 AlphaFold 结构算的 DSSP 对比,helix probe-raw F1 只差 0.06-0.08。所以 SwissProt 的大幅下降反映的是注释不完整,而非模型失误或 probe 失灵。这意味着所有使用稀疏注释评估模型表征的工作,得到的分数都是精度下界。
发现四:有标签时,监督 Probe 全面优于 SAE 单特征
比较四种 readout 在 trunk 二级结构上的表现:
- probe-raw 全面优于 SAE-1feat,差距 0.13-0.35 F1
- 具体数字:helix probe 0.85 vs SAE-1feat 0.72;strand probe 0.82 vs SAE-1feat 0.47
- 在 steering 上也是如此:coil 的 probe 方向能 steer,SAE 的 best coil latent 则不能
- SAE-1feat 有时能在稀有概念上超过 probe——但这是 winner’s curse:best-of-many 选择在随机基线也能接近零的概念上制造虚假的高分
这并不意味着 SAE 没用。作者指出 SAE 的价值在于假说生成:它可以发现现有注释词汇中没有的概念。在一项姊妹研究中,同样的 trunk SAE 用自动可解释性技术发现了推定的锌配位簇(zinc-coordination cluster)和激酶催化组氨酸 motif——都没有对应的 SwissProt 标签。但一旦有了标签,监督 probe 始终更可靠。
五、局限与展望
对蛋白质 AI 理解的贡献
1. 首次系统对比 trunk 和 diffusion module 的信息内容。此前的工作要么只看 trunk(如 AlphaInterp),要么只看 diffusion module(如 Bish-Bash-Fold)。这篇论文第一次在同一框架下对比两个模块,发现了 geometry vs sequence chemistry 的分裂。
2. 首次将可解码性和因果 steering 结合。prior work 通常只做 probing 或只做 steering。这篇论文证明了二者可以不一致——这是一个重要的方法论发现。
3. 量化了稀疏注释对评估的影响。SwissProt 注释稀疏性导致 F1 被系统低估 0.4-0.5,这对所有使用 SwissProt 做 benchmark 的可解释性工作都有影响。
局限性
1. 只测了一个模型(Boltz-1)。AlphaFold3、Chai-1 等模型是否有相同的 trunk-diffusion 分裂有待验证。
2. Steering 只在 single representation 的二级结构轴上做过。序列化学概念(signal peptide、disulfide bond)的因果 steering 尚未尝试。pair representation z 上的直接干预也没做——而这正是 strand steering 失败后最自然的下一步。
3. Probe 的 fold 按蛋白分组但未按序列同一性聚类。近同源蛋白可能出现在不同 fold 中,虽然作者用 BLOSUM62 检查了泄漏(仅 3.3% 的 test 蛋白有 >30% 同一性的 training 近邻),但严格的同一性去冗余会更保守。
4. Steering 只是”推动”模型预测,不是蛋白质设计。作者明确声明:steering 改变的是预测结构,不证明改变后的结构是可折叠的真实蛋白。这不是 de novo design 工具。
与本系列其他文章的联系
本系列第二篇介绍的 Bish-Bash-Fold 同样使用 SAE 分析蛋白折叠模型(AF3 和 Boltz-2 的 diffusion module),发现了可解释的生物学特征和 MSA 依赖模式。这篇论文将类似的方法论(SAE + probes + steering)扩展到了trunk-diffusion 边界的系统性对比。两者的核心发现形成呼应:Bish-Bash-Fold 表明 SAE 能发现 MSA 激活/静默等无标签功能类别,本文进一步证明了仅凭 SAE 单特征对齐(SAE-1feat)不足以替代监督 probe——有标签的情况下,监督方法始终更可靠。同时,本文的 strand steering 失败案例也为 SAE 特征的因果角色敲响了警钟:能被 SAE 捕捉到的特征,未必在模型的因果链条上。
通讯作者介绍
通讯作者 Piotr Jedryszek 同时隶属于 University of Oxford 生物系和 Evolvere Biosciences(伦敦)。资深作者 Oliver M. Crook 在本文的署名单位为 University of Oxford 的 Kavli Institute for Nanoscience Discovery 与化学系,研究方向涵盖贝叶斯统计、蛋白质组学空间分析(spatial proteomics)、以及机器学习在生物学中的应用。Crook 此前的代表性工作包括 BANDLE(贝叶斯差异亚细胞定位分析)和 MR.Ash(多分辨率自适应收缩先验),近年来将研究重心转向蛋白质结构预测模型的可解释性与可控性。本文的第一作者 Jedryszek 与 Crook 此前还合作发表了 TopK SAE 的 weight regularization 方法论文(ICML 2026 Workshop on Mechanistic Interpretability),本文使用的 SAE 正是基于该方法训练的。
引用
Jedryszek, P., Xie, T., Winnifrith, A., Hasson, A., Ślesak, W., Wicks, G., … & Crook, O. M. (2026). Probing and steering biology across Boltz-1s trunk-diffusion boundary. arXiv. https://doi.org/10.48550/arXiv.2608.11475