
InterPLM: discovering interpretable features in protein language models via sparse autoencoders
原文链接:全文
作者:Elana Simon, James Zou
Nature Methods,2025 年 10 月
蛋白语言模型(PLM)在蛋白质建模和设计上成绩斐然,但它内部到底学到了什么?一个神经元到底代表什么生物概念?这些问题一直缺乏系统性回答。
Stanford 的 Elana Simon 和 James Zou 提出了 InterPLM 框架:用稀疏自编码器(SAE)分解 ESM-2 的内部表征,发现了数千个可解释的生物学特征——从结合位点、结构模体到功能域、翻译后修饰。他们还证明,这些特征不仅能用于发现数据库中的缺失注释,还能因果性地控制模型的序列预测。
一、研究问题
ESM-2 这类蛋白语言模型可以从纯序列出发预测蛋白结构、标注功能、评估突变效应。它们的成功意味着,在训练过程中模型必然学到了大量关于蛋白质的物理化学和进化规律。但一个根本问题始终存在:
PLM 的内部表征到底长什么样?它是如何存储和组织生物学知识的?
回答这个问题的意义是多方面的:理解模型内部机制可以帮助我们识别虚假相关和系统偏差,评估模型预测的可靠性,甚至可能从模型中反向发现人类尚未认识到的生物学规律。过去的解释工作主要有两条路线:
Attention 分析
观察注意力头的权重分布,发现某些 head 能捕捉残基空间接触、共进化耦合等模式。但注意力权重只是一种间接的”关注程度”指标,无法回答”模型用什么内部变量来表示 zinc finger domain”这类具体问题。
Probing 探测
在模型某层的 embedding 上训练一个线性分类器,看它能否预测二级结构、接触图、功能标签。如果能,就说明相关信息”存在于”这一层。但 probing 只是存在性测试——它无法告诉你这个知识由哪个具体的内部特征承载,也无法区分”信息被模型主动使用”和”信息只是被动存在于表征中”。
一个最直觉的想法是:能不能直接看单个神经元?如果 PLM 的第 42 号神经元恰好在所有 zinc finger domain 残基上激活、在其他位置沉默,那我们就可以说”第 42 号神经元编码了 zinc finger”。这种”一个神经元 = 一个概念”的对应关系,是最理想的可解释状态。
但 NLP 领域的研究早已揭示了一个重要现象:大型语言模型中的单个神经元通常是”多义的”(polysemantic)——同一个神经元可能对多个毫不相关的概念都有响应。这是因为模型需要表示的概念数量远多于神经元数量,所以被迫把多个概念叠加编码(superposition)在同一组神经元里。
这篇文章的核心思路就是:如果概念是叠加存储的,就需要一种”去混合”的方法把它们拆开。在 NLP 领域,稀疏自编码器(SAE)已经被证明能有效执行这种拆解。那么,同样的方法能否用于蛋白语言模型?SAE 拆出来的特征,是否真的对应可识别的生物学概念?
二、方法核心:稀疏自编码器如何拆解蛋白表征
InterPLM 的方法源自 NLP 领域的 mechanistic interpretability(机制可解释性)研究。让我们从直觉出发理解这个方法。
类比:用棱镜分解白光
想象 PLM 的每个残基 embedding 是一束”白光”——它包含了关于这个残基的所有信息(结构角色、功能注释、进化保守性等),但这些信息全部混合在一起,人眼无法区分。SAE 就像一个棱镜,把这束白光分解成各种波长的”纯色光”。每一种纯色光(SAE 特征)理想情况下对应一个明确的生物学概念。并且,对于任何一个具体的残基,只有少数几种纯色光是亮的(稀疏性约束),其余都是暗的——这使得解释变得简单。
SAE 的数学形式
对于输入向量 x(某个残基在 ESM-2 第 k 层的 hidden embedding),SAE 学习一组 dictionary:
x ≈ b + Σ fi(x) · di
其中 fi(x) 是第 i 个特征的激活值(非负标量),di 是对应的 dictionary vector(方向),b 是偏置。训练目标有两部分:重建准确性(让 SAE 的输出尽量还原原始 embedding)和 稀疏性(通过 L1 正则化迫使大部分 fi 为零)。
关键的设计是过完备字典:SAE 的 feature 数量远大于原始 embedding 维度。ESM-2-8M 的 embedding 是 320 维,SAE 扩展到 10,420 个 feature(32 倍)。这意味着 SAE 提供了一个更大的”词汇表”来描述每个残基——但因为稀疏性约束,每次只能”用到”其中的几个词,所以不会出现冗余表示。
训练设置
- ESM-2-8M(6 层,每层均训练 SAE):320 维 → 10,420 个 feature,32× expansion
- ESM-2-650M(33 层中选 6 层分析):1,280 维 → 10,420 个 feature,8× expansion
- 训练数据:从 UniRef50 随机抽取 500 万条蛋白序列,提取所有残基的 hidden states(去掉 <cls> 和 <eos>)
- 每层训练 20 组超参数配置,用重建质量 + 生物学可解释性指标联合选最优模型
如何判断特征是否”可解释”:domain-adjusted F1
作者在 50,000 个 Swiss-Prot 蛋白上,用 433 个已知生物学概念(domain、binding site、active site、motif、PTM、targeting sequence、disorder 等)作为”标准答案”,把每个概念转化为残基级别的二值标签,然后计算每个 SAE feature 与每个概念的匹配度。
这里有一个精妙的方法学细节。传统的残基级 precision/recall 会严重低估 SAE 特征的价值。举例来说:某个 tyrosine recombinase domain 长达数百个残基,但 SAE 特征只在其中 2 个高度保守的催化残基上激活。按残基级 recall 算,它只有 0.011;但实际上这个特征成功识别了每一个 domain——只是它抓住的是最关键的两个位点,而非整个区域。
因此作者提出了 domain-adjusted recall:recall 的计算单位从残基改为 domain 实例——只要一个 domain 中有至少一个残基被特征命中,就计入 recall。改用这个指标后,上述特征的 recall 变为 1.0,准确反映了它的检测能力。
三、看图说话
Figure 1 · SAE 总览与代表性特征
这张图想回答:InterPLM 的工作流程是什么?SAE 提取出的特征长什么样?
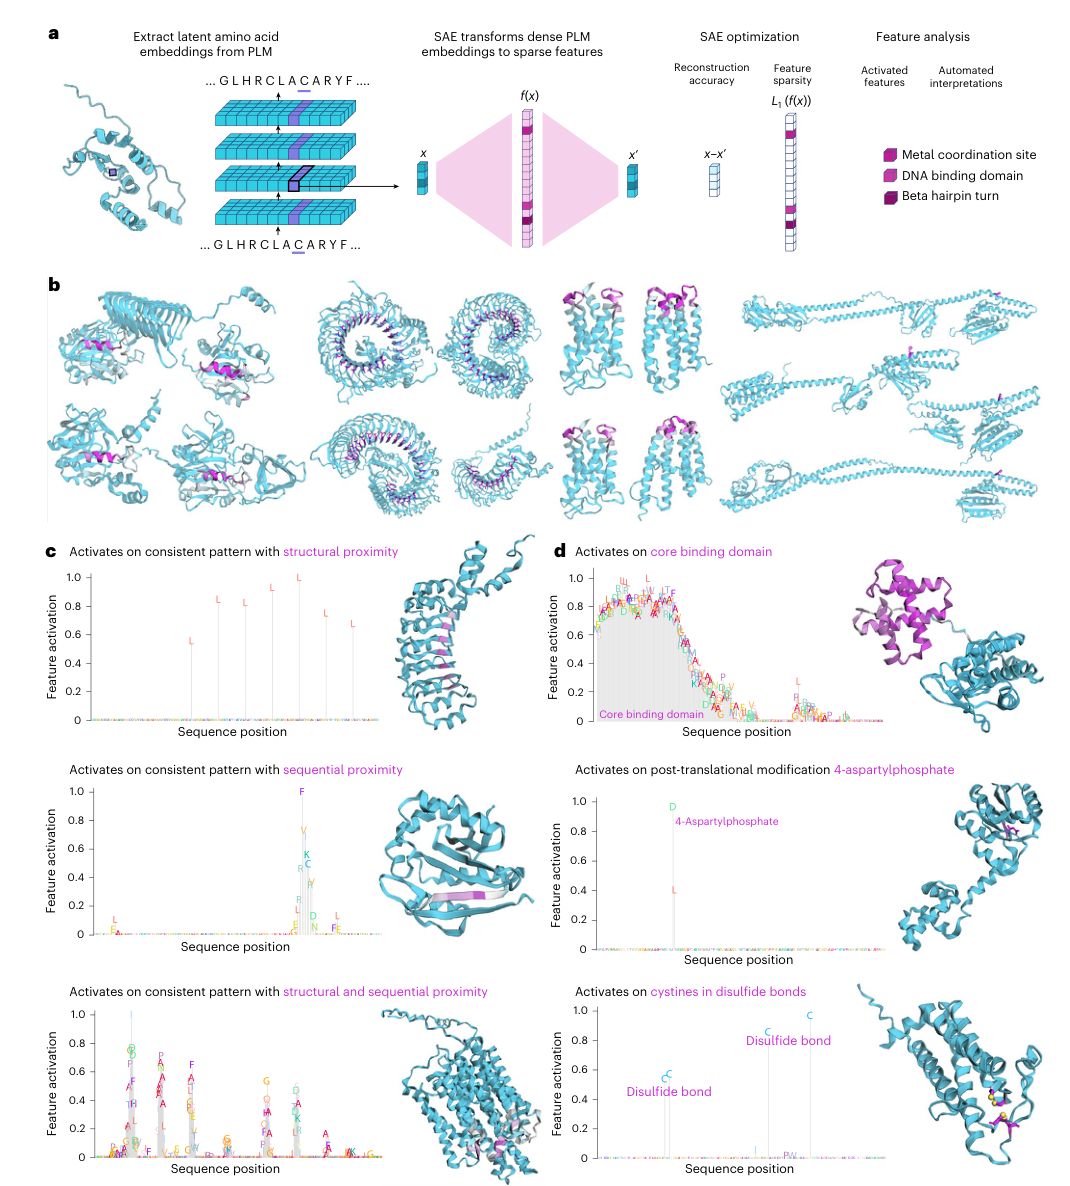
Figure 1. (a) SAE 处理流程。(b) 四个代表性特征在不同蛋白上的一致激活模式。(c) 三类激活模式:结构近邻、序列近邻、两者兼有。(d) 与 Swiss-Prot 注释强对应的特征案例。
怎么读这张图
- Panel a 展示了完整的技术管线:蛋白序列喂入 ESM-2,提取每个残基的 hidden embedding(稠密向量 x),经过 SAE 分解为稀疏的 feature activation 向量 f(x)(大部分为零,少数被激活),同时优化重建精度(x’ 近似 x)和稀疏性(L1 正则)。右侧展示分解后的特征可以对应到金属配位位点、DNA 结合域、beta 发夹转角等具体生物概念。
- Panel b 是最直观的展示:同一个 SAE 特征(如 f/1854)在来自不同蛋白家族的多个蛋白上激活,粉色高亮标记的残基在三维结构中占据相似的位置和角色。这种跨蛋白的一致性表明 SAE 特征捕捉的是真正的生物学规律,而非某个蛋白家族的记忆偏差。
- Panel c 揭示了三类激活模式,这个发现本身就非常有价值:
- 结构近邻型:在 3D 空间中相近、但在序列上可能相距很远的残基共同激活。例如一个结合位点的残基分布在序列的不同位置,但折叠后在空间中聚集。
- 序列近邻型:在序列上连续的区段激活,对应短 motif、beta 链等线性元素。
- 组合型:同时具有序列和结构聚集性,如 alpha 螺旋 bundle 中的 turn 区域。这类特征的存在有力地证明 PLM 编码了远超线性序列模式的三维结构信息。
Figure 2 · SAE 特征 vs 原始神经元:量化对比
这张图想回答:SAE 特征到底比原始神经元可解释多少?这是全文最重要的定量结果。
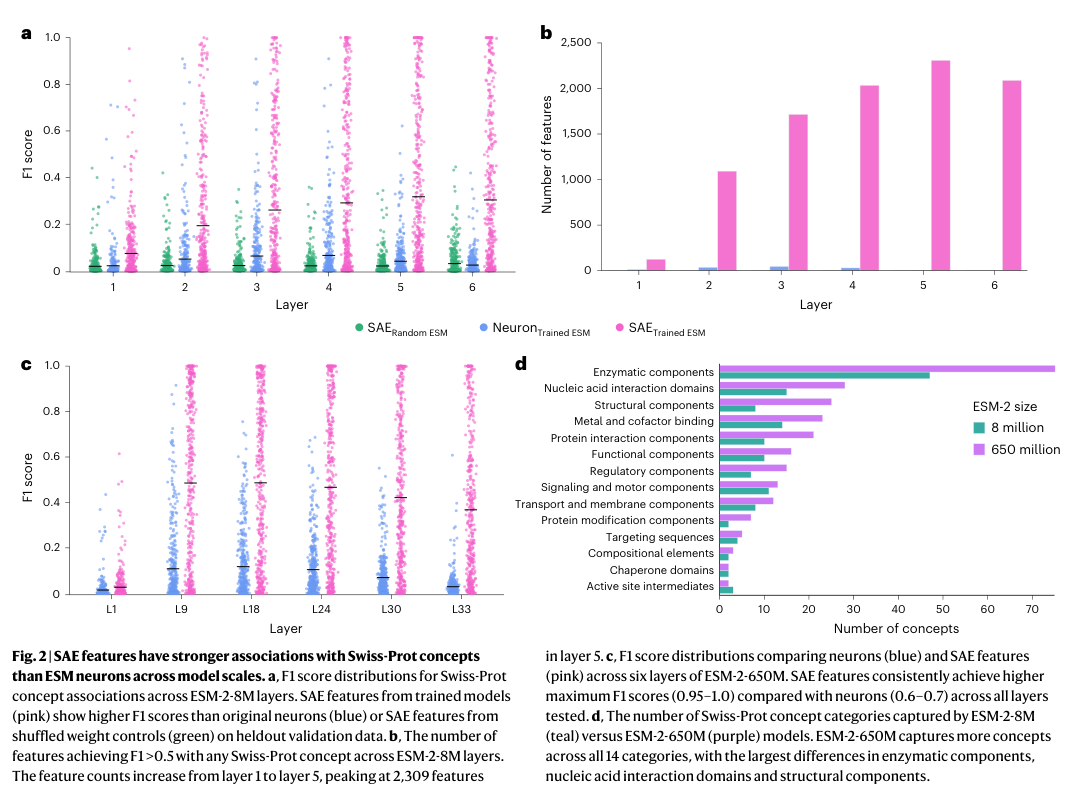
Figure 2. (a) ESM-2-8M 各层的 F1 分数分布。(b) 各层强概念关联特征数。(c) ESM-2-650M 的 F1 对比。(d) 两种模型规模在 14 个功能类别上的概念覆盖。
核心数据与解读
- Panel a 是最关键的对比实验。三种颜色代表三个比较对象:粉色是训练后模型上的 SAE 特征,蓝色是训练后模型的原始神经元,绿色是随机权重模型上的 SAE 特征(阴性对照)。结果非常清晰——SAE 特征的 F1 分数远高于原始神经元,而随机基线几乎为零。绿色对照的意义在于:它证明复杂生物特征不是 SAE 从输入数据分布中”凑”出来的,而是依赖训练后模型学到的知识。
- Panel b 展示了数量级的差距:ESM-2-8M 每层最多有 2,309 个 SAE 特征与某个概念强关联,而原始神经元每层最多只有约 46 个。SAE 能识别 143 个不同的 Swiss-Prot 概念,而神经元只覆盖约 15 个(近 10 倍)。强关联特征的数量差距更大(约 50 倍),这直接证明了 PLM 中 superposition 现象的普遍性。
- Panel c 在 ESM-2-650M 上重复了同样的实验。SAE 仍然显著优于神经元,且 SAE 特征的最高 F1 分数可达 0.95–1.0。这意味着某些特征与 Swiss-Prot 注释几乎完美对应。
- Panel d 揭示了一个重要规律:ESM-2-650M 在所有 14 个功能类别上都比 8M 捕获了更多概念(总计 427 个 vs 143 个,1.7× 以上)。差距最大的是酶活性组分、核酸相互作用域和结构组分。但即使在更大的模型中,神经元仍然是多义的——模型变大的效果是叠加编码的容量增大,可以塞入更多概念,但每个神经元并不会变得更”纯净”。
Figure 3 · 特征激活模式与功能簇
这张图想回答:这些特征之间是否存在有组织的结构?功能相关的特征是否在 embedding 空间中聚集?
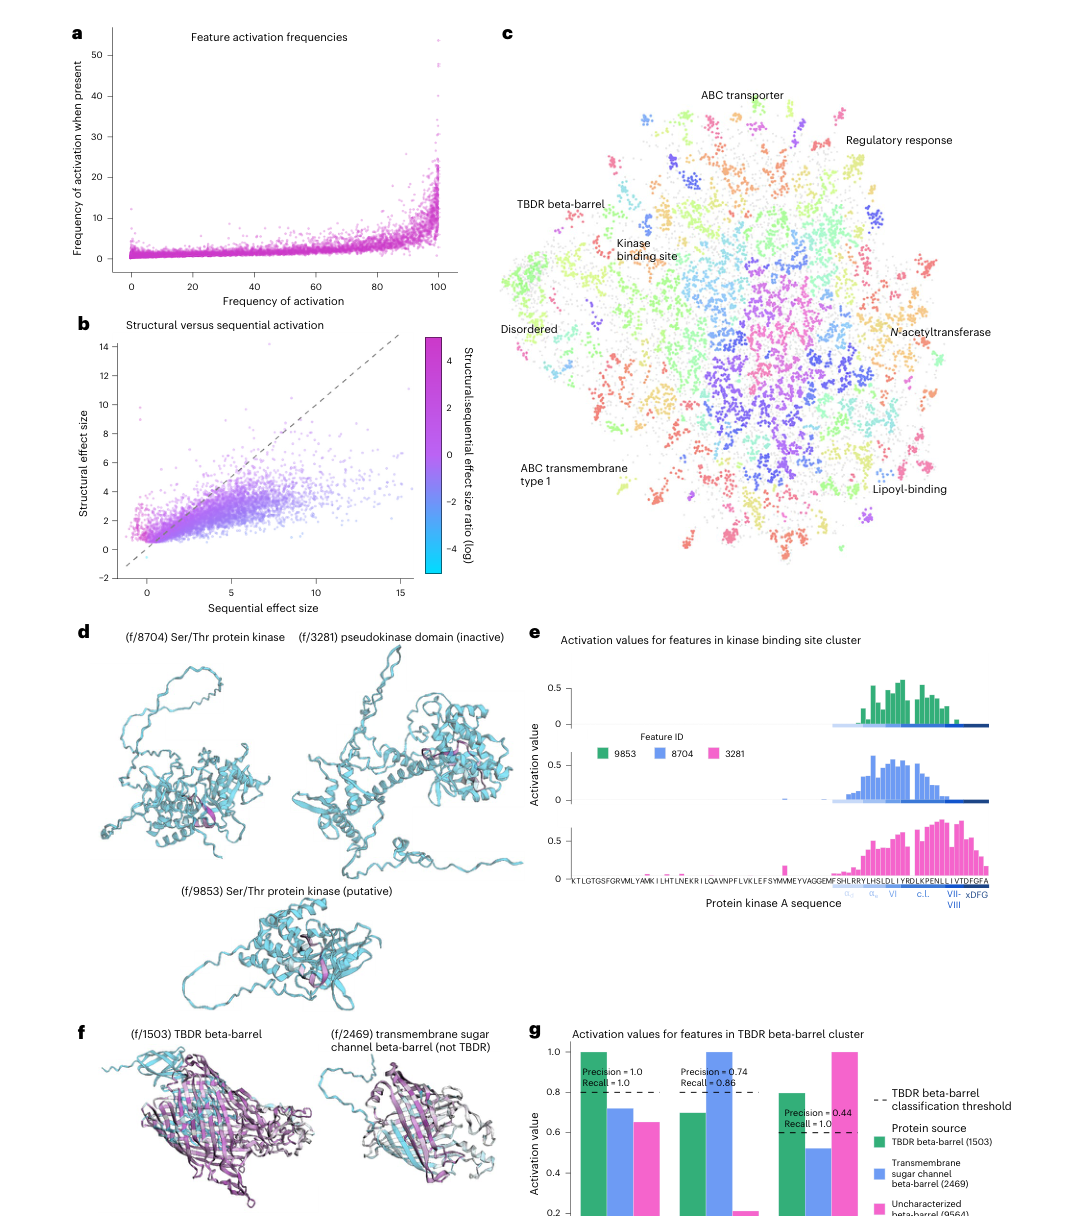
Figure 3. (a) 特征激活频率分布。(b) 结构 vs 序列聚集性散点图。(c) 特征 dictionary vector 的 UMAP 嵌入。(d–e) Kinase 特征簇。(f–g) Beta-barrel / TBDR 特征簇。
特征的宏观组织
- Panel a 展示了所有特征的激活频率分布:有些特征在几乎所有蛋白上都会激活(通用特征,如疏水核心标记),有些只在极少数蛋白家族中出现(专一特征,如 TBDR beta-barrel 检测器)。
- Panel c(UMAP)是全图最值得关注的面板之一:把所有特征的 dictionary vector 做降维可视化后,功能相关的特征自然聚成簇——kinase 结合位点(绿色区域)、TBDR beta-barrel(蓝色)、ABC transporter(上方)、disordered region(左下)各自形成清晰的聚落。这说明 PLM 的 embedding 空间中,生物概念按功能相似性分区组织,类似 NLP 模型中 word embedding 的语义拓扑。
两个精彩的功能簇案例
Kinase 簇(Panel d–e):三个特征都和 kinase 结合/催化区域相关,但展现出精细的分工。f/9853 倾向于催化 loop 前方的保守二级结构元素;f/8704 集中在 catalytic loop 本身;f/3281 对 pseudokinase 失活域更敏感。Panel e 进一步展示了三者在同一段 kinase 序列上的激活值——它们在相同区域有部分重叠,但各自的峰值位置不同。这揭示了模型内部存在层级化概念表示:上位概念”kinase”下分化出了亚型、局部结构、功能状态等子概念。
Beta-barrel / TBDR 簇(Panel f–g):f/1503 是精确的 TBDR 检测器(F1 = 0.998,几近完美),f/2469 识别更广义的跨膜糖通道 beta-barrel(Precision=0.74),f/9564 对应未完全表征的 beta-barrel 结构。三个特征在 embedding 空间中邻近,形成了一个从”广义 beta-barrel”到”特异 TBDR”的概念特异性梯度。
Figure 4 · LLM 自动解释蛋白特征
这张图想回答:能否自动化地给上万个特征生成可靠的文字描述?
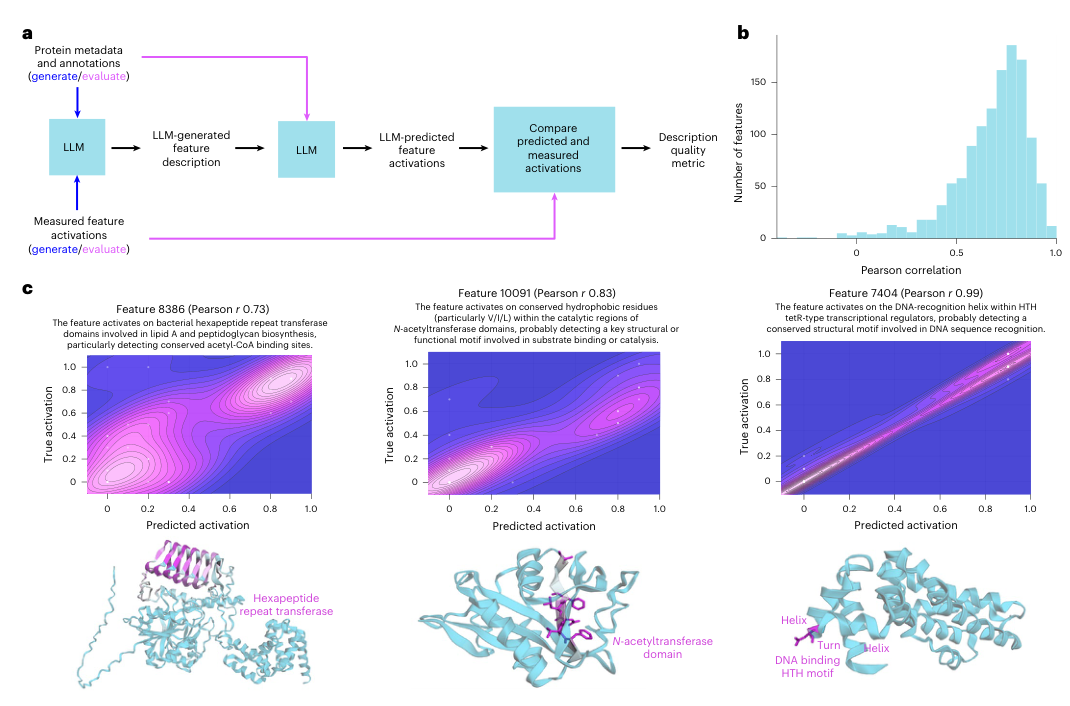
Figure 4. (a) LLM 标注与验证流程。(b) 1,240 个特征的 Pearson r 分布。(c) 三个代表性案例及其密度图。
为什么需要 LLM 自动标注
Swiss-Prot 注释只能覆盖不到 20% 的 SAE 特征。剩下的 80% 怎么办?让人类专家逐个手工解释上万个特征显然不可行。作者设计了一套巧妙的 LLM 管线(Panel a):
- 生成阶段:给 Claude-3.5 Sonnet 提供一批蛋白的元信息(物种、功能、结构域注释)和该特征在这些蛋白上的激活模式(哪些残基激活、强度如何),让 LLM 写出特征的文字描述和一句话摘要。
- 验证阶段:把生成的描述和一批新蛋白的元信息(但不告诉激活值)交给 LLM,让它基于描述预测特征在新蛋白上的激活强度。预测值与真实值的 Pearson 相关系数 r 就是描述质量的客观衡量。
- Panel b 显示 1,240 个特征的中位 r = 0.72,相当多特征的 r 超过 0.8。这意味着 LLM 写出的特征描述不只是”看着合理”,而是具有真实的预测能力——给它一个没见过的蛋白,根据描述就能大致猜对特征会在哪里激活。
当然,r=0.72 虽然很强,但不意味着每个描述在语义上都完全正确。LLM 可能会做”事后合理化”——根据案例编出看起来合理的故事。但作为一个扩展性方案,这种自动标注极大地降低了解释大规模特征集的门槛。
Figure 5 · 发现数据库缺失注释
这张图想回答:SAE 特征的”假阳性”到底是模型错了还是数据库漏了?
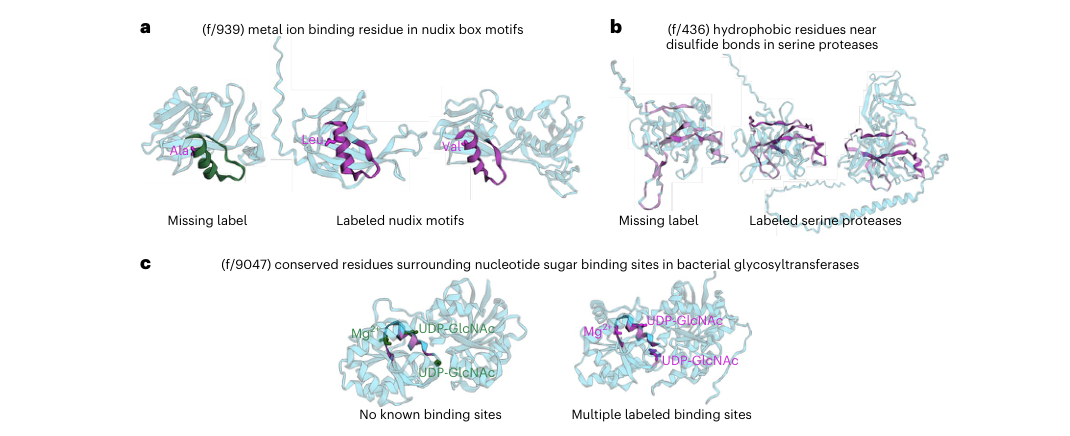
Figure 5. (a) Nudix motif 缺失注释。(b) Peptidase S1 domain 缺失注释。(c) 跨远缘糖基转移酶家族的保守结合位点。
从”解释模型”到”发现生物学”
这是文章最具应用价值的部分。作者发现,很多被 SAE 特征强烈激活但在 Swiss-Prot 中缺少注释的蛋白,经 InterPro 等独立数据库验证后确实应该有该注释——也就是说,这些”假阳性”其实是数据库的真实漏标。
- Panel c(糖基转移酶)最令人印象深刻。特征 f/9047 能跨越多个 UDP 依赖型糖基转移酶家族,精确识别围绕核苷酸糖和 Mg²⁺ 的保守结合位点架构。这些蛋白之间的序列同源性仅 11–22%(传统序列比对几乎无法关联它们),但结构 TM-score 达到 0.74–0.78。这意味着 PLM 学到的特征能穿越序列空间的鸿沟,直接捕捉深层的结构-功能保守性——这是基于序列比对的传统注释管线很难做到的。
这个发现传递了一个重要信号:SAE 特征可以成为一种全新的功能注释信号源,补充甚至超越传统的序列同源性方法。
Figure 6 · 因果干预:steering 控制序列预测
这张图想回答:这些特征是否真正参与了模型的计算过程?能否因果性地影响模型输出?
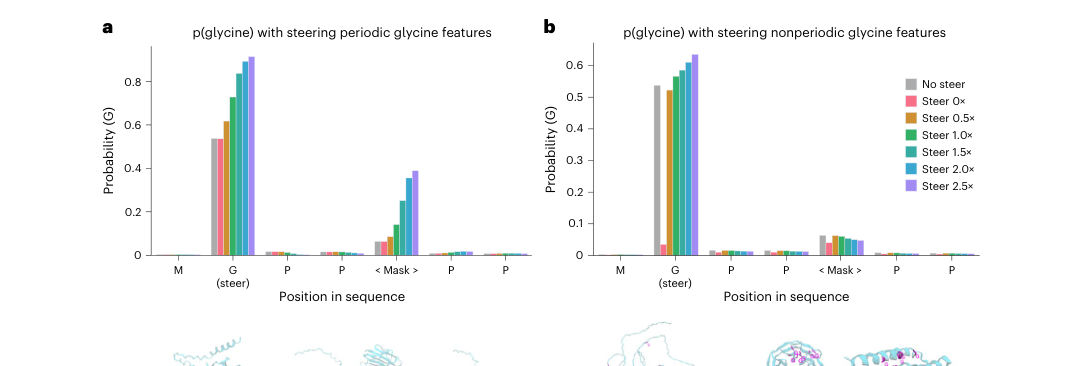
Figure 6. (a) 激活周期性 glycine 特征后模型预测变化。(b) 对照:非周期性 glycine 特征的效果。
从相关性到因果性
前面的所有分析——特征与注释的 F1 匹配、LLM 描述的预测力——本质上都是相关性证据。一个特征和某个生物概念高度相关,不等于模型在做预测时真的”使用”了它。要回答因果性问题,需要做干预实验。
作者选择了胶原蛋白中的周期性 glycine 重复模式(GXXGXX…)作为测试场景。在 ESM-2 的前向传播过程中,他们在某一层把第一个 glycine 位置上三个”周期性 glycine 特征”的激活值强行 clamp 到不同强度(0× 到 2.5× 最大观测值),然后让模型继续计算,观察序列”MGPP<Mask>PP”中各位置预测 glycine 的概率变化。
- Panel a 的结果非常有说服力:随着 steer 强度增大,不仅直接干预位点(G)的 glycine 概率从 ~0.55 上升到 ~0.9,更关键的是,3 个残基之外的 mask 位点也从接近 0 上升到约 0.4。这说明这些特征编码的是”此处存在周期性 glycine repeat 模式”这个高阶规律,激活它会让模型在整个局部区域都增强对 glycine 的预测。
- Panel b 是精心设计的对照:作者选择了对 glycine 氨基酸本身 F1 分数最高的”非周期性”特征来做同样的干预。结果是只有直接干预位点受影响,远处位置几乎不变。这个对比证明了”周期性 glycine 特征”和”glycine 字母特征”是两种不同层次的表示——前者是高阶序列模式,后者只是单点的氨基酸身份。
四、核心贡献总结
综合来看,这篇文章建立了一个从拆解到评估、从描述到应用的完整研究闭环:
1. 证明了 PLM 中 superposition 的普遍存在
单个 ESM-2 神经元是多义的,一个神经元混装了多个生物概念。SAE 能把这些混合表示拆成更纯净的特征。重要的是,这个现象在更大的模型中仍然存在——模型扩大带来的是概念容量的增加,而非单神经元可解释性的提升。
2. 提出了系统化的蛋白特征评估框架
433 个 Swiss-Prot 概念 + domain-adjusted F1 指标 + 随机权重对照 + 跨模型规模验证 + LLM 自动标注管线。这套框架把蛋白特征的可解释性研究从零星的 case study 推进到了可量化、可比较的标准化评估。
3. 连接了解释性研究与实际生物学应用
SAE 特征可以发现数据库缺失的功能注释(尤其是跨远缘家族的深层保守性),可以通过 steering 因果性地控制模型预测,并通过交互平台 InterPLM.ai 供社区探索。可解释性研究不再只是”理解模型”的学术练习,而是有可能反哺生物学发现的实用工具。
五、局限与展望
这篇文章的证据链完整(定量评估 + 随机对照 + 跨规模验证 + 因果干预),但仍有几个重要的开放问题值得关注:
从特征目录到机制理解还有距离。目前我们知道了”模型里有哪些可解释特征”,但这些特征在 transformer 各层之间如何组合?哪些 attention head 和 MLP 模块参与调用了特定特征?特征之间如何协同完成一次完整的预测?从 feature catalog 走向 circuit-level mechanism 是理解 PLM 最核心的下一步。
评估依赖现有注释体系。Swiss-Prot 和 InterPro 代表的是人类已知的概念框架。那些在多个远缘家族中稳定激活、但目前没有对应注释的特征,才可能是最有趣的”新生物学”方向。如何系统性地挖掘这些未命名特征,是后续研究的关键挑战。
Steering 还很初级。目前只在简单的周期性序列模式上验证了因果干预。能否通过 steering 控制更复杂的蛋白性质——如结合特异性、溶解性、热稳定性、催化活性——是从”解释 PLM”迈向”用 PLM 做可解释蛋白设计”的关键跨越。
更大、更新的 PLM 值得探索。ESM-3、ProGen2 等更大的模型,以及序列-结构-功能多模态模型,是否会涌现更抽象、更功能导向的特征?SAE 本身是否是最佳的分解工具,还是 TopK SAE、层级字典学习等变体能做得更好?这些方向都值得持续追踪。
通讯作者介绍
本文通讯作者 James Zou 是 Stanford University 生物医学数据科学系(Department of Biomedical Data Science)副教授,同时在计算机科学系和电气工程系任职。他本科毕业于剑桥大学数学系,随后在 Harvard University 获得博士学位,在 Microsoft Research 完成博士后研究后加入 Stanford。James Zou 的研究横跨机器学习与生物医学,核心方向包括 AI 可解释性、计算基因组学、蛋白质语言模型和 AI 公平性。近年来他的团队在蛋白语言模型的解释与应用方面产出了多项重要工作,包括本文的 InterPLM 框架以及广受引用的 PLM 综述(Nat Methods 2024)。第一作者 Elana Simon 是 Stanford University 在读博士生,研究方向为蛋白语言模型的机制可解释性。
引用
Simon, E., & Zou, J. (2025). InterPLM: discovering interpretable features in protein language models via sparse autoencoders. Nature Methods, 22(10), 2107-2117. https://doi.org/10.1038/s41592-025-02836-7