
Bish-Bash-Fold: What are protein structure prediction models learning?
原文链接:全文
作者:Soo-Jeong Kim, Carlos Vonessen, Robert D Finn
ICML 2026 Workshop on Generative and Agentic AI for Biology,2026 年
AlphaFold3 和 Boltz-2 在蛋白结构预测上表现出色,但它们的扩散模块(diffusion module)内部到底在做什么?输入一组条件信号,输出三维坐标——中间经历的 200 步去噪过程,模型的”大脑”里在想什么?
剑桥大学与 EMBL-EBI 的研究者(以及一位独立贡献者)用稀疏自编码器(SAE)打开了这个黑箱。他们发现:扩散模块内部编码了丰富的可解释生物学特征;AF3 和 Boltz-2 虽然架构相近,走的却是完全不同的 denoising 路径;AF3 有更强的”模型先验”,即使输入信号被破坏也照样运转——这可能意味着某种 hallucination;更关键的是,这些内部特征能比 pLDDT 更准确地预测 de novo 蛋白的实验成败。
「拆开蛋白折叠 AI 黑箱」系列第二篇。上一篇我们讲了 InterPLM 用 SAE 解析蛋白语言模型 ESM-2 的内部特征。这一篇更进一步——进入结构预测模型最核心的扩散模块。
一、研究问题
当前最强的蛋白结构预测模型——AlphaFold3、Boltz-2、Chai-1——共享一个两阶段架构:
阶段一:Trunk / Pairformer
处理输入序列和 MSA(多序列比对),提取共进化信号,生成 single representation 和 pair representation。这一步完成的是”理解蛋白序列中蕴含的结构信息”。
阶段二:Diffusion Module
以上游的 single/pair 表征为条件,从随机噪声出发,通过数百步逐步去噪(denoising),最终输出三维原子坐标。这一步完成的是”把抽象的序列理解变成具体的空间结构”。
对于天然蛋白,这套系统效果很好——因为有深厚的 MSA 支撑,模型能从共进化信号中准确推断残基接触。但对de novo 设计蛋白来说,问题来了:
设计蛋白是人造的、全新的,没有进化历史,因此缺乏 MSA/共进化信号。这会把设计蛋白推到结构预测模型的”失效区间”里。模型可能仍然给出看似合理的结构和高置信度,但实际上存在各种问题——错误手性、立体冲突、本应无序的区域被”硬折成 alpha 螺旋”。
更麻烦的是:扩散模块会把上游 Pairformer 传下来的弱信号继续”合理化”——它会像什么都没发生一样继续去噪、继续生成结构。而常用的置信度指标(如 pLDDT)未必能识别这种”自信地错”。
这就是本文的切入点:扩散模块在去噪的每个时间步,内部表征到底怎么演化?它依赖输入证据(MSA、序列)到什么程度?当证据变差时,模型是在”诚实地降低信心”,还是在”凭先验继续硬折”?
二、方法核心:SAE + 输入消融
2.1 稀疏自编码器(SAE)——拆解扩散模块的内部语言
理解本文方法之前,先回顾一个关键概念:superposition(叠加)。
神经网络的隐层维度是有限的(比如 AF3 扩散 transformer 的 hidden dim),但模型需要表达的概念远多于维度数。怎么办?模型会把多个概念”叠加”编码到同一组神经元里——每个神经元同时参与多个概念的表示。这导致单个神经元的激活很难解释。
SAE 做的事情就是把这些叠加的信号”拆开”。它将原始的稠密激活投射到一个远高于原始维度的稀疏空间,让每个 latent feature 尽可能只对应一个清晰的概念。
TopK SAE 的工作方式
给定输入激活向量 x(某个残基在扩散 transformer 某层的 hidden state):
1. 编码:用编码器将 x 投射到高维空间,然后只保留激活值最大的 k 个维度(TopK 操作),其余置零。这保证了稀疏性——每个残基只由少数几个特征来描述。
2. 解码:用解码器将稀疏的 latent 向量重建回原始空间,得到重建激活。
3. 训练目标:最小化重建误差(MSE),同时用辅助损失防止特征”死亡”(永不激活)。
上一篇系列文章中,InterPLM 把 SAE 应用到蛋白语言模型 ESM-2 的隐层表征上,成功地分离出了对应 binding site、结构 motif、PTM 位点等生物学概念的特征。本文的目标更有挑战性——把 SAE 应用到结构预测模型的扩散模块上。
为什么更有挑战性?因为扩散模块的激活不像 PLM 那样只有一个”快照”,它是随时间步变化的——从噪声到结构的整个去噪轨迹中,内部表征在不断演化。
2.2 具体实验设置
提取位置
AF3 和 Boltz-2 的 diffusion transformer 第 24 层(最后一层),final LayerNorm 前的激活。这是离最终坐标输出最近、信息最浓缩的位置——可以类比为”模型做出结构决定前的最后一瞬间的想法”。
时间步选择
在去噪轨迹上选了 5 个时间步:t = 0, 50, 100, 146, 199,覆盖从高噪声到低噪声(从近乎纯噪声到接近最终结构)的不同阶段。
每个模型每个时间步训练一个独立的 SAE,总共 10 个 SAE(2 个模型 x 5 个时间步)。
训练数据
来自 UniProt 的单结构域蛋白,严格限制为只有一个 Pfam 注释(便于解释特征含义)。共 55,000 条序列,约 1,000 万 token。
为什么限制单结构域?因为多结构域蛋白的特征更复杂,会增加解释难度。先在简单体系上验证方法,是一个合理的起点。
评估指标
1. Explained Variance (EV):衡量 SAE 能还原原始激活到什么程度。AF3 的 EV 在 0.88–0.95 之间,Boltz-2 更高,达 0.96–0.99。
2. Dead features:永远不激活的特征比例。两个模型都接近 0,说明字典利用率很高。
3. 线性 Probe 准确率:用 SAE 特征做线性分类,预测 HELIX、STRAND、DISULFID、ZN_FING 四个已知生物学标签。SAE 特征的分类准确率一致优于同维度 PCA,说明 SAE 学到的是更”概念化”的表示。
2.3 输入消融——分离”证据”与”先验”
SAE 提取出的特征到底是被”输入信号”驱动的,还是模型”自带”的先验知识?为了回答这个问题,作者设计了一组系统的输入消融实验——逐步剥夺模型的输入信息,观察哪些特征消失了、哪些还在。
消融梯度(从信息最丰富到最贫乏)
Full MSA(原始深度约 1000 条序列)
→ MSA 500 → MSA 200 → MSA 100 → MSA 30
→ MSA 0(只剩单条查询序列,无共进化信息)
→ all-X sequence(整条序列都替换成未知氨基酸 X,连序列身份信息也没了)
这个设计的精妙之处在于它能把两种信息来源分开:
减少 MSA 深度(Full → 0):逐步剥离共进化信息。如果一个特征在 MSA 变浅时消失,说明它依赖共进化信号。
all-X 替换:在去掉共进化信息的基础上,进一步剥离序列身份信息。如果一个特征在 MSA=0 时还在但 all-X 后消失,说明它依赖序列本身(而非共进化)。
2.4 四类特征的分类框架
基于消融实验的结果,作者把 SAE 特征分成了四类。这个分类框架是本文最核心的方法学贡献之一:
1. MSA-activated(共进化驱动)
有 MSA 时活跃,去掉 MSA 后消失。这类特征真正依赖共进化信息——它们代表的是模型从 MSA 中学到的结构约束。
2. MSA-silenced(被共进化”压制”)
有深 MSA 时反而不活跃,当 MSA 和 sequence 都被去除后才冒出来。这类特征可能是模型的”默认先验”或补偿性模式——当输入信息充足时它们被抑制,信息匮乏时才启动。
3. Sequence-driven(序列身份驱动)
不受 MSA 深度影响(MSA 从 1000 降到 0 都不变),但 all-X 替换后消失。这类特征靠的是序列本身的氨基酸组成,和共进化无关。
4. Model-prior(模型先验)
所有条件下都活跃——包括 all-X。即使模型收到的是”我完全不知道这是什么蛋白”这种最差的输入,这些特征依然表达。它们体现的是模型在训练过程中学到的内在结构先验,和当前输入完全无关。
这个四分法把模糊的”模型到底靠输入还是靠先验”这个问题,变成了可量化、可比较的分类。接下来我们看具体结果。
三、看图说话
Figure 1 · 扩散模块内部确实编码了可解释的生物学特征
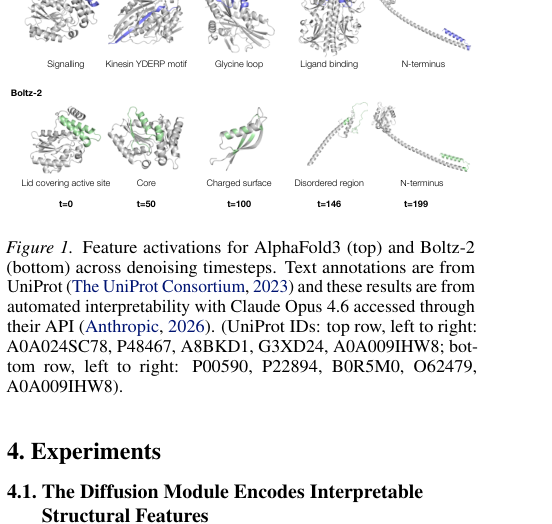
Figure 1. AF3(上排)和 Boltz-2(下排)在不同去噪时间步(t=0 → t=199)的特征激活可视化。彩色区域为 SAE 特征激活位置,文字标签由 LLM 自动标注。
怎么读这张图
每一列对应一个去噪时间步(从 t=0 的高噪声到 t=199 的低噪声)。蛋白结构上的彩色区域就是 SAE 特征在该残基位置的激活。
AF3 提取出的特征包括:信号转导相关区域(Signalling)、驱动蛋白 YDERP motif(Kinesin YDERP motif)、甘氨酸环(Glycine loop)、配体结合位点(Ligand binding)、N 端区域。
Boltz-2 提取出的特征包括:覆盖活性位点的”盖子”结构(Lid covering active site)、疏水核心(Core)、带电表面(Charged surface)、无序区域(Disordered region)、N 端区域。
这些特征的生物学意义明确、可验证——说明扩散模块在去噪过程中,内部确实在编码丰富的蛋白结构、生化和功能信息。尽管 AF3 和 Boltz-2 是独立训练的,它们在 t=199(接近最终输出)时会收敛到相似的特征表示——这暗示结构预测任务本身对模型施加了某种”收敛压力”。
SAE 特征的自动解释由 Claude Opus 4.6 完成(通过检查每个特征在哪些蛋白的哪些位置激活最强,推断其对应的生物学概念)。作者用 UniProt 注释进行了定量验证:SAE 特征对 HELIX、STRAND、DISULFID、ZN_FING 四个标签的线性分类准确率一致优于同维度 PCA。
Figure 2 · AF3 和 Boltz-2 走的是不同的 denoising “思路”
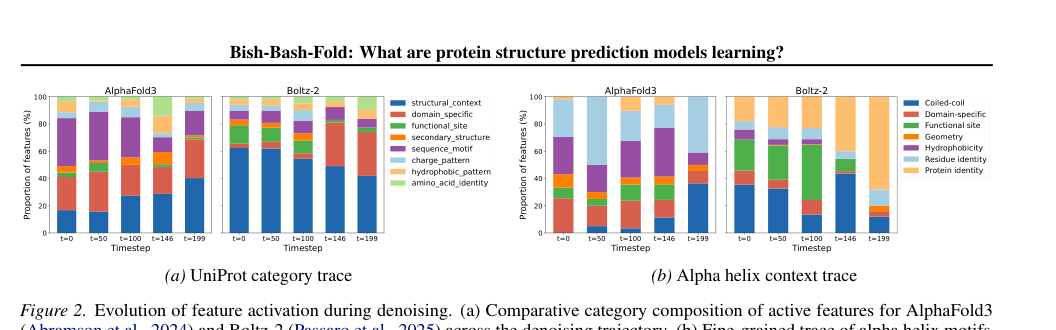
Figure 2. 去噪过程中特征构成的演化。(a) UniProt 八大类别在各时间步的占比变化。(b) 以 alpha helix 为例,追踪构成 alpha helix 表征的细粒度特征如何随时间步变化。
这张图揭示了本文最有趣的发现之一:尽管 AF3 和 Boltz-2 架构相近,它们的 denoising 策略截然不同。
AlphaFold3:从局部到整体的 bottom-up 解析
- Panel (a) 显示,AF3 的类别构成在去噪过程中相对均衡。structural-context(结构上下文)特征随时间逐步上升,sequence-motif(序列模体)在前期更突出。这说明 AF3 先从局部序列/理化信息出发,再逐步放入更高层级的结构上下文。
- Panel (b) 追踪 alpha helix 这个具体例子:AF3 先用 residue identity 和 hydrophobicity 特征,然后 functional-site 特征上升,最后 coiled-coil / 三级结构上下文特征在 t=199 急剧增加。整个过程像是一个逐步搭建的过程。
Boltz-2:早期锁定蛋白身份
- Panel (a) 显示,Boltz-2 的 structural-context 特征随时间反而减少,后期被 domain-specific 和 protein-identity 特征主导。这说明 Boltz-2 更早”认定”输入蛋白属于哪个 domain/家族,然后围绕这个身份来推进结构生成。
- Panel (b) 显示,Boltz-2 从一开始就大量使用 coiled-coil、functional-site、protein-identity 特征,residue identity 和 hydrophobicity 始终只占边缘角色。
打个比方:AF3 像是一位从零件开始组装的工程师——先认清每个零件的材质和尺寸,再逐步放入整体框架;Boltz-2 像是一位先看说明书的工程师——先确定”我在装的是哪个型号”,再按模板推进。两种策略各有优劣,但对 de novo 蛋白来说,后者可能更脆弱——如果”说明书”(domain identity)不存在呢?
Figure 3 · 输入消融揭示四类特征的分布
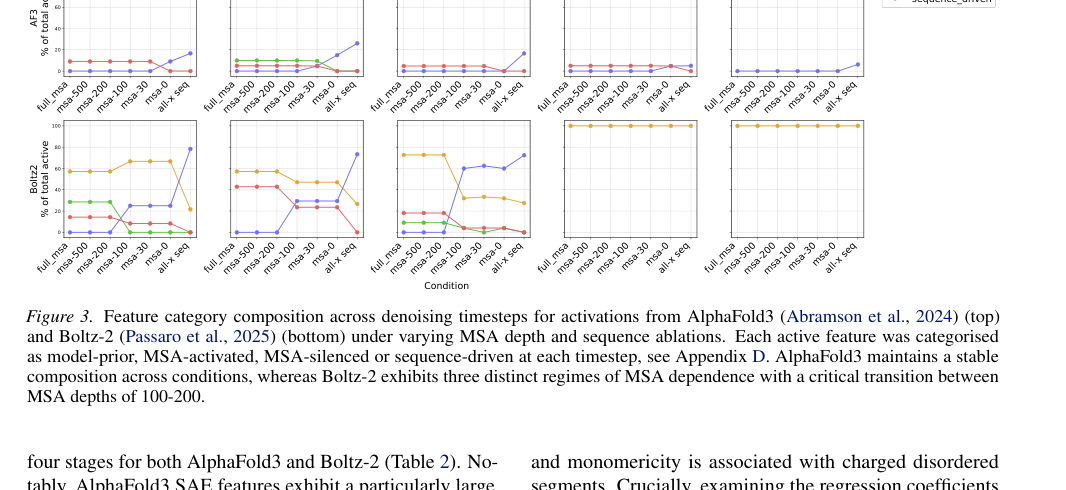
Figure 3. 不同 MSA 深度和序列消融条件下,AF3(上排)和 Boltz-2(下排)的特征类别构成。五列分别对应 t=0, t=50, t=100, t=146, t=199。四种颜色对应 model-prior(蓝)、MSA-activated(橙)、MSA-silenced(绿)、sequence-driven(红)。
这张图是本文的核心结果图,信息密度很高。关键要看的是两件事:
发现一:AF3 有更强的模型先验
AF3(上排)在各种输入条件下,特征类别构成几乎不变——无论 MSA 深度从 1000 降到 0,甚至替换成 all-X,蓝色的 model-prior 特征始终占据高比例。
这说明AF3 的扩散模块对输入证据的变化不太敏感——它有一套强大的内部先验,面对再贫乏的输入也能继续推进某种结构化表示。
发现二:Boltz-2 有三个清晰的 MSA 依赖区间
Boltz-2(下排)对输入变化要敏感得多。作者识别出三个区间:
- Deep MSA(MSA ≥ 200):稳定的一种特征模式
- Shallow MSA(0 < MSA < 200):特征构成开始明显变化
- Information-free(all-X):切换到完全不同的模式
发现三:MSA 信息主要在早期时间步整合
对两个模型都成立:t = 0–100 阶段 MSA 影响更明显,t = 146 和 199 阶段对 MSA 的依赖反而较弱。也就是说,共进化信息主要在 denoising 早期被整合,后期步骤更多是在已有表征基础上继续生成。
还有一个值得注意的现象:图 2a 中 sequence-motif 类特征占比很高,但图 3 中被判定为 sequence-driven 的特征却很少。这说明很多”看起来在表达序列/模体概念”的特征,实际上在输入被破坏后仍然继续激活——它们的表达与输入质量”脱钩”了。作者推测,这可能是hallucination 的一种表现:去噪器像是在基于”假定输入有效”的内部图景继续折叠,即使实际输入已经没有信息了。
Figure 4 + Table 2 · 内部特征预测实验成败优于 pLDDT
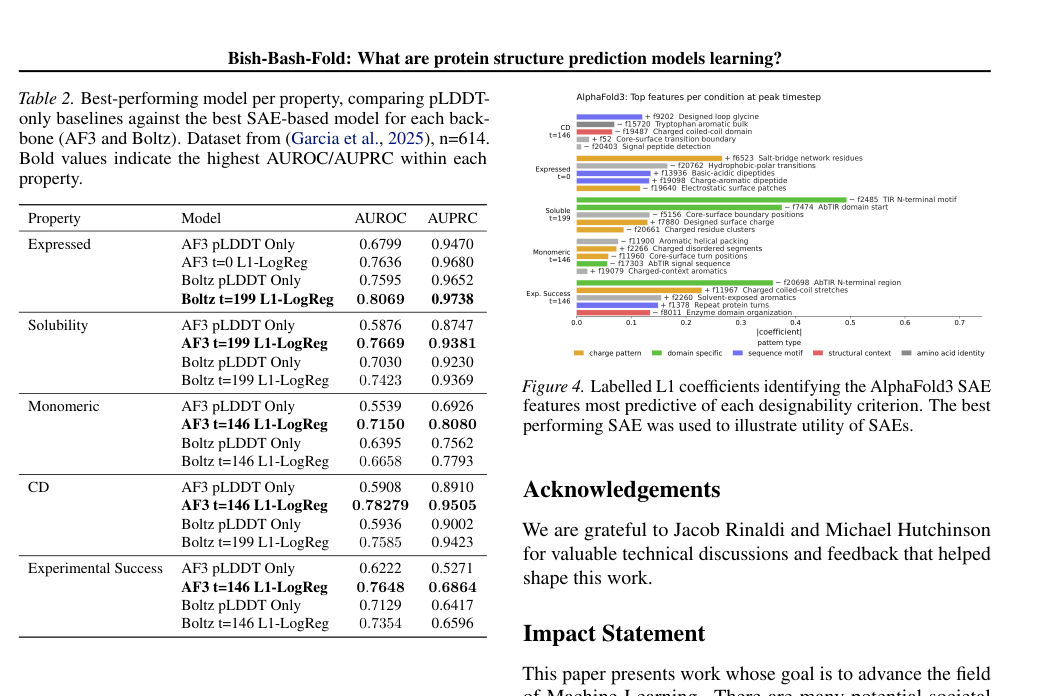
Figure 4(右)+ Table 2(左). 左:SAE 特征探针 vs pLDDT 在预测设计蛋白实验结果上的 AUROC/AUPRC 对比。右:逻辑回归系数最大/最小的 SAE 特征,揭示哪些内部表征驱动了实验成败预测。
这是本文在应用层面最亮眼的结果。作者用 Garcia et al. (2025) 的 de novo 蛋白数据集(614 个设计蛋白),预测四个实验指标:表达(expression)、可溶性(solubility)、单体性(monomericity)、圆二色谱(CD),以及总体实验成功率。
方法很简洁:用 mean-pooled SAE features 训练一个L1 正则化逻辑回归,对比基线是只用 pLDDT。结果非常明确:
| 实验指标 | AF3 pLDDT | AF3 SAE | Boltz-2 pLDDT | Boltz-2 SAE |
|---|---|---|---|---|
| 表达 | 0.680 | 0.764 | 0.760 | 0.807 |
| 可溶性 | 0.588 | 0.767 | 0.703 | 0.742 |
| 单体性 | 0.554 | 0.715 | 0.640 | 0.666 |
| 圆二色谱 | 0.591 | 0.783 | 0.594 | 0.759 |
| 总体成功 | 0.622 | 0.765 | 0.713 | 0.735 |
AUROC 数值,加粗红色为 SAE 优于 pLDDT 的部分。数据来源:Table 2。
SAE 特征探针在所有指标、两个模型上都优于 pLDDT。提升幅度在 AF3 上尤其显著——可溶性的 AUROC 从 0.588 跳到 0.767,圆二色谱从 0.591 跳到 0.783。
为什么内部特征比 pLDDT 更有用?背后的直觉其实很朴素:pLDDT 是模型对”预测结构是否正确”的自我评估,它关注的是几何准确性。但一个蛋白在实验中能否表达、是否可溶、能否正确折叠,依赖的因素远比几何准确性更复杂——包括表面电荷分布、疏水核心打包质量、界面特征等。这些信息可能就编码在模型的内部表征中,但 pLDDT 并不反映它们。
图 4 进一步揭示了哪些具体的 SAE 特征在驱动这些预测:
圆二色谱(CD,反映正确折叠)
正相关:core-surface boundary(核心-表面过渡)、设计 loop 特征
负相关:bulky aromatics(笨重芳香残基)
表达
正相关:salt-bridge network residues(盐桥网络残基)
负相关:localized electrostatic patches(局部化的静电区域)、信号肽检测特征
可溶性
主要由 surface charge(表面电荷)和 N-terminal motif(N 端基序)驱动——与经验法则一致。
总体实验成功
强相关于 charged coiled-coils(带电卷曲螺旋)、solvent-exposed aromatics(溶剂暴露的芳香残基)、repeat-protein turns(重复蛋白转角)。
这些从回归系数中”浮现”的设计启发式,与蛋白工程领域的经验法则高度吻合。结构预测模型内部已经隐式学会了一些蛋白设计的实用规则——只是这些规则从来没有通过标准输出(pLDDT、预测结构)被暴露出来。
四、核心贡献总结
发现 1:扩散模块内部编码了丰富的可解释生物学特征
SAE 从扩散 transformer 的激活中提取出对应残基电荷、二级结构、功能位点、配体结合、motif、无序区域、核心/表面边界等明确概念的特征。扩散模块在 denoising 过程中,内部做的远比”往坐标上加噪去噪”复杂得多。
发现 2:AF3 和 Boltz-2 的 denoising 策略截然不同
AF3 是 bottom-up 的:先从局部氨基酸理化性质出发,逐步嵌入到更高层级的结构上下文。
Boltz-2 是 identity-first 的:更早确定蛋白/domain 身份,围绕已知身份推进结构生成。
发现 3:AF3 有更强的模型先验,可能存在 hallucination 风险
即使输入信号被大幅削弱甚至清零,AF3 的大部分特征仍然继续表达。Boltz-2 对输入变化更敏感。
AF3 的强先验是一把双刃剑:在弱 MSA 条件下仍能输出有组织的表征(优势),但也可能在证据不足时”自信地产生错误结构”(风险)。作者谨慎指出,这里的证据是 feature expression 层面的——特征持续表达意味着模型持续运转,但最终结构是否正确还需要结合 RMSD、PoseBusters 等指标验证。
发现 4:内部特征比 pLDDT 更能预测 de novo 蛋白实验成败
在表达、可溶性、单体性、CD、总体成功率五个指标上全面胜出。这说明模型内部表征中存在标准输出未暴露的设计性信息,pLDDT 遗漏了大量有价值的信号。
发现 5:从回归系数中能回收到合理的蛋白设计启发式
core-surface boundary 正相关折叠质量、表面电荷正相关可溶性、盐桥网络正相关表达——这些与蛋白工程的经验法则高度吻合,说明结构预测模型内部已经”学会了”这些规则。
五、局限与展望
对蛋白设计的三点启发
1. pLDDT 作为设计性代理指标的局限性已经明确。如果你在做 de novo 蛋白设计的筛选流程,只看 pLDDT/self-consistency 是不够的。模型内部”知道”一些 pLDDT 没有暴露的东西——表面电荷分布、核心-表面过渡、芳香残基堆积质量等。这些信息可以通过 SAE 特征提取出来,作为更全面的筛选指标。
2. AF3 和 Boltz-2 的行为差异对实际使用有指导意义。AF3 的强先验意味着它在面对 de novo 蛋白(无 MSA)时仍然会”自信地”输出结构。这未必是坏事——它的内部特征对实验成功的预测力反而更强。但也意味着你需要更警惕它的输出。Boltz-2 对输入更敏感,可能在 MSA 可用时更可靠,但面对 de novo 条件时内部表征会发生更大变化。
3. 未来最令人兴奋的方向是”design steering”。如果我们能把这些内部特征当作优化目标——强化正向 designability 特征、惩罚负向特征——就有可能直接在结构预测模型的内部表征上做设计优化,而非仅依赖输出端的 pLDDT。这可能比现有的 self-consistency 或 MPNN 重设计流程更高效、更有针对性。
需要注意的局限
本文是一篇开路型工作,还有不少限制需要后续解决:
分析范围有限——只看了 5 个时间步、一个 transformer 层、单结构域蛋白。对多结构域蛋白、多链复合物、binder 设计等更复杂的场景能否泛化,还不清楚。
特征的自动命名由 LLM 生成,存在误差。这些 label 应视为启发式解释,而非金标准的生物学注释。
预测 designability 仍然是相关性层面的证据。SAE 特征能预测实验成功,但不等于这些特征就是因果因素。要真正用于设计 steering,还需要做 intervention 实验验证。
没有系统评估 feature 变化与最终结构质量(RMSD、steric clash、chirality error)之间的关系。这是从”可解释”走向”故障诊断”最关键的缺失环节。
通讯作者介绍
本文的第一作者兼通讯作者是 Soo-Jeong Kim(剑桥大学与 EMBL-EBI),另两位作者是 Carlos Vonessen(独立贡献者)和 Robert D. Finn。Finn 现任欧洲分子生物学实验室欧洲生物信息学研究所(EMBL-EBI)的研究组长和团队负责人,领导 Protein Function Development 团队。他是蛋白质生物信息学领域的标志性人物之一,长期负责维护和开发 Pfam(蛋白质家族数据库)和 InterPro(蛋白质功能整合注释平台)这两个全球使用最广泛的蛋白质注释数据库。Finn 教授在 Washington University in St. Louis 取得博士学位,研究方向涵盖蛋白质功能注释、比较基因组学、序列分析方法开发。近年来,他的团队积极将 AI/ML 方法引入蛋白质注释工作流,本文即是这一方向的最新成果——用可解释性工具反过来理解 AI 蛋白结构预测模型学到了什么。
引用
Kim, S. J., Vonessen, C., & Finn, R. D. (2026). Bish-Bash-Fold: What are protein structure prediction models learning?. ICML 2026 Workshop on Generative and Agentic AI for Biology. https://openreview.net/forum?id=ogUnDI1Qqp