
AlphaInterp: Mechanistic Interpretability of AlphaFold 3 Reveals How Evolutionary Information Shapes Protein Structure Prediction
原文链接:全文
作者:Jonathan Feldman, Jeffrey Skolnick
bioRxiv,2026 年 5 月 29 日
「拆开蛋白折叠 AI 黑箱」系列 #1
AlphaFold 3 预测蛋白质结构的精度已经令人叹服,但它内部到底学到了什么?是真正掌握了序列到结构的物理规律,还是在依赖某种更具体的输入信号?
Georgia Tech 的 Feldman 与 Skolnick 用 linear probing、activation patching、MSA 消融三板斧,对 AF3 四个内部 checkpoint 做了系统性的机制可解释性分析。核心发现:AF3 的结构推理高度依赖 MSA 提供的进化脚手架——Pairformer 将分散的共进化信号压缩成紧凑的结构潜空间,去掉 MSA 后这个空间会塌缩、预测精度暴跌。更关键的是,真正重要的是同源序列的系统发育多样性,5-10 条合适分化的序列就能恢复大部分性能。
一、研究问题
AlphaFold 3 在蛋白质结构预测上取得了突破性成功,但作者追问的是更深层的问题:
AF3 内部到底编码了什么?
哪一层开始出现结构信息?是 single representation(每个残基一个向量)更重要,还是 pair representation(每对残基一个向量)更重要?
MSA 在内部表征形成中起什么作用?
多序列比对(MSA)只是锦上添花地提升一点精度,还是决定了整个结构潜空间能否成立?
突变不敏感(mutational invariance)来自哪里?
很多明显破坏性的突变,AF3 预测的结构却几乎不变。这是输出模块的问题,还是内部表征本身就”锁死”了?
AF3 是否真学到了一般性的物理规律?
如果真正掌握了”序列到结构”的物理因果关系,那对新蛋白、强突变、fold-switching 蛋白应该同样稳定。如果主要靠进化模板式线索,那遇到缺少进化支撑的情况就会崩溃。
二、方法核心:四个 Checkpoint + 三套实验
AlphaInterp 的方法框架可以概括为:在 AF3 的四个关键内部节点上,用三套互补的实验手段拆解信息流。
2.1 四个内部 Checkpoint
作者从 AF3 的前向传播中抽取了四个关键位置的表示:
Checkpoint A:初始序列表示完成后,MSA 信息尚未深度整合
Checkpoint B:MSA 模块处理完毕、Pairformer 之前
Checkpoint C1:第一次 Pairformer 完成后
Checkpoint CN:最后一次 recycling 后、扩散模块之前
在每个 checkpoint,同时提取两类表示:single representation(每个残基一个向量)和 pair representation(每对残基一个向量)。pair representation 更直接承载几何关系,也是本文分析的重点。
2.2 实验一:Linear Probing——”这层表示里存了什么?”
在每个 checkpoint 的 single/pair representation 上训练线性预测器,尝试预测多种生物物理特征:
- 全局指标:pTM(模型自身置信度)、TM-score(与真实结构的吻合度)
- 残基级特征:二级结构、溶剂可及表面积(SASA)、burial depth
- 残基对特征:contact map、残基对距离(Cα-Cα distance)
这里的逻辑很直接:如果一个生物物理特征能被线性预测器从某层表示中读出来,说明该特征在这一层已经以比较”显式”的方式编码了。从 A 到 CN 逐步观察,就能勾画出信息在 AF3 内部逐层富集的过程。
2.3 实验二:Activation Patching——”这些信息因果上参与计算了吗?”
Linear probing 回答的是”信息存在与否”,但”存在”和”被模型主动使用”是两回事。Activation patching 做的是因果推理:
方向操控(PCA 推移)
在 CN 的 pair representation 上做 PCA,识别出捕获最大方差的主成分方向。然后沿某个主成分方向推动 embedding,观察下游 distogram entropy(几何不确定性的度量)是否系统性地升高或降低。如果某个主成分方向能系统性改变几何确定性,说明潜空间中确实存在控制”结构置信度”的轴。
跨蛋白移植
更激进的测试:把一个”预测极其成功”的蛋白的 CN pair representation 片段,移植到完全无关的低质量蛋白上。如果下游 distogram 的不确定性因此大幅降低,就说明这种”结构确定性”编码具有跨蛋白的可迁移性——它是一种抽象的几何语言,而非特定序列的记忆。
2.4 实验三:MSA 消融——”进化信息到底多重要?”
这是全文最核心的一组实验。作者设计了多层次的 MSA 扰动,精细地拆解 MSA 中哪些成分对 AF3 最关键:
- 完全去掉 MSA:只保留单条 query 序列
- 行下采样:保留 MSA 结构,但随机移除部分序列(降低深度)
- 列打乱:保留每列边缘分布,但破坏列间协同进化统计
- 系统发育分层:只保留近缘(>80%)/ 中等(50-70%)/ 远缘(<30%)同源序列
- 假 MSA 注入:用完全无关蛋白的序列替换真实 MSA(负对照)
这套实验的精妙之处在于层层递进:完全去掉 MSA 回答”重要吗?”,行下采样回答”需要多深?”,列打乱回答”需要精确共变统计吗?”,系统发育分层回答”哪类同源序列最有用?”,假 MSA 回答”模型只看格式还是真读进化信息?”
2.5 Benchmark 数据集
- 主数据集 400 个单体蛋白:Novel 200(与训练集同源性 <30%)+ Similar 200(不限同源性),均在 AF3 训练截止后发表
- SABmark:序列差异大但结构相似的蛋白,测试 fold recognition 能力
- Fold-switching proteins:序列相似但实验上可采用不同折叠的蛋白
三、看图说话
Figure 1 · AF3 内部表征的自洽性与信息结构
这张图想回答:从输入到输出,AF3 内部的结构信息是如何逐步建立的?MSA 在这个过程中扮演什么角色?
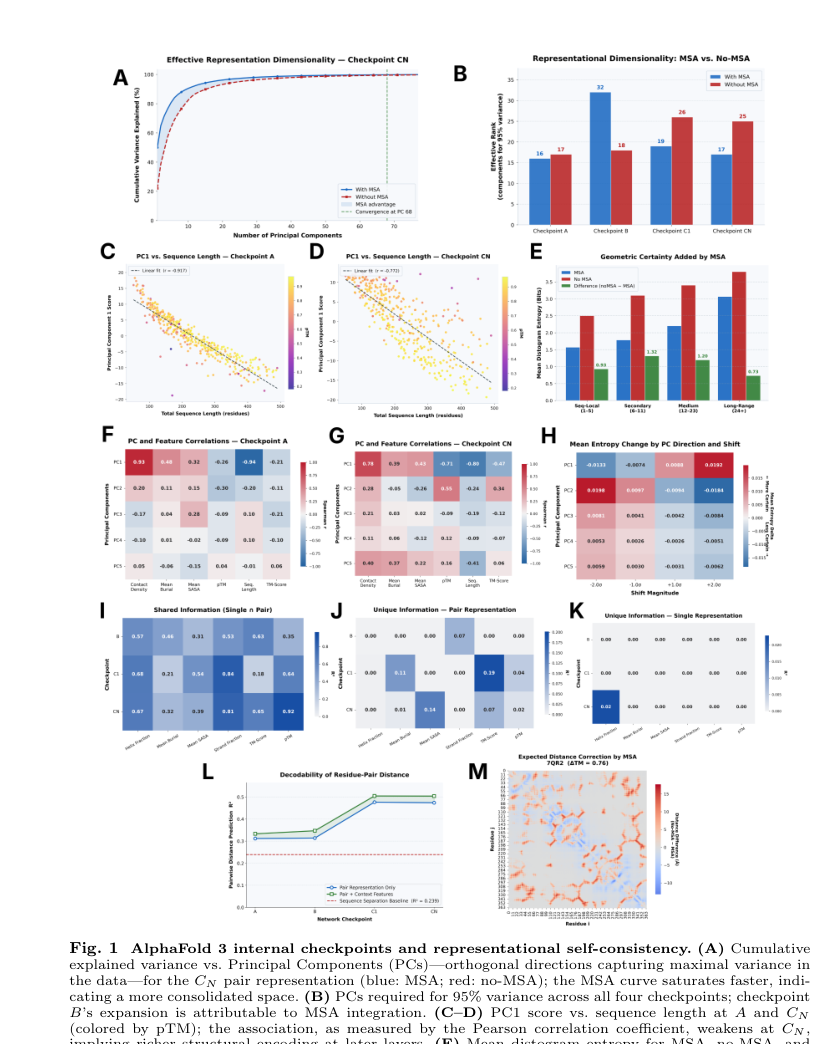
Figure 1. (A) CN checkpoint pair representation 的累积方差解释与主成分数关系。(B) 各 checkpoint 达到 95% 方差解释所需的主成分数。(C-D) PC1 与序列长度在 A 和 CN 处的相关性变化。(E) MSA 在不同 sequence separation 上增加的几何确定性。(F-G) PCA 主成分与结构特征的相关矩阵。(H) 沿 PCA 方向做 activation patching 对 distogram entropy 的影响。(I-K) single/pair representation 的共享与独有信息。(L) 残基对距离的可线性解码性逐层增长。(M) 距离校正可视化案例。
怎么读这张图
- Panel A-B 揭示了 MSA 对潜空间维度的影响。有 MSA 时(蓝线),pair representation 的方差在较少主成分上就饱和(更紧凑);无 MSA 时(红线)方差更分散。具体地,Checkpoint B 达到 95% 方差需要 32 个主成分(有 MSA)vs 18 个(无 MSA)——MSA 注入后空间先膨胀;到 CN,Pairformer 又把信号压缩回更紧凑的结构流形。
- Panel C-D 展示了一个有趣的变化:在 Checkpoint A,PC1 与序列长度高度相关(r = 0.917);到 CN,这种相关性大幅减弱(r = 0.773),点云按 pTM 着色后呈现明显的质量梯度。这说明 Pairformer 把潜空间从”编码基本序列属性”转化为了“编码结构质量”。
- Panel E 量化了 MSA 增加的几何确定性:MSA 在所有 sequence separation 上都降低了 distogram entropy(几何不确定性),残基对间隔为 6–23 个位置时熵增最大,其他间隔上也保持较高水平。这意味着 MSA 的核心贡献在于帮助模型建立中远程的空间约束。
- Panel F-G 是 PCA 主成分与结构特征的相关矩阵对比。Checkpoint A 时 PC1 主要与 contact density 和 mean burial 相关(基本的拓扑属性);PC1 与 pTM 的 Spearman 相关系数约为 −0.71,与 contact density 的相关性同样很强——潜空间已经高度组织成”与结构质量直接相关”的几何空间。
- Panel H 是 activation patching 的结果:沿 PC2 推移 embedding,distogram entropy 平均降低约 0.0198,证明潜空间中确实存在可操控的”几何确定性/不确定性”维度。
- Panel I-K 分析了 single 与 pair representation 的信息分配。关键发现:结构信息几乎全部存在于 pair representation。Pair 独有信息中,contact density、mean burial、pTM 等都很高(Panel J),而 single 的独有信息几乎为零(Panel K)。
- Panel L 追踪了 Cα-Cα 距离的可线性解码性:R2 从 A 的 0.311 稳步增长到 CN 的 0.474(加局部上下文后 0.504)。这条持续上升的曲线直观地展示了 Pairformer 逐步把分散的进化线索整合为可解码的几何关系的过程。
Figure 3 · 突变不敏感:内部表征还是输出假象?
这张图想回答:AF3 对强破坏性突变”视而不见”的现象,根源在内部表示还是在最终输出?MSA 是否在维持这种稳定性?
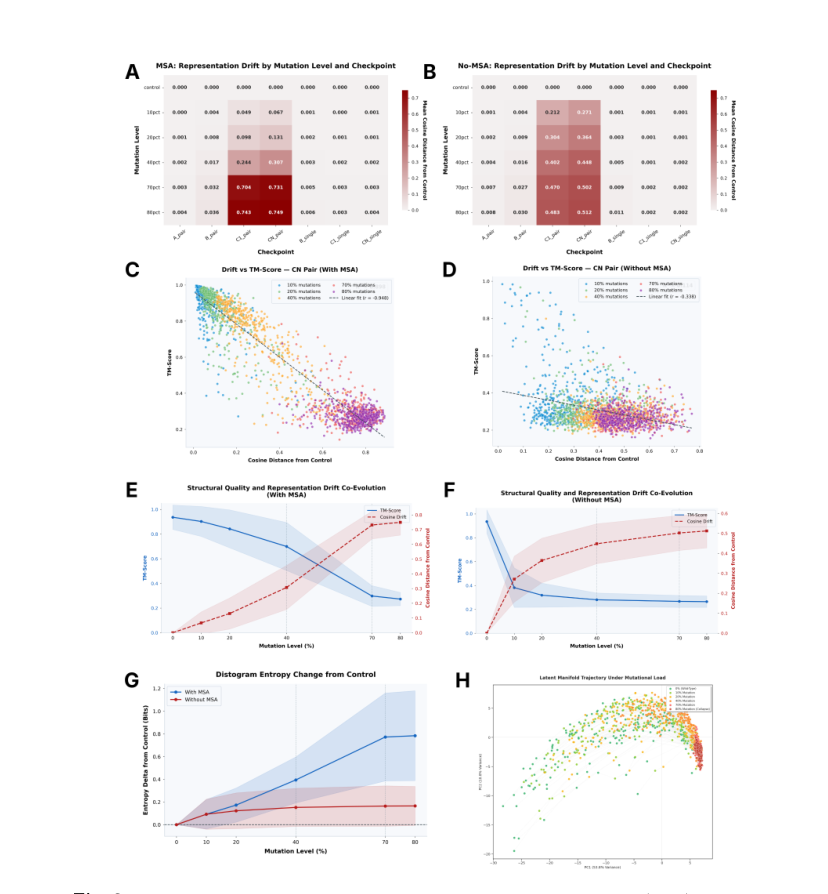
Figure 3. (A-B) 有/无 MSA 时各 checkpoint 的表征漂移热力图。(C-D) CN pair representation 漂移与 TM-score 的散点图。(E-F) 突变水平与结构质量/表征漂移的共演化。(G) Distogram entropy 随突变水平的变化。(H) 潜空间中的突变轨迹 PCA 可视化。
怎么读这张图
- Panel A-B 是两张热力图,横轴是 checkpoint(从 A 到 CN),纵轴是突变水平(10%-80%),颜色表示与控制组(未突变)的 cosine distance。关键对比:有 MSA 时(Panel A),表征漂移集中在 C1/CN 阶段,且只在 70-80% 突变时才变得显著(deep red,CN pair 处 cosine distance 达 0.749);无 MSA 时(Panel B),10% 突变就引起 C1 pair 明显漂移(0.364),之后趋于平台。
- Panel C-D 是最直观的散点图。有 MSA 时(Panel C),CN pair 漂移与 TM-score 的负相关极其紧密——Pearson r = -0.948,几乎是线性关系。这个数字意味着:结构不变,恰恰是因为内部 pair representation 本身就没怎么变。无 MSA 时(Panel D),相关性仍在(r = -0.338)但远弱于有 MSA,且整体 TM-score 已经很低。
- Panel E-F 追踪了随突变水平增加的两条曲线:蓝色是 TM-score,红色是 cosine drift。有 MSA 时(Panel E),TM-score 到 40% 突变仍维持在较高水平,之后加速崩塌——cosine drift 同步上升,二者几乎镜像。无 MSA 时(Panel F),TM-score 一开始就低,10% 突变就有明显漂移,之后结构”没什么可再失去”。
- Panel G 揭示了一个有趣的不对称:有 MSA 时,distogram entropy 随突变水平持续稳步上升(蓝线),说明模型在逐步”感知”到序列被破坏,只是变化缓慢;无 MSA 时,entropy 从一开始就高,之后变化趋平——模型在无 MSA 时已经处于高不确定性状态。
- Panel H 是潜空间轨迹的 PCA 可视化。每个点代表一个蛋白在某个突变水平下的 CN pair representation,颜色从绿(低突变)到红(高突变)。可以看到突变轨迹在潜空间中形成一条连贯的”漂移路径”,MSA 的存在使这条路径更短更紧凑。
Figure 4 · MSA 扰动:行下采样 vs 列打乱
这张图想回答:AF3 依赖 MSA 的哪些信息——是序列数量(深度)?还是列间的协同进化统计?
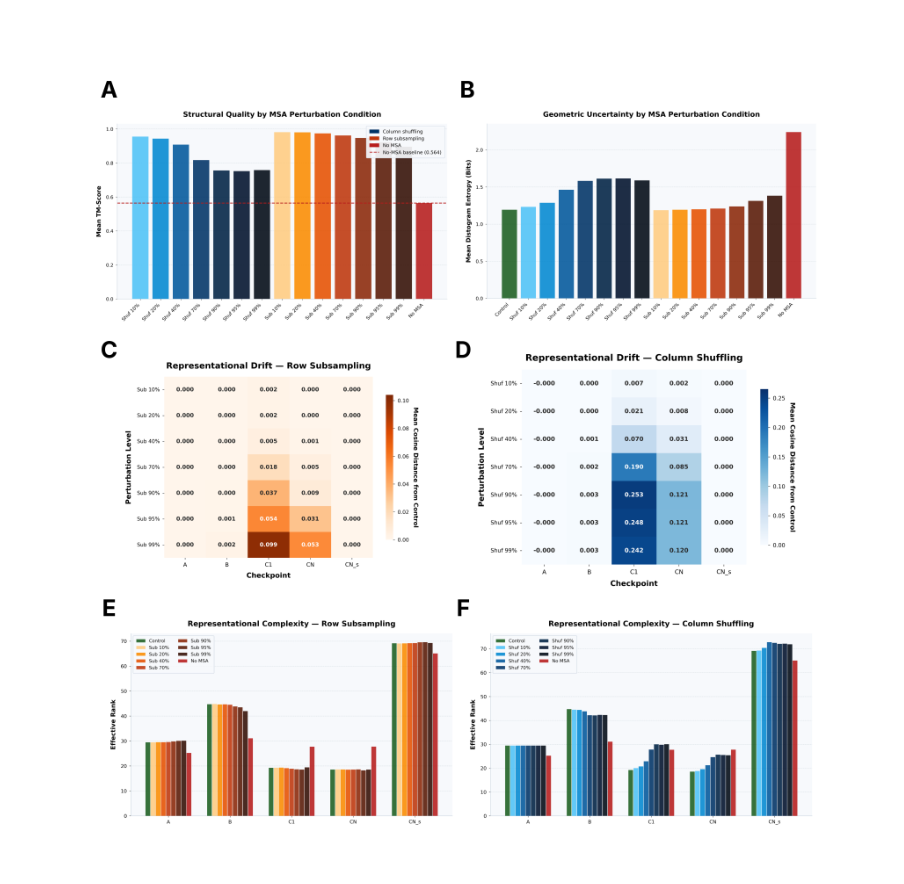
Figure 4. (A) 不同 MSA 扰动条件下的 TM-score。(B) 对应的 distogram entropy。(C-D) 行下采样与列打乱在各 checkpoint 的表征漂移。(E-F) 各条件下的表征复杂度(有效秩)。
怎么读这张图
- Panel A 是最核心的柱状图。深蓝色是列打乱(Shuf),橙色是行下采样(Sub),红色虚线是完全无 MSA 的基线(TM-score = 0.564)。结果惊人:去掉 99% 的序列(平均剩约 47 条)后,TM-score 仍维持在约 0.78,远高于无 MSA 基线。列打乱 40% 以内也表现稳健。这说明 AF3 对 MSA 的依赖并非需要”深度完整、精确共变统计”。
- Panel B 对应的 distogram entropy 变化趋势与 Panel A 一致:行下采样的 entropy 上升缓慢,列打乱的 entropy 上升更快,完全无 MSA 时 entropy 最高。AF3 似乎需要的是一种“最低限度的进化存在信号”来激活结构先验。
- Panel C-D 从表征层面解释了结构性能的变化。行下采样(Panel C)的漂移集中在 C1 阶段,CN 处反而漂移很小——说明 Pairformer 有一定的”纠错”能力,即使输入 MSA 被削弱,它也能在 recycling 过程中部分恢复表征的结构性。列打乱(Panel D)的漂移在 C1 处更大(99% 打乱时 cosine distance 达 0.242),说明列间协同进化统计对 Pairformer 的输入质量更关键。
- Panel E-F 展示了有效秩(effective rank,衡量表征复杂度)。无论哪种扰动,到 CN 阶段有效秩都会升高——说明扰动让 Pairformer 输出的表征更分散、更难以形成紧凑的结构流形。完全无 MSA 时有效秩最高,与”潜空间塌缩”的结论完全一致。
Figure 5 · 关键是系统发育多样性,5-10 条就够
这张图想回答:什么样的同源序列对 AF3 最有用?需要多少条?
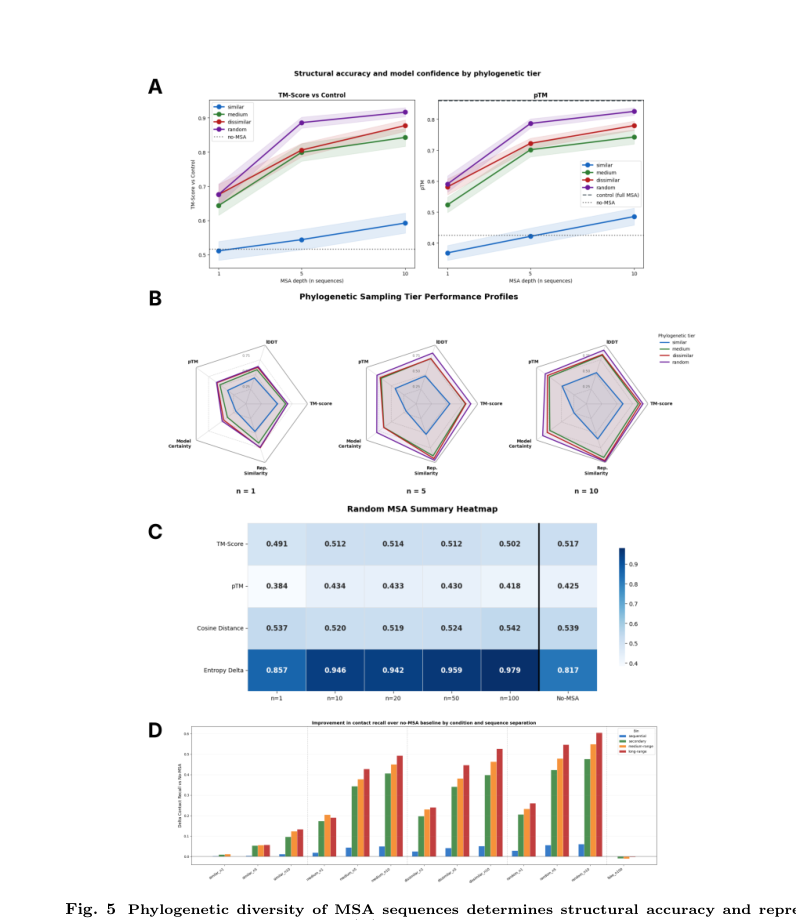
Figure 5. (A) 不同系统发育层级(similar/medium/dissimilar/random)和 MSA 深度(1/5/10 条)下的 TM-score 和 pTM。(B) 雷达图展示各层级在多维指标上的表现。(C) 假 MSA(random MSA)的汇总热力图。(D) 接触恢复改善量按 sequence separation 分箱。
怎么读这张图
- Panel A 是全文最有实践价值的结果。四条线代表四种同源序列类型:蓝色 similar(>80% identity)、橙色 medium(50-70%)、绿色 dissimilar(<30%)、紫色 random(随机抽样)。黑色虚线是完整 MSA 的 TM-score 上限,灰色虚线是无 MSA 的基线。即使只有 1 条同源序列,也能显著优于无 MSA。但近缘序列(蓝线)帮助最小——它几乎只是在重复 query 自身。远缘序列(绿线)和随机抽样(紫线)效果更好。n=5 时 random 的 TM-score 已达约 0.88,n=10 时约 0.92,接近完整 MSA。
- Panel B 用雷达图展示了四个层级在 pTM、lDDT(局部距离差异测试)、TM-score、模型确定性、表征相似度五个维度上的表现。从 n=1 到 n=10,dissimilar 和 random 的雷达图面积显著扩大,而 similar 的面积始终最小。这直观地说明:系统发育多样性(phylogenetic diversity)在多个维度上都优于单纯的深度。
- Panel C 是一个非常漂亮的负对照。作者把完全无关蛋白的序列裁剪后填入 MSA(”假 MSA”),深度从 1 到 100 条。无论给多少条假序列,TM-score 稳定在约 0.49-0.52(与无 MSA 几乎一样),cosine distance 高达 0.54,entropy delta 也居高不下。这排除了一个重要的替代解释:AF3 需要的确实是与 query 有进化关系的信息,它在读真正的进化信号,而非只响应”看起来像 MSA”的输入格式。
- Panel D 把 contact recall 的改善按 sequence separation 分箱:sequential(近程)、secondary(二级结构尺度)、medium-range、long-range。结果清晰:远程接触的恢复最依赖高多样性 MSA(右侧绿色/紫色柱明显更高)。这非常合理——远程接触最难从局部序列模式推导,恰恰需要进化比较提供”全局拓扑约束”。即使只有 1 条远缘序列,也能显著提升 long-range contact recall。
四、核心贡献总结
4.1 Pairformer 将分散的共进化信号压缩成结构流形
从 A 到 CN 的变化过程呈现一个清晰的模式:Checkpoint B(MSA 注入后)表征维度短暂膨胀——MSA 把大量共进化线索撒进了潜空间。随后,Pairformer 在 C1/CN 阶段把这些高维分散信号压缩成更紧凑的空间。
与此同时,pair representation 对 pTM 的可预测性大幅增强:R2 从 A 的 0.34 跃升到 CN 的 0.86。到后期,内部 pair 表示已经高度组织成”与结构质量直接相关”的几何空间。Pairformer 的作用像一个信息压缩器,把分散的进化线索整合成可用的结构流形(structural manifold)。
4.2 结构信息主要在 pair representation 中
作者用信息分解实验(Figure 1 Panel I-K)证明:residue pair distance、contact map 等几何信息在 pair channel 中明显更强、更独立。Single representation 更像一个 residue-level 的状态追踪器,而 AF3 的”几何推理主战场”在 pair manifold。
Cα-Cα distance 的 R2 从 A 的 0.311 增长到 CN 的 0.474,contact prediction 也随层数稳步变好。这与 AlphaFold 架构的设计直觉一致,但本文提供了更直接的内部证据。
4.3 置信度可被因果操控,且跨蛋白可迁移
Activation patching 实验证明,沿 PCA 的某些主方向平移 CN pair embedding,会系统性改变 distogram entropy。这说明潜空间中确实存在控制”几何确定性/不确定性”的轴。
更激进的跨蛋白移植实验表明:把”预测极其成功的蛋白”的 CN pair representation 片段移植到无关低质量蛋白上,下游 distogram 会变得异常确定。这说明 AF3 内部形成了一种抽象的”结构确定性几何语言”——它具有某种可迁移的表征模式,而非仅仅编码特定序列。
4.4 去掉 MSA,结构精度暴跌、内部表征塌缩
这是全文最核心的结论。有 MSA 时平均 TM-score 0.9363,去掉 MSA 后暴跌至 0.5388。这不是小幅下降,而是从”几乎完美预测”到”基本失败”的坍塌。
更重要的是,表征层面的变化与此完全对应:无 MSA 时,后期 pair representation 的有效维度更高(空间更分散),distogram entropy 全局上升。MSA 的作用不是仅仅给模型一点”额外线索”,而是维持整个可用结构潜空间的前提条件。
4.5 MSA 依赖与训练集熟悉度无关
作者把蛋白分成 Similar 和 Novel 两组,原以为对训练集相似的蛋白,AF3 也许能不靠 MSA。结果并非如此——即使是”训练时可能较熟悉”的蛋白,去掉 MSA 后表示和结构也同样崩溃。AF3 的结构能力并非来自”记住了这个家族”,而是模型学会了如何利用进化比较来激活结构先验。没有这个脚手架,光靠序列无法稳定触发几何推理。
4.6 突变不敏感根植于内部表示
作者对 400 个蛋白施加 10%-80% 的累积有害突变。到 40% 突变时,预测结构仍显著稳定;70-80% 才明显崩溃。关键数据:CN pair representation 的 cosine drift 与结构 TM-score 下降的 Pearson 相关系数达 -0.948——结构不变,恰恰因为内部 pair representation 本身就没怎么变。
且漂移主要出现在 C1/CN 而非 A/B:问题不在输入编码阶段,而在 Pairformer 形成几何假设时。模型更像在后期继续维持一个原有的 fold basin,直到扰动大到无法维持。而这种稳定性本身也依赖 MSA:无 MSA 时,10% 突变就引起大幅漂移,模型一开始就缺乏稳定的 fold hypothesis。
4.7 关键是系统发育多样性,5-10 条序列就够
按序列一致性将 MSA 中的序列分层(>80%、50-70%、<30%、随机),然后只给 1、5、10 条序列。结果非常明确:
- 即使 1 条同源序列也能显著优于无 MSA
- 近缘序列(>80% identity)帮助最小——它几乎只是在重复 query 自身
- 远缘序列和随机抽样显著更有效
- n=5 时 TM-score 已达约 0.88,n=10 时达约 0.92,接近完整 MSA
远缘序列之所以更有用,因为它们真正暴露了哪些位点必须保守、哪些可变、哪些长程接触是拓扑锚点。AF3 需要的是 phylogenetic diversity,而非简单的 alignment depth。
4.8 假 MSA 无效:排除格式假象
作者还设计了一个精巧的负对照:把无关蛋白的序列裁剪后塞进 MSA,深度从 1 到 100 条。结果完全无法改善性能——与无 MSA 基本一样。这排除了”模型只要看到类似 MSA 格式的输入就会变好”的替代解释:AF3 确实在读取与 query 有演化关系的信息。
4.9 长程接触恢复最依赖多样化 MSA
将 contact recall 按 sequence separation 分箱后发现:MSA 多样性带来的提升,在 long-range contacts 上最大。长程接触最难从局部序列模式直接推出,一旦少量远缘同源序列能帮助恢复这些接触,就说明模型从进化差异中读取了”全局拓扑约束”。这像是进化信息在为蛋白质提供一种结构骨架锚定。
4.10 Fold-switching 蛋白:AF3 会塌缩到单一主导折叠
对于实验上应当采用不同构象的 fold-switching 蛋白,AF3 倾向于把所有构象”收缩”到一个 dominant fold 上——切换区间之间平均 RMSD 仅约 2.02 A。模型并非完全无感:fold-switching 区域的 distogram entropy 更高、pLDDT 更低——模型”知道这里有问题”,但无法显式展开多稳态解。
五、局限与展望
对蛋白质设计的警示
De novo 设计、novel fold、强工程化序列的场景下,通常缺乏丰富的进化同源序列。如果 AF3 的精度主要依赖 evolutionary scaffold,那么它在这些场景中的可靠性需要谨慎评估。高置信度预测不一定等于真实的物理可折叠性。
对 MSA 构建策略的启示
既然 5-10 条多样化同源序列就能恢复大部分性能,那么 MSA 构建的关注点应该从追求深度转向追求小而多样化的 homolog 集。这对稀疏同源蛋白、synthetic MSA 生成、以及计算成本优化都有直接的实践价值。
对模型理解的刷新
AF3 更像一个以进化信息为核心支撑的高级折叠识别系统,它依赖进化比较来激活结构推理。这与”完全从单序列出发的通用物理推理模型”有本质区别。未来的方向可能包括:更高效地构造最小高多样性 MSA,或发展真正更强的 single-sequence / physics-grounded 模型。
对不确定性评估的新思路
Pair latent space 的有效秩和 distogram entropy 可能比 pLDDT/pTM 更早地暴露预测失败模式。Activation patching 的可行性也提示:也许可以通过操纵潜空间来诱导 alternative fold 或 ensemble,这是一个很有潜力的方向。
一句话总结
AlphaFold 3 的结构预测能力,根基在于 Pairformer 将 MSA 提供的进化共变信号压缩成一个可线性解码的结构潜空间——这个潜空间中的几何置信度可被因果干预,但它的连贯性和稳定性高度依赖 MSA 提供的进化脚手架。AF3 的成功,更多体现为一种以进化信息为核心支撑的高级折叠识别能力,而非完全从单序列出发的通用物理推理。
通讯作者介绍
Jeffrey Skolnick 是 Georgia Institute of Technology 生物科学学院的 Regents Professor 和 GRA Eminent Scholar,同时担任该校 Center for the Study of Systems Biology 的主任。他在蛋白质结构预测、功能预测和药物发现领域深耕数十年,是 TASSER / I-TASSER 蛋白质结构预测方法的核心开发者之一,这一方法在多届 CASP 竞赛中取得优异成绩。Skolnick 的研究横跨理论物理、计算生物学与系统药理学,近年来将关注点扩展到人工智能驱动的蛋白质结构建模的机制理解,本文正是这一方向的代表性工作。
引用
Feldman, J., & Skolnick, J. (2026). AlphaInterp: Mechanistic Interpretability of AlphaFold 3 Reveals How Evolutionary Information Shapes Protein Structure Prediction. bioRxiv. https://doi.org/10.64898/2026.04.22.720175