
AFToolkit: a framework for molecular modeling of proteins with AlphaFold-derived representations
原文链接:全文
作者:Maria Sindeeva, Alexander Telepov, Nikita Ivanisenko, …, Olga Kardymon
Briefings in Bioinformatics,2025 年 7 月 1 日
蛋白工程里最常被问到的一句话是:这个突变会让蛋白更稳定还是更不稳定?会增强还是削弱结合?对应的量就是 ΔΔG。AlphaFold2 预测结构很强,但对单点突变出了名地迟钝——把野生型和突变体各跑一遍,输出结构几乎一模一样,看结构差异根本判断不出突变好坏。
AIRI 的这篇工作给出的解释是:AlphaFold2 并非没学到突变相关的信息,而是标准推理流程里的 MSA 和模板把这些信号压住了。他们的处理很轻:去掉 MSA 预搜索,第一轮 recycling 用野生型结构当模板,从第二轮起把模板特征全部乘零(作者称之为 mask),然后读取模型内部的 Pair 表征、LDDT logits 和 pLDDT,交给一个 SVM 去回归 ΔΔG。
全程不微调 AlphaFold2 的任何一个权重,训练的只有适配器。结果是 PTMul 多点突变 Spearman 0.68、cDNA-indel 插入删除 0.60,并且它是对比方法中唯一能同时处理替换、插入和删除的框架。
本文读法:先讲清楚”为什么遮模板有用”,再走一遍方法与消融,最后看七个测试集上的硬指标和它真实的短板。
一、研究问题
要预测的三个量
蛋白工程的日常操作是定点突变:改几个氨基酸,换来更高的热稳定性、更强的结合、更好的表达。能不能事先判断一个突变的效果,直接决定了实验轮次和成本。论文针对三类预测目标:
ΔΔGstability:单体折叠稳定性变化
突变前后蛋白折叠自由能的差值。按论文采用的约定,ΔΔG < −0.5 记为稳定化突变,ΔΔG ≥ −0.5 记为去稳定化突变,这个阈值用于把回归任务改写成二分类来算 AUC 和 MCC。
ΔΔGaffinity:蛋白–蛋白结合自由能变化
界面上的突变如何改变复合物的结合强度,抗体亲和力成熟、工程化 binder 优化都属于这一类。
ΔGrosetta:每个残基的 Rosetta 能量
这一项预测的是绝对值而非差值,目标是 REF2015 能量函数给出的残基级能量。把它做进同一个框架,意味着跑一次推理就能同时拿到结构、置信度、ΔΔG 和能量代理指标,省掉在多个软件之间倒腾文件的麻烦。
作者的假设:信号被 MSA 和模板压住了
已经有工作尝试直接拿 AlphaFold2 的 embedding 做突变相关任务,但标准推理流程在 recycling 阶段严重依赖两样东西:MSA 的共进化特征,以及输入模板的结构特征。作者的假设是,正是这种依赖让 AlphaFold2 在评估点突变时失灵。
道理并不复杂。一条 200 残基的序列改掉一个氨基酸,MSA 里的进化信息几乎原封不动;如果再把野生型结构当模板反复喂进去,模型每一轮 recycling 都在被提醒”结构长这样”。两股力量叠加,输出结构必然和野生型高度相关,突变那点扰动被稀释得看不见。论文在讨论部分还给了一个更具体的猜测:AlphaFold2 训练时模板特征在损失函数中权重很高,模型一旦发现输出结构和模板高度相似,就会变得过度自信。
现成的参考是 AF2Rank——它在 decoy 结构质量评估任务上做过类似的事:取消 MSA 预计算,把模板里的残基类型换成 gap 或 UNK 这类特殊 token,大幅削弱模板的身份信息,从而让 AlphaFold2 的置信度能够反映输入结构的真实质量。作者的问题是:类似的推理改造,能不能也用在突变效应预测上?而且要在削弱模板约束的同时,保住用户指定的那个折叠和构象状态——这对结构导向的蛋白优化至关重要。
二、方法核心:mask 推理 + 轻量适配器
第一刀:砍掉 MSA 预搜索
AFToolkit 不做耗时的 MSA 检索,MSA 特征完全由输入序列自身构造。这一刀带来两个后果:推理速度大幅提升(作者提到,去掉 MSA 后的推理复杂度已经接近 ESMFold),以及输入序列里的那个突变不再被成百上千条同源序列摊薄,可以直接作用到内部表征上。
实现基于开源的 OpenFold,权重选的是 AlphaFold2 的 Model 2 pTM。选 Model 2 有两个理由:它训练时使用的 MSA 更少,对共进化信息的依赖本来就偏低,与”不用 MSA”的设定更匹配;pTM 版本则便于直接复用 AF2Rank 那套置信度指标做对比。
第二刀:第一轮给模板,之后把模板乘零
这是整篇论文最关键的设计,作者称为 masking:
Recycle 0(第一轮)
把野生型结构作为模板正常输入。这一轮的作用是告诉模型”我们要研究的是这个折叠、这个构象状态下的蛋白”。
后续每一轮 recycling
所有模板特征乘以零。模型此后只能依靠突变后的序列和上一轮自己的状态继续更新,无法再从模板里”抄答案”。
这个设计在两个互相拉扯的目标之间取平衡:如果每一轮都提供野生型模板,模型倾向于不断复制野生型结构,突变信号被抹平;如果从第一轮起就彻底不给模板,模型又可能跑到另一个构象状态去,用户关心的那个折叠就丢了。先看一眼、再拿走,是 AFToolkit 相对 AF2Rank 的核心区别——AF2Rank 的遮蔽从一开始就很强且无法调节,而 mask 的强度可以通过”遮蔽前跑几轮”来调。
最终配置为 Nrecycle = 4,依据来自图 2 的结构保持实验。
突变怎么写进输入
突变用 mutcode 描述,格式是「突变前残基 + 位置 + 突变后残基」,删除时后者写成”−”,插入时后者包含两个氨基酸类型。三类突变在序列和模板上的处理各不相同:
点突变(如 A15D)
序列第 15 位由 Ala 改成 Asp;模板里把该残基的全部侧链原子删掉,残基名改成突变后的类型,主链保留。这样模型拿不到野生型侧链的摆放方式,必须自己推断新残基在这个局部环境里的构象。
删除
从序列和模板结构中同时移除该残基,后续残基重新编号。
插入
序列中加入新残基,模板中插入一个坐标被遮蔽的 dummy 残基,后续残基重新编号。插入位置的局部结构完全交给模型推断。
因为突变是直接写进序列和模板的,框架天然支持多点突变、插入、删除,不需要为每种突变类型设计专门的模块。输入结构可以来自 PDB 实验结构,也可以用标准设置的 AlphaFold2 先预测一个。对多链复合物,作者沿用 ColabFold 的做法,把复合物当成一条伪单链输入,并在位置编码上给链间留出 25 个残基的间隔。
适配器:简单到有点反直觉
三类轻量模型做了比较,设置都很朴素:
SVM(最终主模型):scikit-learn 的支持向量回归,配标准化预处理。正则化参数只调了一个 C——稳定性预测用 C = 1,结合亲和力预测用 C = 2。作者强调它在各数据集上表现稳健,基本不需要重新调参。
CatBoost:梯度提升树,最多 500 轮、连续 15 轮无提升则早停,树深 4,L2 正则系数 5,优化 MSE。
MLP:训练 50 个 epoch,batch size 256,学习率从 1e-3 指数退火,配早停。这里有一个值得记的细节——用 Adam 训练会明显过拟合,换成 SGD 才稳定。
论文的立意也在这里:下游模型越简单,就越能说明性能来自表征本身,而不是回归器的拟合能力。Rosetta 能量任务更直接——每个残基当作一个独立样本,输入同样是 Pair + LDDT logits + pLDDT 的拼接,不做任何蛋白级聚合。
三、看图说话
四张图的分工很清楚:图 1 给出框架,图 2 在结构层面验证 mask 合理,图 3 在表征层面验证 mask 有用,图 4 定下最终配置。
Figure 1 · AFToolkit 的整体流程
这张图想回答:AFToolkit 如何在不改动 AlphaFold2 权重的情况下,从推理流程中提取突变相关的表征?
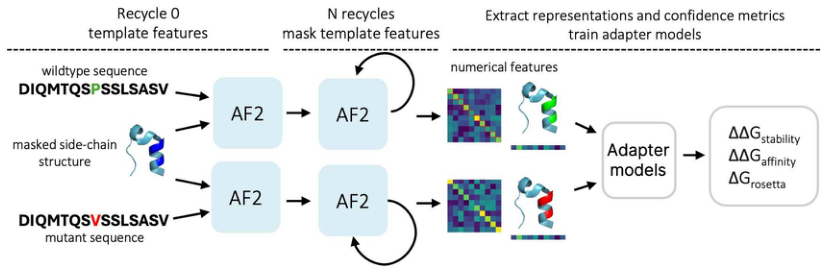
图上有两条平行的通路:上面一条是野生型序列(示意里是 DIQMTQSPSSLSASV),下面一条是突变序列(同一位置换成 V)。两条通路共用同一个被遮蔽侧链的结构模板。
Recycle 0 这一栏标注的是 template features——第一轮两条通路都看得到模板。紧接着 N recycles 那一栏写着 mask template features,并且画了自循环箭头:后续每一轮都是模型自己把上一轮状态送回输入,模板特征已经归零。
右侧 numerical features 画的是 pair 表征的热图和带置信度着色的结构:野生型那条链是绿色高亮,突变体那条是红色高亮,表示突变位点周围的内部表征确实出现了差异。两套特征一起送进 Adapter models,输出三类预测:ΔΔGstability、ΔΔGaffinity、ΔGrosetta。
整张图里没有任何”训练 AlphaFold2”的环节。虚线框划分的三段分别是:给模板、遮模板、取表征训适配器——所有被训练的参数都在最右边那个小盒子里。
Figure 2 · decoy 排序实验:mask 在”会判断”和”不乱改”之间找平衡
这张图想回答:mask 策略下 AlphaFold2 既能区分结构质量好坏,又不会大幅改动用户指定的构象状态吗?
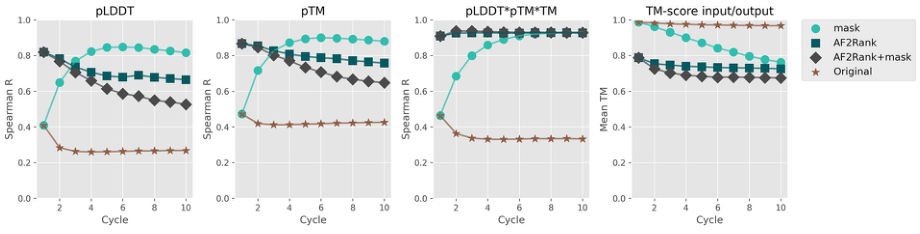
图 2 先不碰突变,而是复现 AF2Rank 的 decoy 排序实验。素材是 Rosetta decoy 数据集中随机抽取的 1800 个样本:同一个蛋白会被 Rosetta 生成很多候选结构,有的接近真实结构,有的明显跑偏。把候选结构 din 当模板喂进去,看模型输出的置信度能否反映它与实验结构 e 的真实相似度 TM(din, e)。
四个子图的横轴都是 recycling 轮数(1 到 10),四条曲线是四种推理方案:mask(青色圆点)、AF2Rank(深色方块)、AF2Rank+mask(灰色菱形)、Original 即标准推理(棕色星号)。
前三个子图(pLDDT、pTM、pLDDT×pTM×TM)画的是置信度与真实质量的 Spearman 相关。标准推理的表现最差——pLDDT 面板上它在 2 轮之后就掉到 0.3 以下,这意味着标准 AlphaFold2 给出的置信度几乎分不清输入结构是好是坏,因为它只是在照抄模板然后对自己的抄写结果打高分。mask 的曲线迅速爬升到 0.85 上下并保持平稳,稳定高于 AF2Rank;在 pLDDT×pTM×TM 这个综合指标上,mask 与 AF2Rank 两条曲线在多轮之后基本重合在 0.9 以上。
第四个子图 TM-score input/output 换了个问题:推理之后输出结构和用户输入的结构差多远。标准推理几乎是一条贴着 0.97 的水平线——完全复制输入,所以它”不会评判”。AF2Rank 和 AF2Rank+mask 一上来就掉到 0.8 以下,说明它们把输入构象改动得比较多。mask 的曲线从接近 1.0 开始缓慢下滑,在 4 轮附近仍然保持在 0.9 左右,之后才逐渐降到 0.75 附近。
这张图解释了为什么选 4 轮:此时 decoy 排序能力已经与 AF2Rank 相当,而对输入结构的扰动明显更小。对蛋白工程来说,这正是需要的性质——既要模型能独立评判,又不能让它把你精心保留的催化位点几何或某个 apo/holo 构象改掉。作者提到,这套思路已经被用于优化栉水母钙调控发光蛋白 berovin 的 apo 态性质,并通过了实验验证。
Figure 3 · 换一种推理方式,表征好不好用
这张图想回答:mask 推理抽出来的内部表征,拿去预测突变的 ΔΔG 是否真的更好?recycling 跑几轮合适?
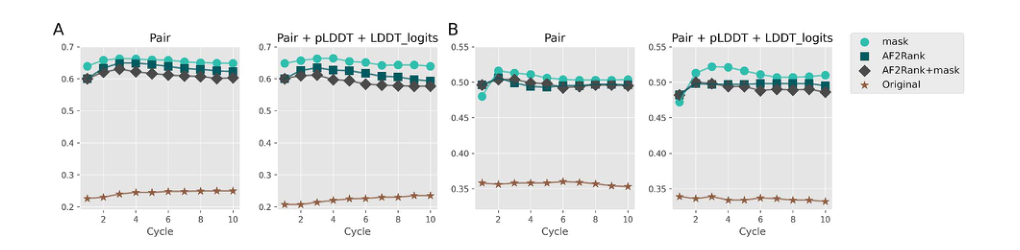
图 2 只说明 mask 在结构层面合理,图 3 直接考下游任务。作者把下游模型固定为同一个 SVM,数据、训练方式、超参数都不变,只换”表征是用哪种推理方式抽出来的”,所以预测好坏可以归到表征本身。纵轴是 SVM 预测值与实验 ΔΔG 的 Spearman 相关,横轴是 recycling 轮数 1–10,四条曲线的图例与图 2 相同,这里的 Original 是不用 MSA 的标准 AlphaFold2。
- Panel A:PTMul 多点突变集,单个样本最多约 10 个同时突变。只用 pair 表征时,Original 只有约 0.22–0.25;三种改过模板的方案都在 0.6 以上,mask 最高,约 0.65。右图再拼上 pLDDT 和 LDDT logits,排序不变。也就是说,只去掉 MSA 远远不够,野生型模板在每轮 recycling 里持续”提醒”模型,突变信号就被压住了。
- Panel B:s669 单点突变集,扰动更细微,整体相关性也更低。Original 约 0.34–0.36,改过模板的方案在 0.49–0.52 之间,mask 仍然略高。差距比 A 小,但方向一致:即使最终结构几乎不变,换了推理方式后内部表征里也能读出单个突变的影响。
曲线在 3–4 轮之后基本走平甚至略降,recycling 并非越多越好。结合图 2 对输入结构的扰动,作者最终定为 4 轮 recycling,特征用 pair 表征 + pLDDT + LDDT logits。
Figure 4 · 聚合方式和适配器的消融:Single-MA + SVM 胜出
这张图想回答:从 AlphaFold2 提取的表征应该怎样聚合、用什么适配器,才能在不同突变类型上都表现稳健?
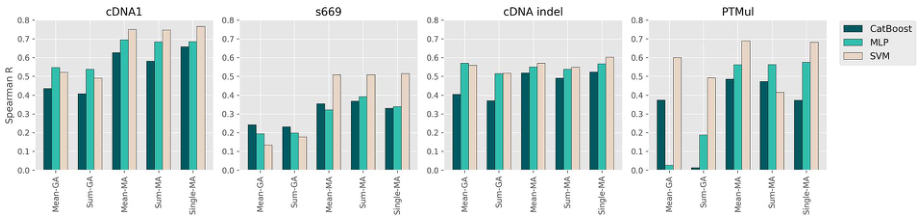
四个子图分别是 cDNA-1(单点)、s669(外部单点)、cDNA-indel(插入删除)、PTMul(多点)。每组横轴是五种聚合方式,三种颜色的柱子分别是 CatBoost、MLP、SVM(浅色)。
第一个规律:聚焦突变位点远胜全局聚合。在 cDNA-1 上,Mean-GA 和 Sum-GA 的 SVM 大约 0.50 上下,换成 Mean-MA、Sum-MA、Single-MA 之后直接跳到 0.75 左右。s669 上这个落差更夸张:全局聚合的 SVM 只有 0.15–0.2,突变位点聚合约 0.52。把整条蛋白平均一遍,等于把那一个突变的信号淹掉。
第二个规律:PTMul 上的差距最刺眼。CatBoost 和 MLP 在 Mean-GA、Sum-GA 两种配置下几乎贴着零,而 SVM 在 Mean-GA 下仍有约 0.60。到了 Single-MA,SVM 升到约 0.68,是全图最高的一根柱子。
第三个规律:SVM 几乎在每一格都不输。MLP 偶尔在 cDNA-indel 的全局聚合配置下略占优(约 0.57 对 SVM 的 0.55),但在其他绝大多数格子里,浅色的 SVM 柱子都是最高或并列最高。CatBoost 整体偏弱——AlphaFold2 表征是高维稠密连续向量,并不是树模型擅长的数据类型。
作者据此定下 Single-MA + SVM 作为主模型,后续所有表格里的 AFToolkit (SVM) 都是这个配置。选它的理由是跨任务的稳定性:单点、外部泛化、indel、多点,四项都站在前列。
四、核心贡献总结
下面只展开稳定性这一类。论文同时把同一套表征用在蛋白–蛋白结合亲和力和 Rosetta 残基能量上,本文不展开。
稳定性预测:七个测试集
对照方法 PROSTATA 和 Mutate Everything 都在同一份 cDNA+PROSTATA 上重新训练过,保证可比。下表是 Spearman Rs 与 RMSE(RMSE 越低越好):
| 测试集 | AFToolkit Rs / RMSE | ME-AF2 | PROSTATA |
|---|---|---|---|
| cDNA-1 | 0.77 / 0.74 | 0.81 / 0.70 | 0.76 / 0.85 |
| cDNA-2 | 0.57 / 1.22 | 0.52 / 1.22 | 0.46 / 1.25 |
| cDNA-indel | 0.60 / 1.02 | 无法处理 | 无法处理 |
| s669 | 0.51 / 1.41 | 0.54 / 1.40 | 0.47 / 1.50 |
| ssym | 0.77 / 1.10 | 0.61 / 1.23 | 0.50 / 1.42 |
| PTMul | 0.68 / 1.90 | 0.67 / 1.71 | 0.45 / 2.12 |
| de novo Mega | 0.71 / 0.61 | 0.63 / 0.66 | 0.72 / 0.62 |
更准确的概括是分层的:单点突变上与最强基线相当(cDNA-1 的 0.77 低于 ME-AF2 的 0.81,s669 的 0.51 低于 0.54,de novo Mega 的 0.71 略低于 PROSTATA 的 0.72);多点突变、对称性测试和 indel 上优势明显(cDNA-2 的 0.57、ssym 的 0.77、PTMul 的 0.68、cDNA-indel 的 0.60)。
有两个数字值得单独拎出来。一是 ssym 上的 0.77,比 ME-AF2 高出 0.16。ssym 专门用来检验模型在正向和反向突变上是否自洽,许多方法在这上面会暴露系统性偏置。s669 的正反向对照更直观:AFToolkit 正向 0.51 / 反向 0.51,完全对称;而 SDM 从 0.41 掉到 0.13、PoPMuSiC 从 0.41 掉到 0.24、MAESTRO 从 0.50 掉到 0.20。这应当与训练时加入反向突变增广有关。
二是 PTMul 上相关性赢、RMSE 输:Rs 0.68 略高于 ME-AF2 的 0.67,但 RMSE 1.90 明显高于 1.71。换句话说,它更擅长把突变排出正确顺序,数值的绝对校准还差一截。cDNA-indel 的 MCC 是 −0.002,也提示在那个阈值下的二分类几乎没有判别力,只有排序是有效的。
T4 溶菌酶案例给了 Single-MA 一个直接证据。PTMul 中 T4 溶菌酶(PDB 2LZM)共有 7 个样本,对应 7 个点突变的不同组合。两种预测方式对比:独立预测每个单突变再相加,RMSE = 1.12;按 Single-MA 在多突变背景下提取表征再相加,RMSE = 0.99。有意思的是,实验数据显示这组突变本身是可加的,即便如此,在多突变背景中提取的表征依然更准。
五、局限与展望
需要注意的局限
依赖输入结构质量。整套流程以野生型结构为模板,初始结构明显不准时,突变位点的局部环境就是错的,界面任务受影响尤其大。作者的建议是用实验结构,或用标准设置的 AlphaFold2 先生成一个高质量结构。
适配器还很浅。目前只试了 SVM、CatBoost、MLP,而且输入是聚合后的突变位点特征。这种做法会丢掉长程相互作用、界面空间拓扑和全序列上下文。作者自己指出,直接处理整条序列残基级表征的 Transformer 是更合理的下一步。
多突变仍带加性假设。Single-MA 的局部特征虽然包含其他突变的上下文,输出层终究是求和。遇到强协同或强拮抗的突变组合,这个形式可能不够用。
相关性与误差指标不同步。PTMul 的 Rs 更高而 RMSE 更差,C380 的三项相关指标最好而 RMSE 排在后面,cDNA-indel 的 MCC 接近零。把它用于候选突变排序和高通量预筛是合适的,直接取预测数值当作实验 ΔΔG 的替代则要谨慎。
复合物处理方式简化。多链被拼成伪单链,链间只靠位置编码留 25 个残基的间隔。这样能复用单链流程,但链身份、化学计量、界面配对信息表达得并不完整,换成 AlphaFold-Multimer 或 AlphaFold3 风格的模型会更自然。
基线比较的口径不完全一致。部分对照指标取自原论文,部分由作者重新训练,mCSM-PPI2 的结果来自官方服务器且多突变是靠独立单突变预测相加得到的;复合物级划分下 MpbPPI 和 FoldX 的数值是作者从他人论文的图里近似读出来的,论文中以约等号标注。因此合适的理解是”达到了有竞争力的水平”,并非对所有 SOTA 做了完全统一口径的严格对比。
一句话总结
AlphaFold2 对突变迟钝,问题可能出在推理流程而不是模型本身。先让它看一眼模板确认结构,再把模板拿走逼它根据突变序列重新判断,然后读内部表征而非最终坐标——这套改动不用训练任何大模型参数,就把一个结构预测器变成了通用的突变表征器。代码已开源在 AIRI-Institute/AFToolkit。
通讯作者介绍
Maria Sindeeva 是本文的通讯作者兼共同第一作者,任职于俄罗斯人工智能研究院(AIRI,Artificial Intelligence Research Institute)位于莫斯科的生物信息学组,职务为 AI 研究员。她的研究方向集中在把深度学习方法用于蛋白质与基因组建模,具体包括蛋白稳定性变化预测、蛋白–蛋白相互作用能量变化预测、B 细胞构象表位预测,以及基因组与表观基因组数据的深度学习分析。她参与的代表性工作除本文的 AFToolkit 之外,还有 B 细胞构象表位预测平台 SEMA 2.0(发表于 Nucleic Acids Research),相关代码同样由 AIRI 开源。本文的其余共同第一作者 Alexander Telepov、Nikita Ivanisenko、Tatiana Shashkova 同属 AIRI 生物信息学组,Artur Kadurin 与 Olga Kardymon 负责项目指导,整个团队长期围绕蛋白工程与 AI 制药方向开展研究。
引用
Sindeeva, M., Telepov, A., Ivanisenko, N., Shashkova, T., Khrabrov, K., Tsypin, A., … & Kardymon, O. (2025). AFToolkit: a framework for molecular modeling of proteins with AlphaFold-derived representations. Briefings in Bioinformatics, 26(4), bbaf324. https://doi.org/10.1093/bib/bbaf324