
NACraft: Programmatic nucleic-acid aptamer design via all-atom structure-model feedback
原文链接:全文
作者:Heqin Zhu, Jiaqi Wang, Weibo Zhao, …, Odin Zhang
bioRxiv,2026 年 8 月
核酸适配体(aptamer)设计一直是个难题:序列、折叠结构、靶标结合三者强耦合,传统方法靠 SELEX 实验筛选,效率有限。
这篇来自 Valhalla Technology 和港中文、北大团队的预印本提出了 NACraft——一个不需要训练的核酸适配体设计框架。核心思路:把设计目标写成损失函数,直接通过结构预测模型的反馈优化序列。像写代码一样”编程”设计 aptamer。
一、研究问题
文章要解决一个经典但很难的逆向设计问题:已知目标蛋白结构,能不能直接设计一个以前不存在的 RNA 或 DNA 序列,使它折叠成合适三维结构并与目标结合?
难点在于 aptamer 的功能强依赖三者耦合:
1. 序列(sequence)决定折叠
2. 折叠结构(3D conformation)决定能不能结合
3. 结合界面(binding interface)反过来又约束序列和结构
这和只做 RNA 二级结构设计不同,也和只做蛋白 binder design 不同。核酸体系里,碱基配对、三级结构、分子间结合是耦合的,而且 DNA/RNA 都要支持。
现有方法的缺口
传统核酸设计方法多围绕给定二级结构;数据驱动方法很多不显式利用目标 3D 结构。
生成式方法如 ODesign 虽然能做 RNA/DNA 设计,但主要偏 de novo,对「从已有 aptamer 改造」和「显式优化选择性/抗脱靶」支持不够强。
所以作者提出:能不能把蛋白领域的 structure hallucination / model inversion 思路真正扩展到核酸 aptamer 设计?
二、方法核心
NACraft 分四步:
Step 1:定义设计上下文
目标蛋白是谁、要设计 RNA 还是 DNA、aptamer 长度多长、想优化什么(结合、避免结合、保持与参考序列相似等)。
Step 2:可微分序列优化
用 Boltz-1 结构模型做反馈。直接用其 distogram 输出构造损失——模型预测任意两个 token 间距离落在不同 bin 的概率,再对”接触概率”求和定义损失函数。这样做可微、高效、适合在序列空间做梯度优化。
序列表示为连续 logit 张量(L×8 维),用 straight-through estimator 让离散序列可微分。分阶段退火:30 步 warm-up → 100 步 exploration → 100 步 annealing → 10 步 final,前期广搜、后期收敛。
Step 3:NA-MPNN 重设计和多样化
梯度优化给出一个好”父序列”,再通过 NA-MPNN 做结构驱动 refinement/diversification。消融实验显示 12/12 target 的最大 ipTM 和 pLDDT 都在这一步提升,典型例子:8SWC 从 0.66 → 0.93。
Step 4:AF3 独立验证与筛选
用 AlphaFold3 独立预测复合物,用 ipTM、pLDDT、iPAE 等指标打分。关键设计选择:优化时用 Boltz-1 给梯度,评估时用 AF3 做独立验证,避免同模型自证。
Boltz-guided search + MPNN redesign + AF3 validation 三者组合,共同构成一个完整的多阶段设计系统。
NACraft 最强调的一个词是 programmatic——目标函数可以像积木一样组合:
| 损失函数 | 作用 | 用于哪种模式 |
|---|---|---|
| Binding loss | 促进 aptamer 与靶蛋白接触 | 全部 |
| Anti-binding loss | 抑制与 off-target 结合(取 binding 的反向) | Target-selective |
| Internal-contact | 保证 aptamer 自身折叠紧凑(不能只顾贴蛋白) | 全部 |
| Similarity loss | 保持与参考序列相似(用线性势而非 cross-entropy,更允许突变和界面重塑) | Similarity-guided |
三种设计模式由损失组合决定:
De novo:binding + internal-contact + regularization,从零设计
Similarity-guided:加上 similarity loss,以已有 aptamer 为起点优化
Target-selective:加上 anti-binding,同时追求”绑定正目标”并”避免绑定负目标”
三、看图说话
Figure 1 · NACraft 框架总览
这张图想回答:NACraft 的整体设计流程是什么?
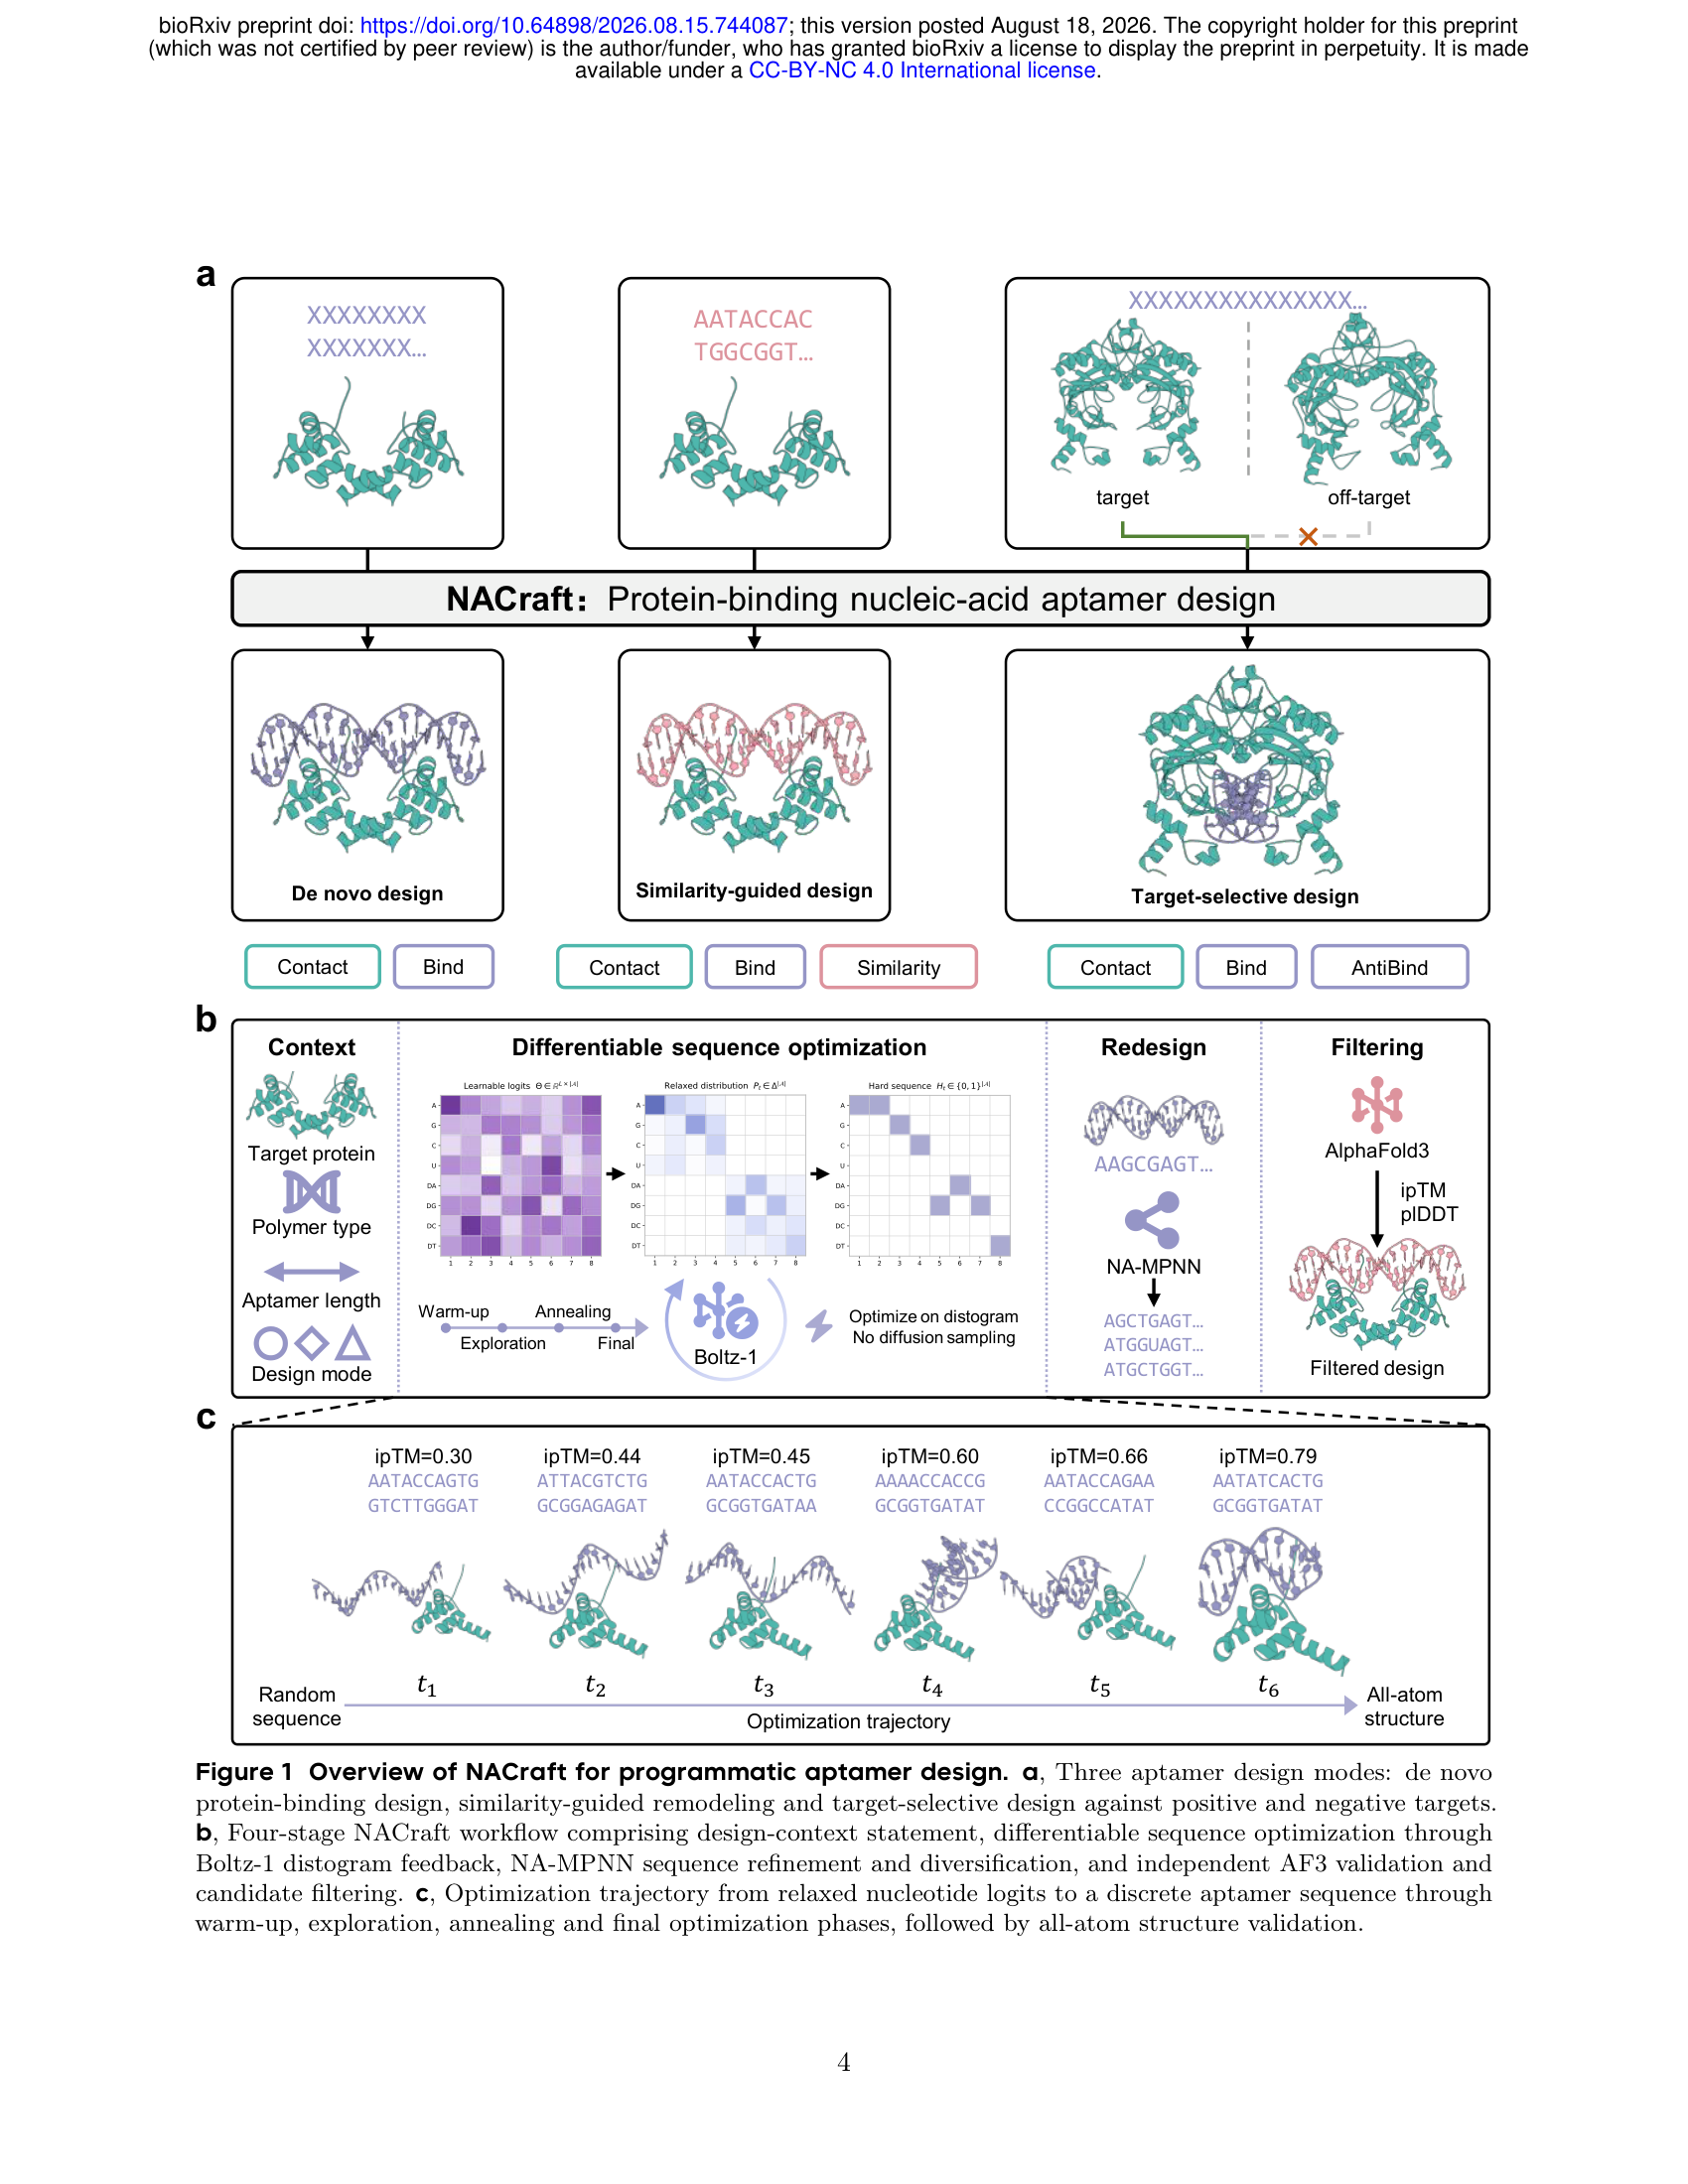
Figure 1. (a) 三种设计模式:de novo、similarity-guided、target-selective。(b) 四阶段工作流。(c) 优化轨迹示意。
怎么读这张图
- Panel a:三种模式——从零设计(de novo)、基于参考序列改造(similarity-guided)、同时优化正/负靶标选择性(target-selective)。
- Panel b:四阶段流程——定义设计上下文 → 用 Boltz-1 的 distogram 做可微分序列优化 → NA-MPNN 重设计和多样化 → AlphaFold3 独立验证打分。
- Panel c:优化轨迹——从随机序列出发,经过 warm-up、exploration、annealing、final 四个阶段,逐步收敛到高置信度结构。
读图结论:整个流程的关键是优化和验证用不同模型——Boltz-1 给梯度,AF3 做独立验证。这是证据链里很重要的一点,尽量避免”用同一个模型优化、再用同一个模型自证”。
Figure 2 · De novo 设计结果
这张图想回答:从零开始,NACraft 能设计出多好的 aptamer?
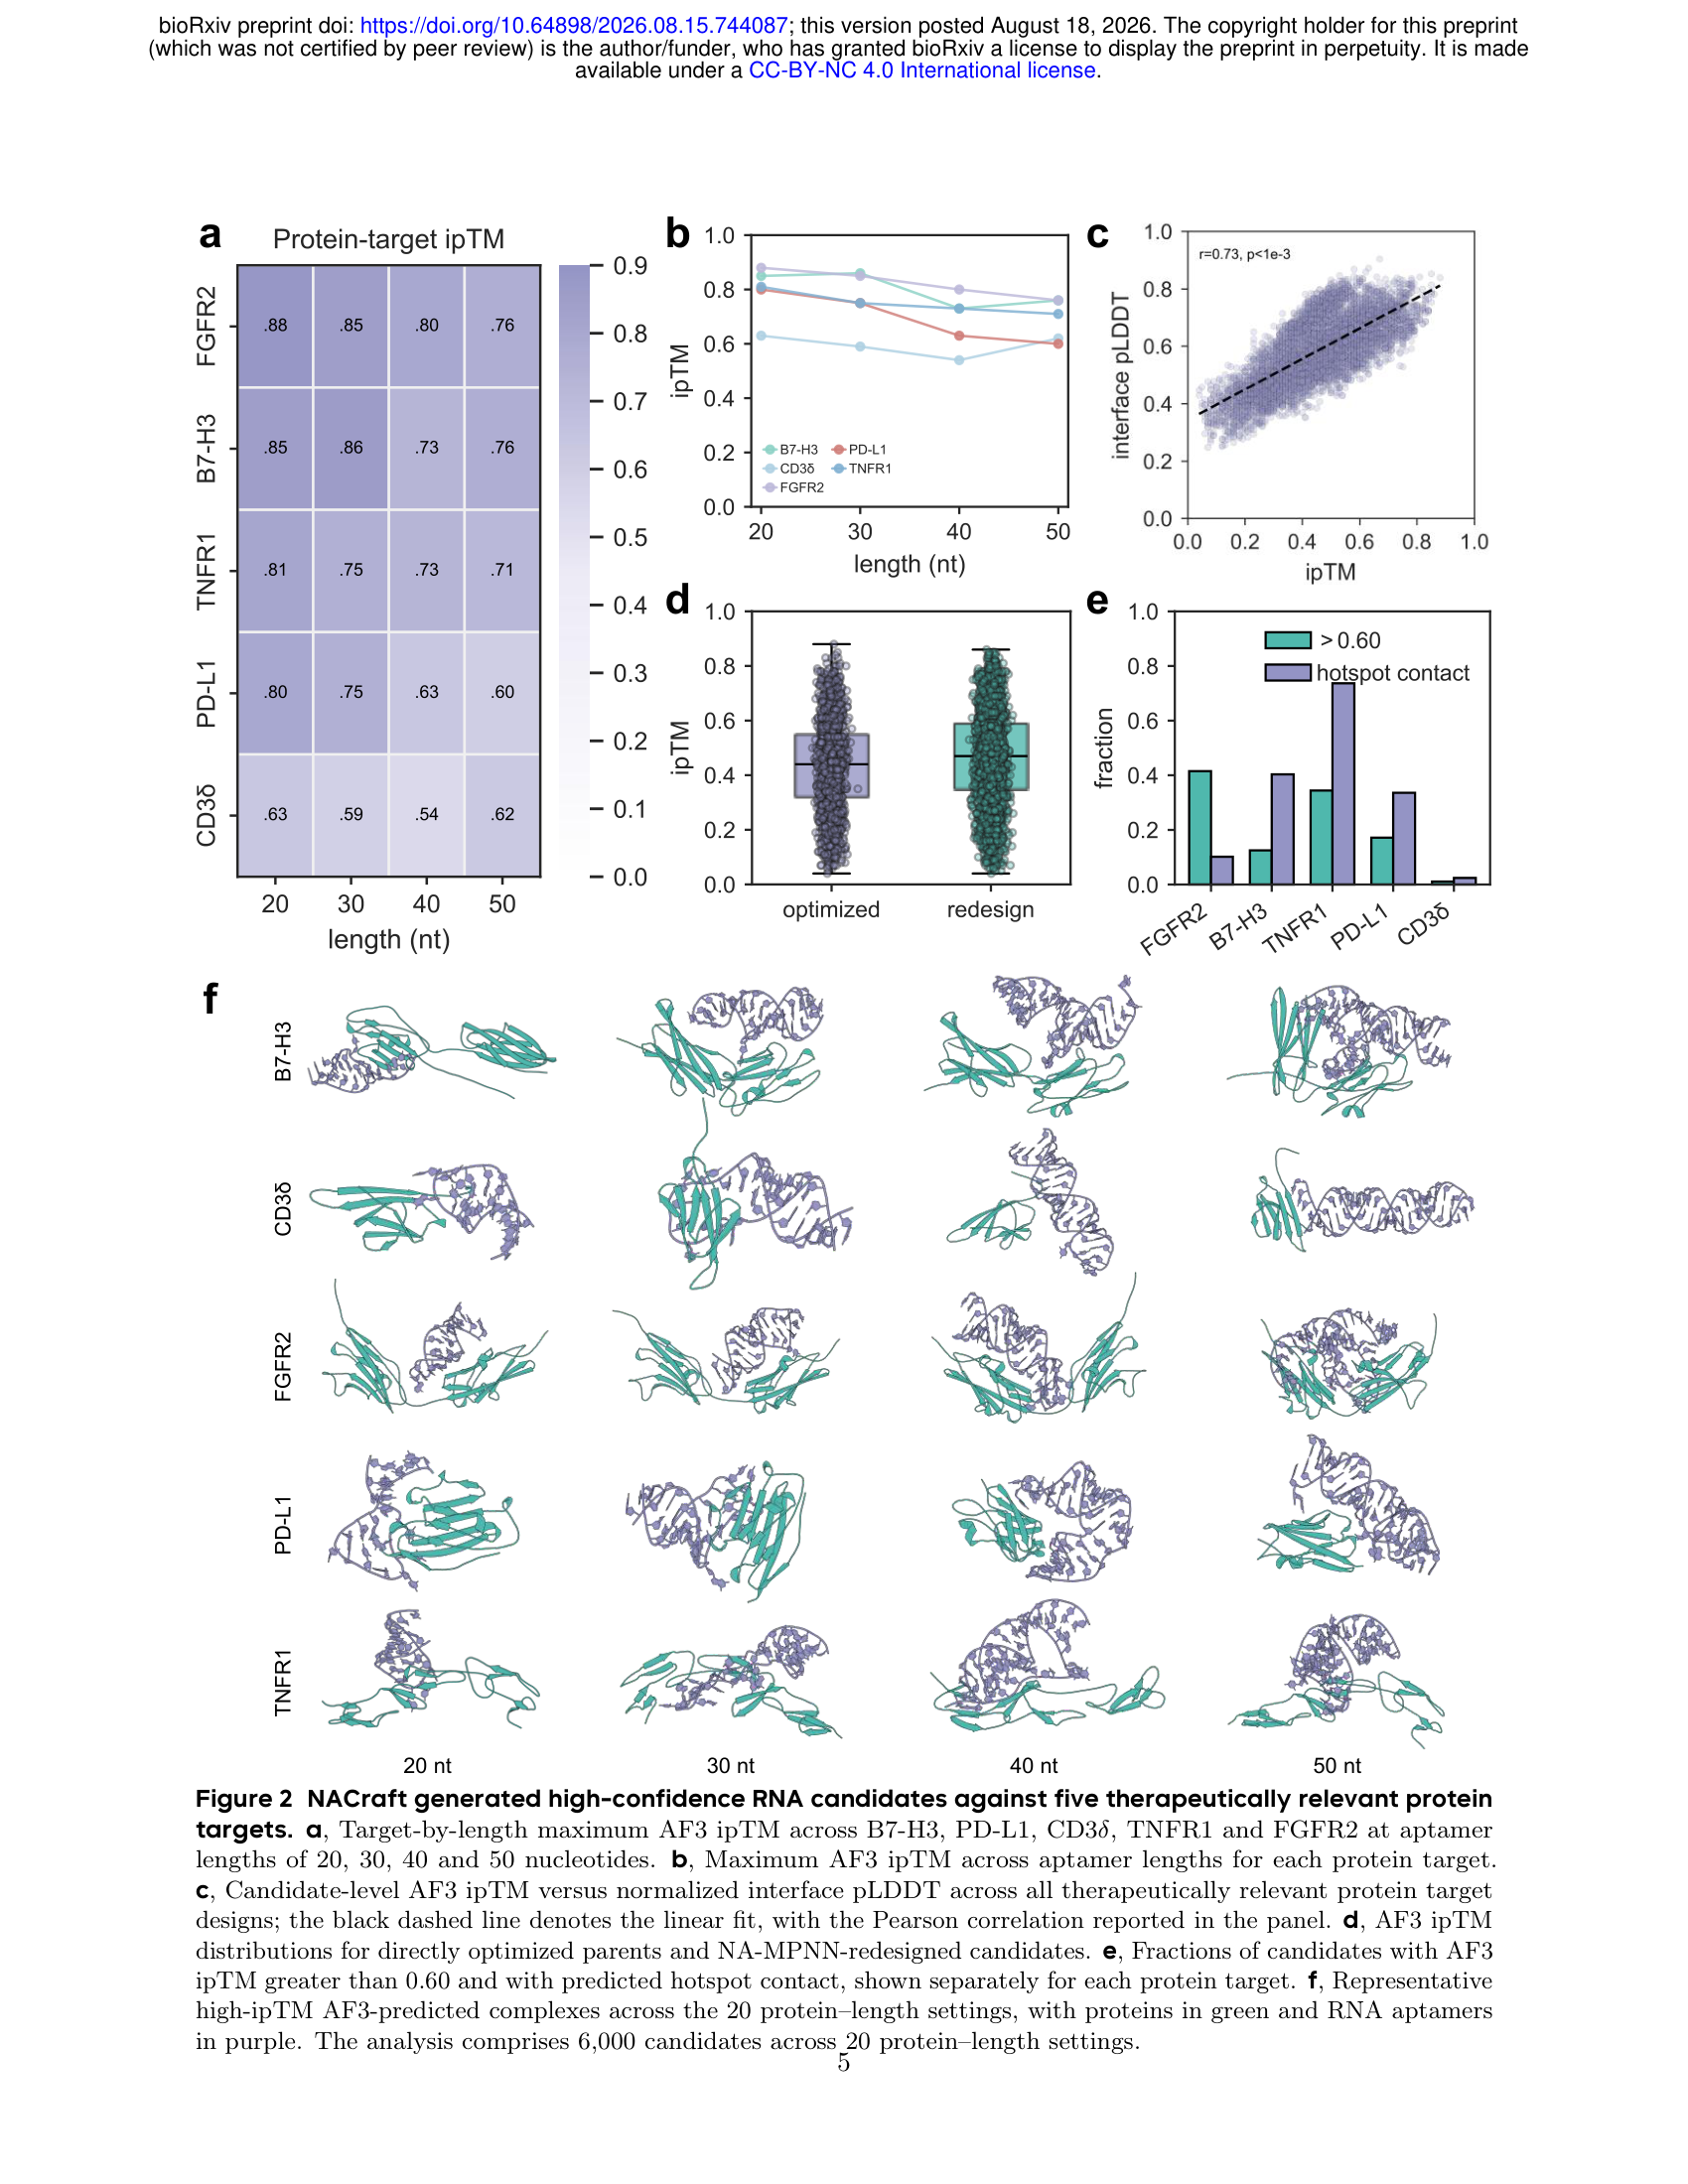
Figure 2. 5 个治疗相关蛋白靶标 (B7-H3, CD3δ, FGFR2, PD-L1, TNFR1) 的 de novo RNA aptamer 设计结果。
怎么读这张图
- Panel a(热图):5 个靶标 × 4 种长度(20/30/40/50 nt)的最佳 AF3 ipTM。FGFR2 整体最高(0.88),CD3δ 最低(0.63)。
- Panel b(折线图):ipTM 随 aptamer 长度的变化趋势。不同靶标的最优长度不同。
- Panel c(散点图):ipTM 与 interface pLDDT 的正相关(Pearson r = 0.731),说明高 ipTM 候选通常伴随更可信的界面结构。
- Panel d(小提琴图):optimized vs redesign(NA-MPNN 阶段)的分布对比。
- Panel e(柱状图):各靶标 ipTM > 0.60 和 hotspot contact 的候选比例。FGFR2 成功率 41.5%,CD3δ 仅 1.08%。
关键数字
5 个靶标各设计 20/30/40/50 nt RNA aptamer,总共 6000 个候选。最佳 AF3 ipTM:FGFR2 = 0.88,B7-H3 = 0.85,TNFR1 = 0.81,PD-L1 = 0.80,CD3δ = 0.63。
ipTM > 0.60 的候选比例:FGFR2 = 41.50%,TNFR1 = 34.42%,PD-L1 = 17.17%,B7-H3 = 12.50%,CD3δ = 1.08%。平均约 20%。
读图结论:完全 de novo、跨多个蛋白靶标、最优样本能达到很不错的 AF3 置信度。但不同目标差异很大——CD3δ 成功率明显低,说明方法对靶标表面可设计性很敏感。而且这还是结构模型置信度,不等于实验 KD。
四、核心贡献总结
Similarity-guided 设计
在 NA-12 benchmark(6 个 RNA + 6 个 DNA 复合物)上:RNA 最大 ipTM 可达 0.93,DNA 最大 ipTM 可达 0.91,每个 target 的最大 ipTM 都超过 0.75。
与 de novo 相比,similarity-guided 整体更优——更高的最大 ipTM、更高的 pLDDT、更低的 iPAE。有参考序列先验时,搜索空间缩小,更容易找到高质量解。
Best-of-N 分析也很有实际指导意义:
| 采样数 N | De novo ipTM | Sim-guided ipTM |
|---|---|---|
| 1 | 0.64 | 0.63 |
| 10 | 0.79 | 0.79 |
| 100 | 0.82 | 0.84 |
| 300 | 0.855 | 0.86 |
前几十个样本增益最大,后面边际递减。如果算力有限,先采几十到一百个是比较划算的。
Target-selective 设计:EGFR vs HER2
作者选了一个非常合理的难题:正目标 EGFR domain III、负目标 HER2 domain III。两者同属 ErbB 家族,结构相似,脱靶风险真实存在。
总共 1800 个候选中,69.44% 对 EGFR 的 ipTM 高于 HER2。分 RNA/DNA 看:RNA 82.56% 倾向 EGFR,DNA 56.33%。
更严格标准(ipTM_EGFR > 0.50, ipTM_HER2 < 0.50, margin > 0.10)下,成功比例仍有 25-28%。这说明有一批候选同时具备正目标较高置信度、负目标较低置信度和明确 margin,支持了作者”可编程负设计”的主张。
与 ODesign 的对比
作者用相同 AF3 rescoring 做独立评价——这是公平比较里很重要的一点。
| NACraft | ODesign | |
|---|---|---|
| 范式 | 推理时优化器(test-time optimization) | 训练好的生成模型(diffusion-based) |
| 5 靶标 median ipTM | 0.46 | 0.43 |
| 20 个 setting 胜出 | 17/20(P = 8.2×10⁻⁴) | 3/20 |
| NA-12 target 胜出 | 10/11 | 1/11 |
作者特别强调:NACraft 的核心优势在于整体候选分布右移。对实验筛选来说,分布整体变好通常比极少数天选样本高分更有价值。
消融实验的关键发现
Similarity loss 权重不是越大越好
权重 0.4 时最大 ipTM 最高(0.94),权重 1.0 时 ipTM ≥ 0.80 比例最高。说明 sequence prior 的作用是重新分配高质量候选所在区域,并非单调提高性能。太弱没利用好先验,太强又限制探索。
最小内部损失点不一定是最终最好序列
序列在最小 loss 之后还会继续变化,AF3 评估质量总体保持稳定——后续阶段增加了序列多样性,同时没有系统性牺牲质量。但 target-selective 任务中,最小-loss checkpoint 有时更优,有任务依赖性。
创新与局限
6 个创新点
1. 首次系统地把 structure hallucination 扩展到核酸 aptamer 设计
2. 统一支持 RNA 和 DNA
3. Programmatic objective composition——bind / anti-bind / contact / similarity 像积木组合
4. Similarity-guided 把”沿已有序列继续改”纳入统一优化目标
5. Target-selective / negative design——真正落地时选择性常常比单纯 affinity 更关键
6. 训练-free,不需要为每个任务重新训练或微调
最大局限:缺实验验证
目前几乎完全是 in silico 证据。AF3/Boltz 给的是结构置信度代理指标,距离实验结合亲和力 KD、实际选择性、生物活性、稳定性或合成可行性还有差距。
尽管优化和验证模型分开了,但最终成败仍强依赖 AF3。如果 AF3 对某类蛋白-核酸界面存在系统偏差,结果可能被高估。
另外,目前只支持标准 RNA/DNA 碱基。很多高性能 aptamer 依赖修饰碱基(2’-F、2’-OMe、LNA)和化学修饰骨架,这部分还没覆盖。
值得后续关注的问题
1. AF3 ipTM 与真实亲和力到底相关性多强?这决定 NACraft 的实际价值上限。
2. Hotspot 指定对结果有多敏感?实际新靶点设计时,界面热点未必已知。
3. Target-selective 能否推广到更多相似蛋白家族?(kinase、cytokine receptors、viral strain variants)
4. 能否加入化学修饰核酸?
5. 能否和实验 SELEX 形成闭环?最有前景的路线:NACraft 先生成高质量候选库 → 实验筛选 → 再回流做 similarity-guided redesign。
一句话总结:NACraft 把核酸适配体设计从”固定任务的生成”推进到了“可编程目标驱动优化”。最有价值的贡献在于提出了一个统一的、可组合的核酸设计接口——一个真正意义上的可编程设计引擎。
论文:NACraft: Programmatic nucleic-acid aptamer design via all-atom structure-model feedback
作者:Heqin Zhu, Jiaqi Wang, Weibo Zhao, … Liqin Zhang, Odin Zhang
机构:Valhalla Technology / 香港中文大学 / 北京大学 / 浙江大学
DOI:10.64898/2026.08.15.744087
通讯作者
Odin Zhang(张昊天),英灵殿科技(Valhalla Technology)创始人兼 CEO,同时在香港中文大学攻读博士学位。他本科毕业于浙江大学物理学和药学双学位,硕士阶段获浙江大学竺可桢奖学金(校最高荣誉),后赴华盛顿大学 Baker Lab 工作并获得计算机科学硕士学位。2025 年创立英灵殿科技,专注于 AI 驱动的全模态分子设计,开发了 ODesign,该模型统一支持蛋白、DNA、RNA、小分子从头设计。主要研究方向包括 AI for Science、生物分子设计和计算机辅助药物设计,代表作发表于 Nature Computational Science、Nature Machine Intelligence、ICLR 和 Chemical Reviews 等。Google Scholar 引用 2400+,h-index 31。
Liqin Zhang(张丽琴),北京大学药学院药物分析学系助理教授、独立 PI。她本硕就读于北京大学药学院(2005–2011),博士毕业于佛罗里达大学化学系及 UF Health 癌症中心(2011–2016),后于斯坦福大学医学院从事博士后研究(2018–2019),并在 Thermo Fisher Scientific 担任科学家(2020–2021)。她的研究方向聚焦功能核酸探针的构建与应用、核酸适配体的模态设计与开发,以及药物靶标发现与药物研发。近年在 Nature Biomedical Engineering、JACS、Chem、Nano Letters 等期刊发表多篇代表性工作。Google Scholar 引用 5700+,h-index 32。
引用
Zhu, H., Wang, J., Zhao, W., Xu, Y., Su, H., Wang, J., … & Zhang, O. (2026). NACraft: Programmatic nucleic-acid aptamer design via all-atom structure-model feedback. bioRxiv. https://doi.org/10.64898/2026.08.15.744087