
Agentic campaign control for high-throughput de novo binder design
原文链接:全文
作者:Minkyu Jeon, Jinyeop Song, Jina Kim, Ellen D. Zhong
bioRxiv,2026 年 9 月 24 日
导读
蛋白质结合物设计工具越来越多——Complexa、BindCraft、BoltzGen、ProteinMPNN……面对有限的 GPU 预算,应该把算力分配给哪个工具、使用什么参数?普林斯顿大学 Ellen D. Zhong 团队提出 T-REX(Target-adaptive Rescue–Explore–eXploit),一个由 LLM 驱动的 campaign 控制器。它根据设计过程中不断积累的证据,动态切换补救(Rescue)、探索(Explore)和利用(eXploit)三种策略,在七个靶点上将结构唯一命中的吞吐量提升了约 2.4 倍。
一、研究问题
近年来,蛋白质结合物从头设计领域涌现了大量工具:生成式设计工具 Complexa(支持 beam search、best-of-N、Feynman-Kac steering、MCTS 四种搜索方式)和 BoltzGen,集成式设计流程 BindCraft,序列重设计的 ProteinMPNN,以及结构评估的 AlphaFold2-Multimer。每种工具有各自擅长的靶点和场景,没有任何单一生成器在所有靶点上都是最优的。
现实中的设计 campaign 会遇到多种困境:某个生成器没有产出可用结果;生成了结构但尚未完成评估;某个候选物非常接近成功,只差一项指标;设计符合质量标准但结构与已有结果重复;某条路线一开始有效,后来却不断产生重复结构。
如果始终运行同一个生成器,或者只根据历史命中率机械分配资源,就可能浪费大量计算。T-REX 将这个问题形式化为一个在线资源分配问题:在固定计算预算下,如何根据不断积累的证据动态选择工具、参数和操作对象,以最大化结构上彼此不同的合格结合物数量。它的定位就是一个”实验室主管”——不亲自设计蛋白质,而是观察已有结果,判断当前瓶颈,决定下一批 GPU 任务的分配。
二、方法核心:T-REX 的核心架构
T-REX 将蛋白质设计过程建模为一个持续的决策闭环:证据 → 假设 → 行动 → 新证据。整个系统分为三层:
结构化证据层(EvidenceSummary)。确定性代码整理所有已完成和进行中任务的信息,包括结构质量(pLDDT、iPAE、scRMSD)、结构新颖度(是否形成新的结构簇、重复率)、每条路线的 SU 产出和 GPU 成本、等待 AF2 评估的设计、候选物与 redesign 后代之间的亲缘关系,以及当前 GPU 资源。系统据此将 campaign 分为七种状态:低证据(low evidence)、持续高产(productive)、高产但重复(productive + duplication)、near-miss 富集、结构重复坍缩(duplicate collapse)、停滞(stalled)和深度停滞(deep stall)。
LLM 推理层。两个 LLM 智能体分工协作。Planner 基于证据摘要提出假设卡片(HypothesisCard),每张卡包含当前观察到的证据、对失败原因的假设、建议调用的工具和参数、预期改善的指标,以及该任务更偏 Rescue、Explore 还是 eXploit。Supervisor 对所有候选任务进行全局排序,分配 R/E/X 标签并指定后续任务的目标比例。两者均运行本地部署的 Qwen3.6-27B-FP8。
确定性执行层。LLM 的提议必须通过 Check + Build 验证——工具是否存在、参数是否越界、父候选物是否真实存在、输入结构是否完整、资源是否充足。通过后由确定性控制器负责 GPU 调度和异步执行:任何一个 GPU 任务完成后,结果立刻进入 campaign archive,EvidenceSummary 更新,空闲 GPU 立即接收新任务,其他 GPU 上的任务继续运行。
三种策略的含义
Rescue(补救):针对接近成功的候选物,修复其具体缺陷——如固定骨架用 ProteinMPNN 重新设计序列、开启 sequence hallucination、调整奖励权重、扩大局部搜索范围。核心思想是已经投入计算并接近成功的候选物中,可能蕴含比从零生成更高的价值。
Explore(探索):尝试尚未充分使用的生成器、新参数配置、不同采样噪声或更大的搜索宽度,防止过早锁定在某条路线。
eXploit(利用):继续运行已证明能产出新结构的具体配置(工具 + 参数 + 上游候选物来源)。
这种分层设计的一个重要原则是:LLM 负责解释经过整理的证据并提出假设,但不能直接启动程序或修改评价标准。所有实验定义、资源限制和质量指标由确定性代码管理。同时,campaign archive 是 append-only 的——失败任务、无输出任务、被否定的假设都会保留,让控制器知道哪些策略已经尝试过、哪些参数组合没有效果,避免重复失败的实验。
什么算”成功设计”?一个蛋白质结合物必须同时满足三项 AlphaFold2 指标:pLDDT ≥ 90(结合物折叠可信度)、normalized iPAE ≤ 7/31(界面可信度)、binder scRMSD < 1.5 Å(生成结构与 AF2 重折叠的一致性)。通过质量标准后,再用 Foldseek 按 TM-score 0.6 进行结构聚类,每个结构簇只算一个结构唯一命中(SU)。最终优化目标是每 GPU 小时获得的 SU 数量。
三、看图说话
Figure 1 · 把设计过程拆成证据、假设、行动
这张图想回答:T-REX 怎样把一次设计 campaign 变成”证据→假设→行动→新证据”的闭环?
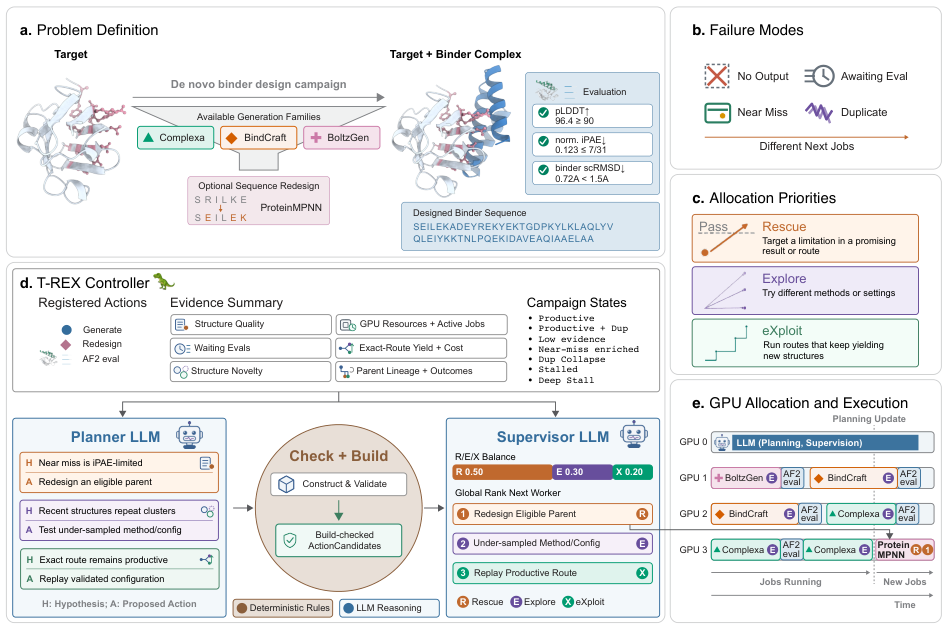
Figure 1. (a) 问题定义:固定算力下调度多个设计工具。(b) 四种失败模式。(c) Rescue / Explore / eXploit 三种分配优先级。(d) 证据摘要交给 Planner 与 Supervisor 两个 LLM,确定性控制器负责执行。(e) 任务在多张 GPU 上异步执行,结果回流成为新证据。
Panel a 给出问题:一个靶点,几个可选生成器(Complexa、BindCraft、BoltzGen,外加 ProteinMPNN 做序列重设计),右侧是合格标准——pLDDT ≥ 90、归一化 iPAE ≤ 7/31、binder scRMSD < 1.5 Å,三项都要过。
Panel b 是这篇文章的关键切分:没出结果、等待评估、差一点合格、结构重复,四种”没拿到新命中”的情况性质完全不同,后续该做的事也不同。Panel c 对应三种处理方式:Rescue 修已有的近似成功者,Explore 换方法或参数,eXploit 继续跑还在出新结构的路线。
Panel d 是控制器内部。左边是确定性代码整理出的证据摘要(结构质量、结构新颖度、各路线产出与成本、待评估任务、候选物亲缘、GPU 资源),据此把 campaign 判成七种状态。Planner 提出假设卡片,Supervisor 全局排序并给出 R/E/X 配额,中间的 Check + Build 负责校验工具、参数、父候选物是否合法。
Panel e 是执行时序:一张 GPU 跑 LLM,其余跑设计任务,任何任务一结束就立刻回流成证据、空闲卡马上接新任务。这张图传达的核心是 LLM 只负责解释证据和提假设,启动程序和评判标准都归确定性代码。
Figure 2 · 七个靶点上的吞吐量对比
这张图想回答:自适应调度比单个生成器、比非 LLM 控制器,到底多拿多少结构唯一命中?
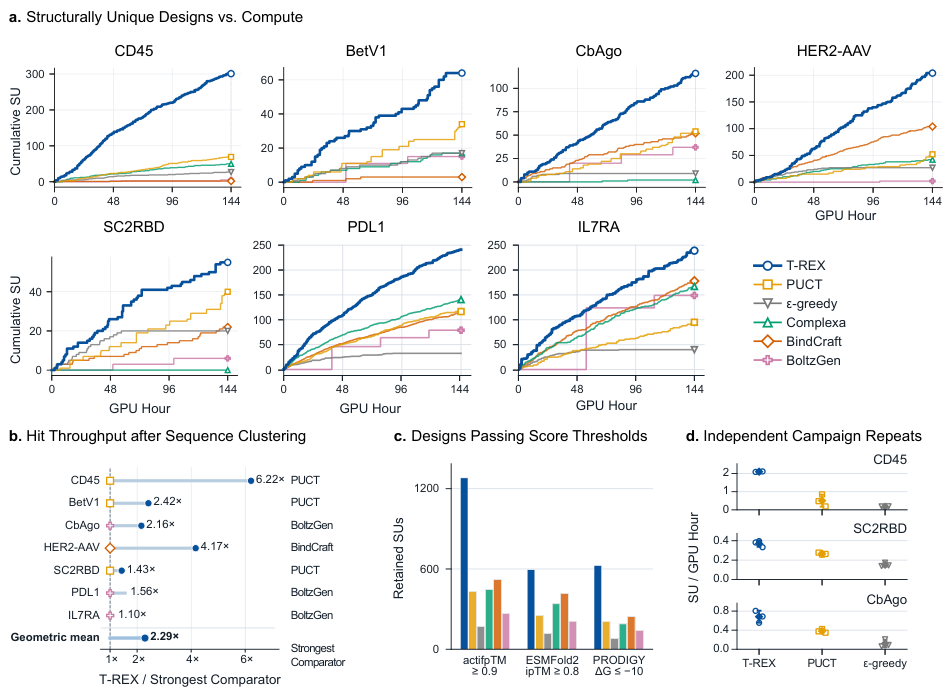
Figure 2. (a) 七个靶点上累积结构唯一命中(SU)随 GPU 小时的变化。(b) 改用 MMseqs2 70% 序列聚类后的吞吐量,相对每个靶点最强的对比方法。(c) 换用更严格的事后指标后保留的 SU 数。(d) CD45、SC2RBD、CbAgo 上三次独立 campaign 的吞吐量。
实验设置:每个 campaign 48 小时、144 H100 worker GPU 小时,另有一张卡专门服务 LLM。对照是三种单生成器(Complexa、BindCraft、BoltzGen)和两种非 LLM 自适应控制器(PUCT、ε-greedy)。合格设计再用 Foldseek 按 TM-score 0.6 聚类,每个簇只算一个结构唯一命中(SU)。
Panel a:七个子图里蓝色的 T-REX 曲线都在最上面,终点 SU 数全部最高,七个 campaign 合计 1,461 个 SU。注意每个靶点最强的单生成器并不相同——PDL1 上是 Complexa,HER2-AAV 上是 BindCraft,CbAgo 上是 BoltzGen,这正是固定跑一个工具会吃亏的地方。相对 PUCT 的几何平均增益 2.43 倍,相对各靶点最强单生成器 2.48 倍。
Panel b 把结构聚类换成 70% 序列一致性聚类,几何平均仍有 2.29 倍。Panel c 换三套更严格的事后指标(actifpTM ≥ 0.9、ESMFold2 ipTM ≥ 0.8、PRODIGY ΔG ≤ −10 kcal/mol)重新筛,蓝柱在三组里都明显最高,说明数量优势不是靠一堆勉强及格的设计堆出来的。
Panel d 是稳定性检查:三个靶点各跑三次独立 campaign,T-REX 的点聚得很紧且每次都高于 PUCT 和 ε-greedy。
Figure 3 · 三个回溯案例:针对失败原因换招
这张图想回答:遇到不同类型的失败,T-REX 的下一步具体差别在哪?
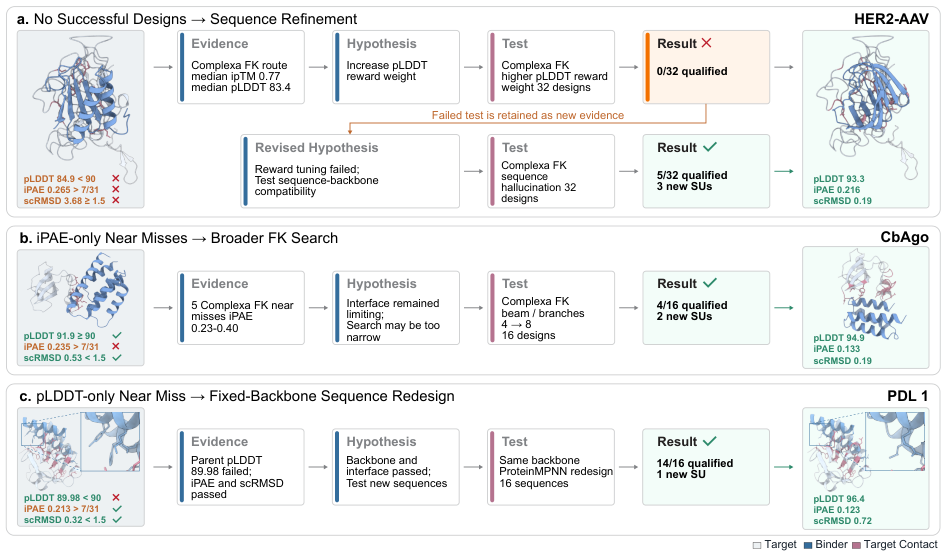
Figure 3. 三个回溯案例。(a) HER2-AAV:一批调奖励权重的设计全军覆没,改做序列精修后 32 个里 5 个合格、拿到 3 个新 SU。(b) CbAgo:只卡在 iPAE 的近似成功者促使扩大 Feynman–Kac 搜索,16 个里 4 个合格、2 个新 SU。(c) PDL1:只卡在 pLDDT 的候选物改用固定骨架的 ProteinMPNN 重设计序列,16 条里 14 条合格、1 个新 SU。橙色为未通过、绿色为通过的指标。
Panel a:假设被证伪后改假设。Complexa FK 路线的界面看着不错(中位 ipTM 0.77),但 pLDDT 只有 83.4。先假设是奖励权重不够,加大 pLDDT 权重跑 32 个设计,0 个合格。这条失败记录被留下来当新证据,假设改成”序列与骨架不兼容”,换成 sequence hallucination 后 5/32 合格,示例设计 pLDDT 93.3、scRMSD 0.19 Å。
Panel b:只差一项就扩大搜索。5 个候选物 pLDDT 和 scRMSD 都过了,只有 iPAE 略高于阈值。推断是界面搜索太窄,把 beam/branch 从 4 加到 8,4/16 合格。
Panel c:骨架可靠就只改序列。某候选物 pLDDT 89.98、阈值 90,iPAE 和 scRMSD 都已通过。判断骨架和界面没问题,固定骨架用 ProteinMPNN 重设计序列,14/16 合格,最高 pLDDT 96.4。
三个案例的共同点:动作是按具体失败原因选的。两个 campaign 近期 SU 数可能一样,瓶颈却完全不同,而 PUCT 和 ε-greedy 只看标量奖励,做不出这种区分。
Figure 4 · 策略分配确实随状态变化
这张图想回答:R/E/X 的比例真的跟着 campaign 状态和证据类型在变吗?Rescue 这一项是不是必需的?
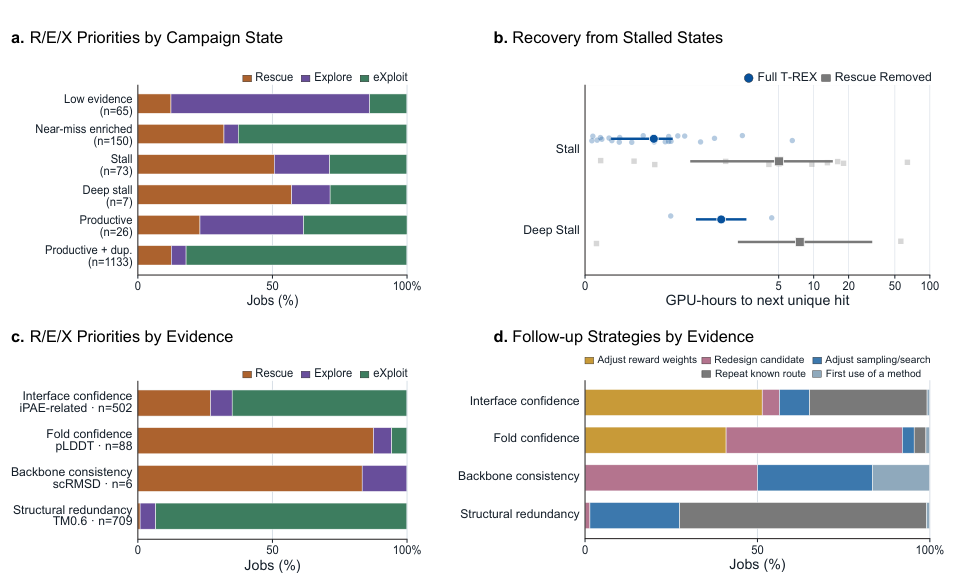
Figure 4. (a) 1,454 个生成与重设计任务按 campaign 状态分组的 R/E/X 比例。(b) 从进入停滞状态到下一个新 SU 所用的 GPU 小时,完整 T-REX 与去掉 Rescue 优先级的对照。(c) 1,305 个任务按主要证据类型分组的 R/E/X 比例。(d) 同一批任务按证据类型分组的后续策略。
Panel a:证据稀少时 74% 是 Explore——信息不够就先广撒网;进入停滞或深度停滞时 51% 是 Rescue——修近似成功者比从零再来划算;高产但重复时 82% 是 eXploit——重复率上升,但这条路线还在贡献新结构簇,值得继续。
Panel b 是消融,也是这张图最有说服力的部分。完整 T-REX 在 27 次进入停滞的事件里恢复了 26 次,去掉显式 Rescue 优先级后只有 20 次里的 14 次。恢复中位时间从 1.77 GPU 小时拉长到 5.04(深度停滞是 3.52 对 7.60),处于停滞状态的总时间占比从 3.8% 升到 27.7%。
Panel c、d 换成按证据类型看:pLDDT 问题 88% 走 Rescue,结构重复 93%、界面置信度 65% 走 eXploit;panel d 进一步显示具体动作的差别——折叠置信度问题多半去重设计候选物,结构冗余问题主要是调整采样和继续跑已知路线。
Figure 5 · 拿到的结构有多样吗
这张图想回答:这 1,461 个命中是不是同一种折叠的变体?它们落在靶点的同一个位置吗?
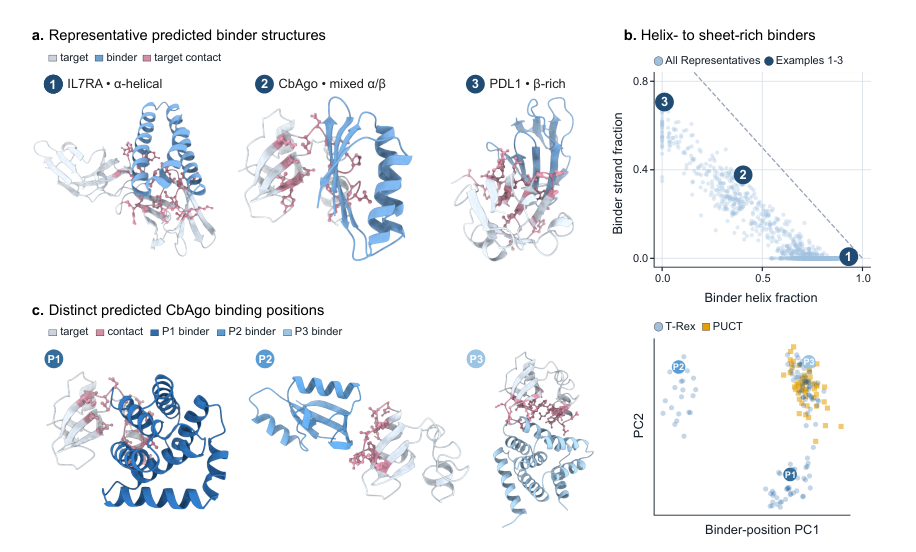
Figure 5. (a) 三个代表性复合物:α-螺旋型 IL7RA binder、α/β 混合的 CbAgo binder、β-rich 的 PDL1 binder。(b) 全部 1,461 个命中的二级结构组成(DSSP 计算),编号点对应 a 中的例子。(c) CbAgo 上落在不同预测结合位置的代表性命中。(d) 靶点坐标系下 binder 位置的主成分分析,T-REX(n = 116)与 PUCT(n = 54)。
Panel a、b:三个例子分别是纯螺旋、混合、以 β 折叠为主,对应 panel b 散点图的三个角落。散点沿反对角线铺开,说明命中覆盖了从全螺旋到全 β 的连续谱,而不是集中在一类折叠。把 binder 中至少 20% 残基为 β-strand 的算作 β-rich,T-REX 得到 308 个 β-rich 结构簇,第二名 BoltzGen-only 只有 95 个。
Panel c、d:把复合物按靶点对齐后,用 binder 全部 Cα 的平均位置代表它停在哪里。panel c 的三个例子明显落在 CbAgo 的不同区域;panel d 的 PCA 里 T-REX 的蓝点铺开成几团,PUCT 的黄点挤在一处。按每组 30 个代表重采样 1,000 次,binder 中心的中位两两距离 T-REX 31.2 Å、PUCT 9.97 Å。
四、核心贡献总结
这篇文章的贡献可以分成三层。
把”该跑哪个工具”写成了一个可调度的问题。设计 campaign 里”没拿到新命中”被拆成没出结果、等待评估、差一点合格、结构重复四种失败模式,再归纳成七种 campaign 状态,对应 Rescue / Explore / eXploit 三类动作。这套分类让后续决策有了明确依据,而不是只看一个标量奖励。
LLM 与确定性代码的分工。LLM 读的是整理好的结构化证据,不是原始历史记录;它只提假设和排序,启动任务、校验参数、判定合格都由确定性代码管。campaign archive 是只追加的,失败任务和被否定的假设都留着,所以控制器知道哪些路子已经试过。
效果有多方面证据支撑。七个靶点共 1,461 个结构唯一命中,相对 PUCT 的几何平均吞吐量提升 2.43 倍、相对各靶点最强单生成器 2.48 倍;换序列聚类、换更严格的事后指标、跑独立重复实验,优势都还在;消融实验显示 Rescue 这一项对走出停滞是必需的;产出的结构在二级结构组成和结合位置上都明显比对照分散。
五、局限与展望
所有结果均为计算预测,未经实验验证。1,461 个”命中”通过的是 AlphaFold2 指标和结构聚类,并不能直接证明实际表达、正确折叠、结合亲和力、特异性或体内功能。即使单个生成器的原始论文中产出过实验验证的结合物,也不能自动证明本研究中这些计算命中有效。
性能提升来自完整的 T-REX 控制策略(LLM 推理 + 确定性规则 + R/E/X 配额 + 状态分类 + 路线惩罚等),无法将增益简单归因于 LLM 本身——补充材料也承认,目前的比较没有隔离 LLM 推理的独立贡献。主表中七个靶点各仅一次 campaign,独立重复仅覆盖三个靶点。此外,吞吐量计算使用 worker GPU-hours,未包含 LLM 服务占用的额外 GPU;计入后优势从约 2.4 倍缩小至约 1.8–1.9 倍。论文为 bioRxiv 预印本,尚未经过同行评审。
通讯作者介绍
Ellen D. Zhong,普林斯顿大学计算机科学系助理教授。她本科毕业于弗吉尼亚大学,在麻省理工学院取得博士学位,期间开发了 cryoDRGN 系列工具,利用深度学习从冷冻电镜数据中解析蛋白质构象异质性,相关成果发表于 Nature Methods 等期刊。她的研究方向涵盖机器学习与结构生物学的交叉领域,包括蛋白质结构重建、构象动态分析和计算蛋白质设计。T-REX 的代码已在 GitHub 开源(ml-struct-bio/T-REX)。
引用
Jeon, M., Song, J., Kim, J., & Zhong, E. D. (2026). Agentic campaign control for high-throughput de novo binder design. bioRxiv. https://doi.org/10.64898/2026.09.22.753604