
Ambient Proteins: Training Diffusion Models on Low Quality Structures
原文链接:全文
作者:Giannis Daras, Jeffrey Ouyang-Zhang, Krithika Ravishankar, …, Daniel J. Diaz
bioRxiv,2025 年 7 月 5 日
导读
AlphaFold Database 包含超过 2 亿个预测结构,但大量低置信度(pLDDT)结构长期被主流生成模型丢弃。MIT CSAIL 与 UT Austin 的研究者提出 Ambient Protein Diffusion,将低 pLDDT 结构视为”已受到不同程度噪声污染”的数据,根据其质量限定参与训练的扩散时间阶段。配合基于几何相似性的 AFDB 重新聚类,一个仅 1670 万参数的模型在长蛋白生成的可设计性和多样性上全面超越 2 亿参数的 Proteina。
一、研究问题
训练蛋白质骨架生成模型需要大量三维结构数据。AlphaFold Database (AFDB) 提供了超过 2 亿个计算预测结构,但每条结构的质量参差不齐。AlphaFold 为每个残基提供置信度指标 pLDDT (predicted Local Distance Difference Test),实践中研究者通常设置阈值(如 pLDDT > 80),低于阈值的结构直接丢弃。
这种做法带来了系统性偏差:低 pLDDT 结构往往正好是长蛋白、多结构域蛋白和拓扑复杂的蛋白质。简单过滤使训练集偏向短而简单的蛋白质,削弱了模型生成 600-800 个残基长蛋白的能力。另一方面,这些低 pLDDT 结构并非完全错误——它们可能包含正确的局部结构域、合理的二级结构、长蛋白的总体尺寸信息和训练集中稀缺的拓扑类型,只是结构域间的相对朝向或长程相互作用预测不够准确,被 low predicted alignment error (pAE) 所反映。
核心问题在于:能否找到一种方法,在不引入预测误差的前提下,充分利用这些低质量结构中包含的长蛋白拓扑信息?
从数据分布来看,蛋白质越长、结构域越多,平均 pLDDT 往往越低。以 AFDB 数据为例,长度超过 500 个残基的蛋白质中,大量样本的平均 pLDDT 低于 80。如果统一要求 pLDDT > 80,短蛋白能保留大量样本,而长蛋白和多结构域蛋白则被大规模删除,训练集中包含的罕见拓扑类型随之流失。模型在训练中几乎看不到 600 个残基以上的复杂结构,推理时自然难以生成高质量的长蛋白。
二、方法核心:噪声可以”抹平”结构预测误差
Ambient Protein Diffusion 的核心思想源自一个简洁的数学观察。设真实蛋白质结构分布为 p0,AlphaFold 预测结构分布为 p̃0。AlphaFold 的误差来源复杂——局部坐标偏差、结构域方向错误、无序区域建模不准——无法像传统去噪问题那样明确写出退化过程。但对两个分布分别添加高斯噪声后,随着噪声增加,二者之间的 KL 散度单调递减;当噪声足够大时,AlphaFold 的原始预测误差已被扩散噪声覆盖,两个分布趋于一致(称为”分布合并”)。
基于这一性质,作者为每个 AlphaFold 结构根据其 pLDDT 分配一个最低噪声门槛:
pLDDT ≥ 90:可参与全部扩散时间 [1, 1000]
80 ≤ pLDDT < 90:仅参与中高噪声 [600, 1000]
70 ≤ pLDDT < 80:仅参与最高噪声 [900, 1000]
pLDDT < 70:不使用
高质量结构可以在低噪声阶段教模型精细的局部几何;中质量结构在更高噪声阶段提供中尺度构象信息;低质量结构则在最高噪声区域提供长蛋白和复杂拓扑的粗粒度分布信息。一个直观类比:清晰照片可以学习纹理细节,而模糊照片把所有照片都进一步模糊后,原始的清晰与否已经不重要,仍然可以从中学习物体的大体轮廓和类别分布。
训练时还做了三项关键调整。第一,对每个低质量结构的预加噪只采样一次并固定——如果每个 epoch 都重新采样噪声,模型可能通过平均不同噪声实现,逐渐恢复原始的 AlphaFold 误差。第二,修改扩散损失函数:普通扩散模型以干净结构作为监督目标,但低质量结构没有可信的干净目标,只有预加噪版本。作者利用 Ambient Diffusion 的条件期望关系,让模型的预测与当前高噪声结构按系数 α(t) 线性组合后去预测可观测的预加噪版本,同时引入权重因子 w(t) 补偿 α 趋近零时的梯度消失。第三,改变采样顺序——先均匀采样扩散时间再选取满足门槛的蛋白质,确保低、中、高噪声时间都得到均衡训练。
三、看图说话
Figure 1 · 长蛋白生成的总体表现
这张图想回答:在生成长蛋白时,Ambient 的可设计性和多样性真的比现有方法好吗?
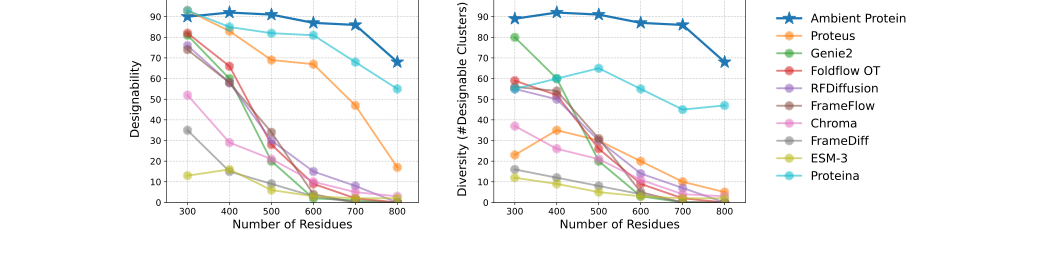
Figure 1. 长蛋白生成表现。1670 万参数的 Ambient 在 300–800 残基各长度上的可设计性(左)与多样性(右),对比 2 亿参数的 Proteina 等方法。
左图是可设计性、右图是多样性,横轴都是蛋白长度。蓝色的 Ambient 曲线在所有长度上都领先 RFDiffusion、Genie2、FrameFlow、Chroma 等,且用的是 只有 1670 万参数的模型。
优势在长蛋白上最明显:长度 700 时可设计性从 Proteina 的 68% 升到 86%、多样性从 45% 升到 86%。而且 Ambient 的多样性几乎等于可设计性——700 残基时 100 个样本里 86 个可设计,恰好形成 86 个不同结构簇,几乎没有重复。
Figure 2 · 按 pLDDT 分阶段参与训练
这张图想回答:不同质量的 AlphaFold 结构,怎样只在合适的噪声阶段参与训练?
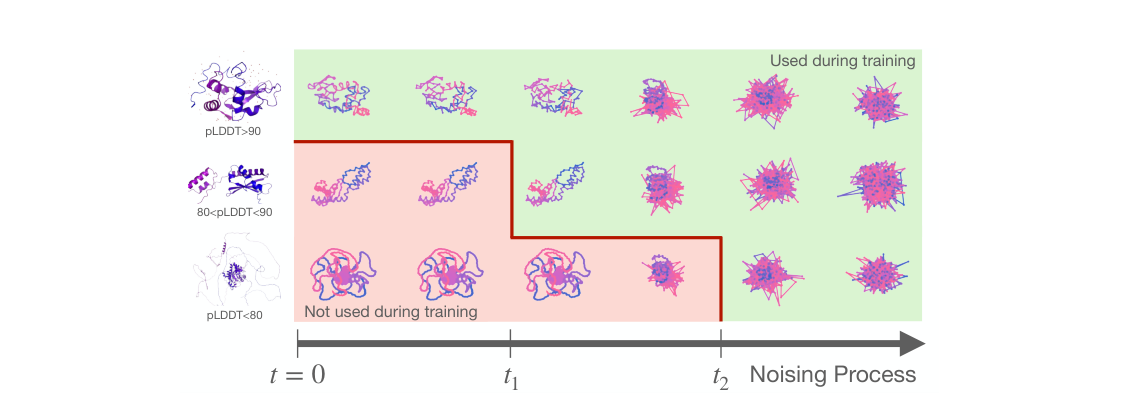
Figure 2. 方法概览。前三行分别是高、中、低 pLDDT 的 AlphaFold 结构从左到右逐步加噪的过程;低质量结构只在高噪声阶段才用于训练。
核心观察:对真实结构分布和 AlphaFold 预测分布分别加高斯噪声,噪声越大两者的 KL 散度越小;噪声足够大时,AlphaFold 的预测误差就被噪声盖过,两个分布趋于一致。
于是按 pLDDT 给每个结构定一个最低噪声门槛:pLDDT ≥ 90 参与全部扩散时间 [1,1000],80–90 只参与 [600,1000],70–80 只参与 [900,1000],低于 70 不用。高质量结构教精细几何,低质量结构只在最高噪声区提供长蛋白的粗粒度轮廓。
类比:清晰照片学纹理细节,模糊照片再统一模糊后仍能学物体的大致轮廓和类别分布。
Figure 3 · 按几何相似性重新聚类 AFDB
这张图想回答:原始 AFDB 聚类为什么不适合训练生成模型,重聚类怎么做?
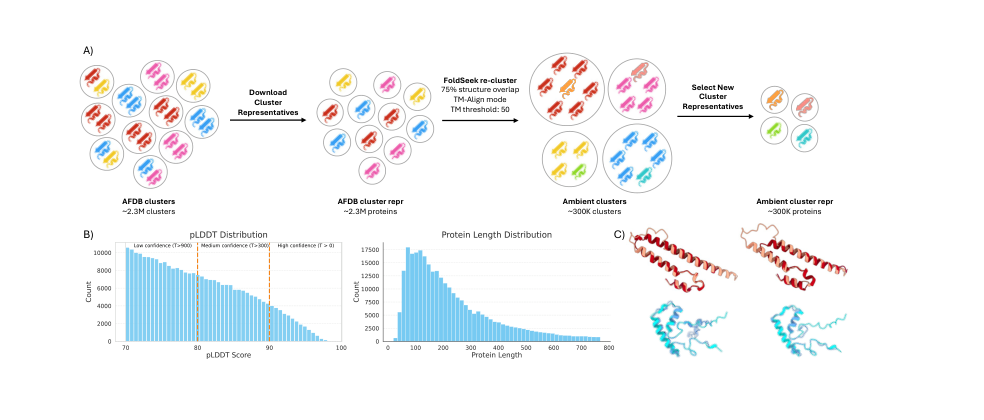
Figure 3. 重新聚类 AFDB。(A) 从 230 万个 AFDB 簇代表出发,用 FoldSeek 以 TM-Align、TM 阈值 0.5、覆盖率 0.75 按几何相似性重聚为约 29.2 万簇。(B) 重聚类后数据的 pLDDT 与蛋白长度分布。(C) 结构示例。
- Panel A:原始 230 万个 AFDB 簇是为研究进化设计的,按序列同源性加 3Di+AA 比对聚类,结果是三维形状极像但进化远的蛋白被分到不同簇,大型超家族被过度表示。作者从 pLDDT > 70 的约 129 万簇代表出发,改用纯几何的 TM-Align、阈值 0.5、覆盖率放宽到 0.75(迁就长无序末端),重聚成 约 29.2 万个几何簇,分布更均衡。
- Panel B、C:重聚类后数据的 pLDDT 分布(分低/中/高置信区)和长度分布,以及几个结构示例。长蛋白、复杂拓扑的样本得以保留,正是过去被 pLDDT>80 一刀切掉的那部分。
Figure 4 · 消融:提升确实来自 Ambient 训练
这张图想回答:性能提升到底是靠更大模型和重聚类,还是靠低质量数据的训练方法?
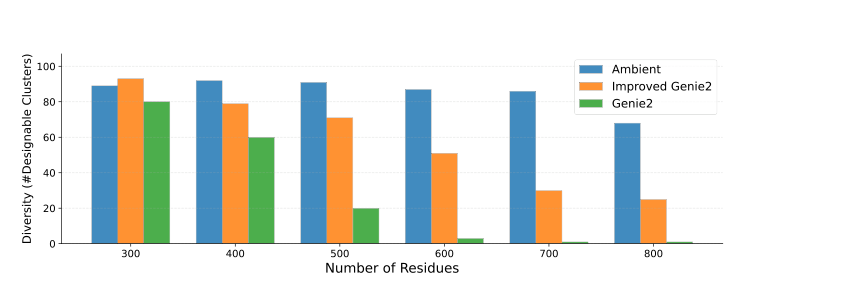
Figure 4. 消融实验。Improved Genie2(橙色)在架构、参数、数据集、训练长度上都与 Ambient 一致,唯一区别是不用 Ambient 的低 pLDDT 训练方法。
Improved Genie2 把除”低 pLDDT 训练方法”外的改进(更大架构、重聚类、长蛋白微调)都用上了。300 残基时它甚至略高(93 vs 89),但越往长越被拉开:500 残基 71 vs 91,600 残基 51 vs 87,700 残基 30 vs 86,800 残基仅 25 vs 68。这组对照排除了规模、训练长度、聚类方式等混淆因素,证明长蛋白的大幅提升主要来自对低 pLDDT 数据的质量感知训练。
Figure 5 · 短蛋白的可设计性–多样性权衡
这张图想回答:在短蛋白上,Ambient 能不能同时做到高可设计性和高多样性?
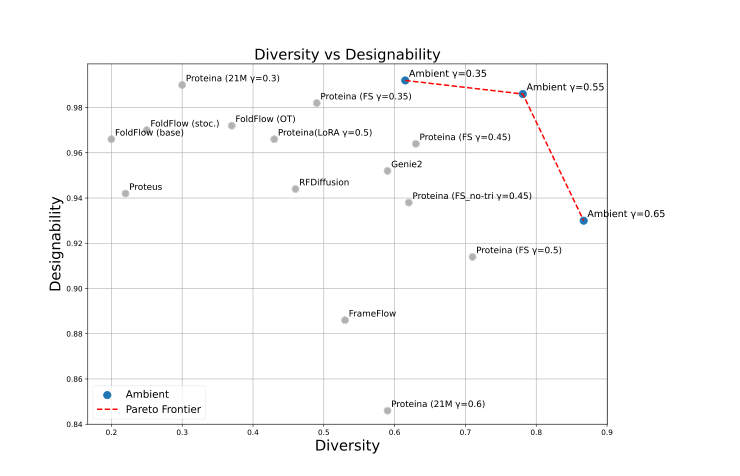
Figure 5. 短蛋白(≤256 残基)生成的可设计性–多样性权衡。横轴多样性、纵轴可设计性,蓝点为 Ambient 在不同噪声缩放 γ 下的结果,红色虚线为 Pareto 前沿。
右上角越好(又可设计又多样)。蓝色的 Ambient 点(不同 γ)完全占据了 Pareto 前沿(红色虚线),把 Proteina、Genie2、RFDiffusion、FoldFlow 等都压在下方。γ = 0.55 时达到 98.6% 可设计性、0.781 多样性,而模型比对手小约 12.88 倍,且没有用任何高阶采样器或自引导。
四、核心贡献总结
模型基于 Genie2 的 SE(3) 等变骨架扩散架构,将 triangle layers 从 5 层增加到 8 层,参数量约 1670 万。长蛋白模型分三阶段训练:第一阶段最大长度 256(18 小时),第二阶段 512(48 小时),第三阶段 768(48 小时),使用 48 张 GH200 GPU。相比之下,Proteina 使用约 2 亿参数、约 78 万训练结构和 128 张 A100 训练约 14 天。
长蛋白无条件生成
对长度 300-800 的蛋白质,每个长度生成 100 个骨架。可设计性(Designability)的验证流程为:ProteinMPNN 为每个骨架生成 8 条序列,ESMFold 重新折叠这些序列,取最小 RMSD(scRMSD),scRMSD < 2 A 即为可设计。多样性(Diversity)则对可设计结构用 FoldSeek 以 TM-score 0.5 聚类,报告独特结构簇数量。
结果显示,Ambient Protein Diffusion 在所有测试长度上均表现优异,全面超过 RFDiffusion、Genie2、FrameFlow、Chroma 等已有方法。在 300-500 残基范围,可设计性稳定在 90% 以上,与 Proteina 相当甚至更高。优势在长蛋白上尤为突出:长度 700 时,可设计性从 Proteina 的 68% 提升至 86%,多样性从 45% 提升至 86%;长度 800 时,可设计性从 55% 提升至 68%,多样性从 47% 提升至 68%。
值得注意的是,Ambient 的多样性几乎等于可设计性——长度 700 时 100 个生成样本中有 86 个可设计,而这 86 个恰好形成 86 个不同的结构簇,意味着几乎每个可设计蛋白质都是独特的,没有明显的结构重复。Proteina 在长度 700 时虽有 68 个可设计结构,但只形成 45 个簇,说明其可设计结构中存在较多重复或高度相似的生成结果。
消融实验:提升确实来自 Ambient 训练
为区分不同改进的贡献,作者训练了一个 Improved Genie2:架构、参数量、数据集和训练长度都与 Ambient 完全一致,唯一区别是没有使用 Ambient 的低 pLDDT 数据训练方法。
300 个残基时两者差距不大(Improved Genie2 甚至略高:93 vs 89),但随着蛋白质增长差距迅速拉大:500 残基时 71 vs 91,600 残基时 51 vs 87,700 残基时 30 vs 86,800 残基时仅 25 vs 68。蛋白质越长,低 pLDDT 结构中独有的长蛋白训练信号就越重要。这组严格的对照实验排除了模型规模、训练长度和数据聚类方式等混淆因素,有力地证实长蛋白性能的大幅提升主要来自对低 pLDDT 数据的质量感知训练方法。
短蛋白与 Motif Scaffolding
在 50-256 残基的短蛋白生成中,作者共生成 1,035 个结构并改变反向扩散的噪声缩放参数 γ 来探索可设计性与多样性的权衡。Ambient 在 γ = 0.55 时达到 98.6% 可设计性和 0.781 多样性,同时超过 Genie2(95.2%/0.59)和 Proteina(96.4%/0.63),建立了新的可设计性-多样性 Pareto 前沿。
在 motif scaffolding 条件生成任务中——给定一个或多个功能性局部结构,让模型在其周围生成完整蛋白质骨架——Ambient 同样表现出色。在 24 个单 motif 任务上生成 1923 个独特成功支架(Genie2 为 1445,Proteina 为 2094),尽管参数量只有后者的约 1/12 且未针对该任务专门优化,属于零样本应用。多 motif 任务上,Ambient 共生成 89 个独特成功结构、解决 5/6 个问题(Genie2 为 40 个/4 个),其中 2B5I 任务只有 Ambient 成功生成了有效解。更丰富的训练分布使模型拥有更多样的结构”词汇”,增强了在受约束条件下补全支架的能力。
五、局限与展望
pLDDT 作为质量指标比较粗糙,将整个蛋白质压缩为单个数值,无法表达某些结构域准确而另一些不准确、或局部无序区与结构域间方向错误等情况。更好的方法可能使用 per-residue pLDDT 或 pAE 矩阵实现残基级别的自适应噪声门槛。pLDDT 到扩散时间的三级映射([1,1000]、[600,1000]、[900,1000])主要靠经验调节,没有直接估计真实的 KL 合并时间。方法尚未使用 pLDDT < 70 的结构和 AFDB 簇内的全部成员,可利用的数据规模仍有很大扩展空间。此外,所有评估基于计算验证(ProteinMPNN 逆折叠 + ESMFold 重折叠),生成蛋白质能否稳定表达、正确折叠并具有目标功能仍需实验室验证。本文作为 2025 年 7 月发布的 bioRxiv 预印本,也尚未经过同行评审。
启示
这项工作最核心的观念转变是:数据质量是一个连续谱,一个样本可能不适合提供精细监督,却仍然适合在粗粒度尺度上提供有价值的分布信息。在扩散模型中,不同扩散时间天然对应不同尺度——低噪声阶段学习精细局部几何,高噪声阶段学习全局拓扑和粗粒度分布。将数据质量与信息尺度对应,纳入低质量数据扩大覆盖范围,同时限制其参与的扩散阶段保护结构质量,就能同时提升可设计性和多样性。这一思路具有很强的通用性,可能适用于低分辨率冷冻电镜结构、不完整分子构象、噪声医学影像以及由旧模型产生的伪标签数据等质量不均匀的科学数据场景。
通讯作者介绍
本研究的共同第一作者 Giannis Daras 和 Jeffrey Ouyang-Zhang 分别来自 MIT 计算机科学与人工智能实验室(CSAIL)和德克萨斯大学奥斯汀分校(UT Austin)计算机科学系。其他作者包括 Krithika Ravishankar、William Daspit 和 Daniel J. Diaz(均来自 UT Austin 计算机科学系)。资深作者 Costis Daskalakis 是 MIT CSAIL 教授,研究方向涵盖算法博弈论、计算复杂性与机器学习理论,曾获 Nevanlinna Prize(现 IMU Abacus Medal),近年来在生成模型理论方面发表了一系列有影响力的工作。Qiang Liu 是 UT Austin 计算机科学系副教授,研究方向为机器学习方法论。Adam Klivans 是 UT Austin 计算机科学系教授,专注于计算学习理论。该团队此前提出了 Ambient Diffusion 框架,首次证明可以在仅观测到损坏样本的条件下训练扩散模型,本文将这一框架推广到蛋白质结构生成领域,为利用大规模计算预测数据中的低质量部分提供了新的方法论范式。
引用
Daras, G., Ouyang-Zhang, J., Ravishankar, K., Daspit, W., Daskalakis, C., Liu, Q., … & Diaz, D. J. (2025). Ambient Proteins: Training Diffusion Models on Low Quality Structures. bioRxiv. https://doi.org/10.1101/2025.07.03.663105