
Atom-level enzyme active site scaffolding using RFdiffusion2
原文链接:全文
作者:Woody Ahern, Jason Yim, Doug Tischer, …, David Baker
Nature Methods,2026 年 1 月
RFdiffusion(RFD1)在 2023 年开启了蛋白质生成式设计的新时代,但酶活性位点设计对它来说始终是一块”硬骨头”——催化残基的侧链原子必须精确到亚埃级别,而 RFD1 只能操作残基级的骨架 frame,对侧链原子位置无能为力。
David Baker 团队推出的 RFdiffusion2(RFD2)彻底打破了这个瓶颈:模型直接在原子坐标上做扩散,输入可以只是几个功能基团原子的三维坐标——不需要指定它们属于哪个残基、在序列哪个位置、采什么旋转异构体,模型自己推断一切。
在包含 41 个酶活性位点的 AME benchmark 上,RFD2 全部 41/41 解决(RFD1 仅 16/41);更关键的是,团队从量子化学计算的 theozyme 出发,实际设计并实验验证了 5 种功能酶,其中最优锌水解酶的 kcat/KM 达到 53,000 M-1s-1——每种酶只测了不到 96 个设计就找到了活性分子。
一、研究问题
要理解 RFD2 为什么重要,先要清楚 RFD1 在酶活性位点设计上卡在了哪里。
RFD1(Nature 2023)的表示粒度是残基级:每个残基被编码为一个刚体 frame(Cα 坐标 + 骨架朝向)。这种表示对蛋白质骨架的整体拓扑设计非常高效,但酶活性位点设计有一个根本性的额外要求——催化残基的侧链原子必须精确排布在指定的三维坐标上。
RFD1 处理酶设计时,用户需要预先提供:
- 序列索引:每个催化残基在最终序列中的具体位置
- 旋转异构体:通过逆向 rotamer 采样,从侧链原子坐标反推骨架位置
- 骨架 frame:在残基级表示下指定 motif 的位置和朝向
这个流程引发了组合爆炸:搜索空间 = L!/(L-M)!(序列位置排列)× M 种旋转异构体状态。当活性位点涉及的催化残基来自多个不连续的序列片段(即多个”residue islands”)时,RFD1 的搜索空间急剧膨胀,成功率随之骤降。
在后来的 AME benchmark 测试中,RFD1 仅能解决 41 个活性位点中的 16 个,而且几乎所有失败案例都集中在含 4 个以上 residue islands 的复杂活性位点上。
二、方法核心:RFD2 的核心升级:三个层次的突破
RFD2 的改进可以从三个层次理解:更灵活的 motif 表示、更强大的神经网络架构、更稳定的训练框架。
这张图想回答:RFD2 如何同时扩散骨架 frame 和侧链原子,实现全原子酶活性位点搭建?
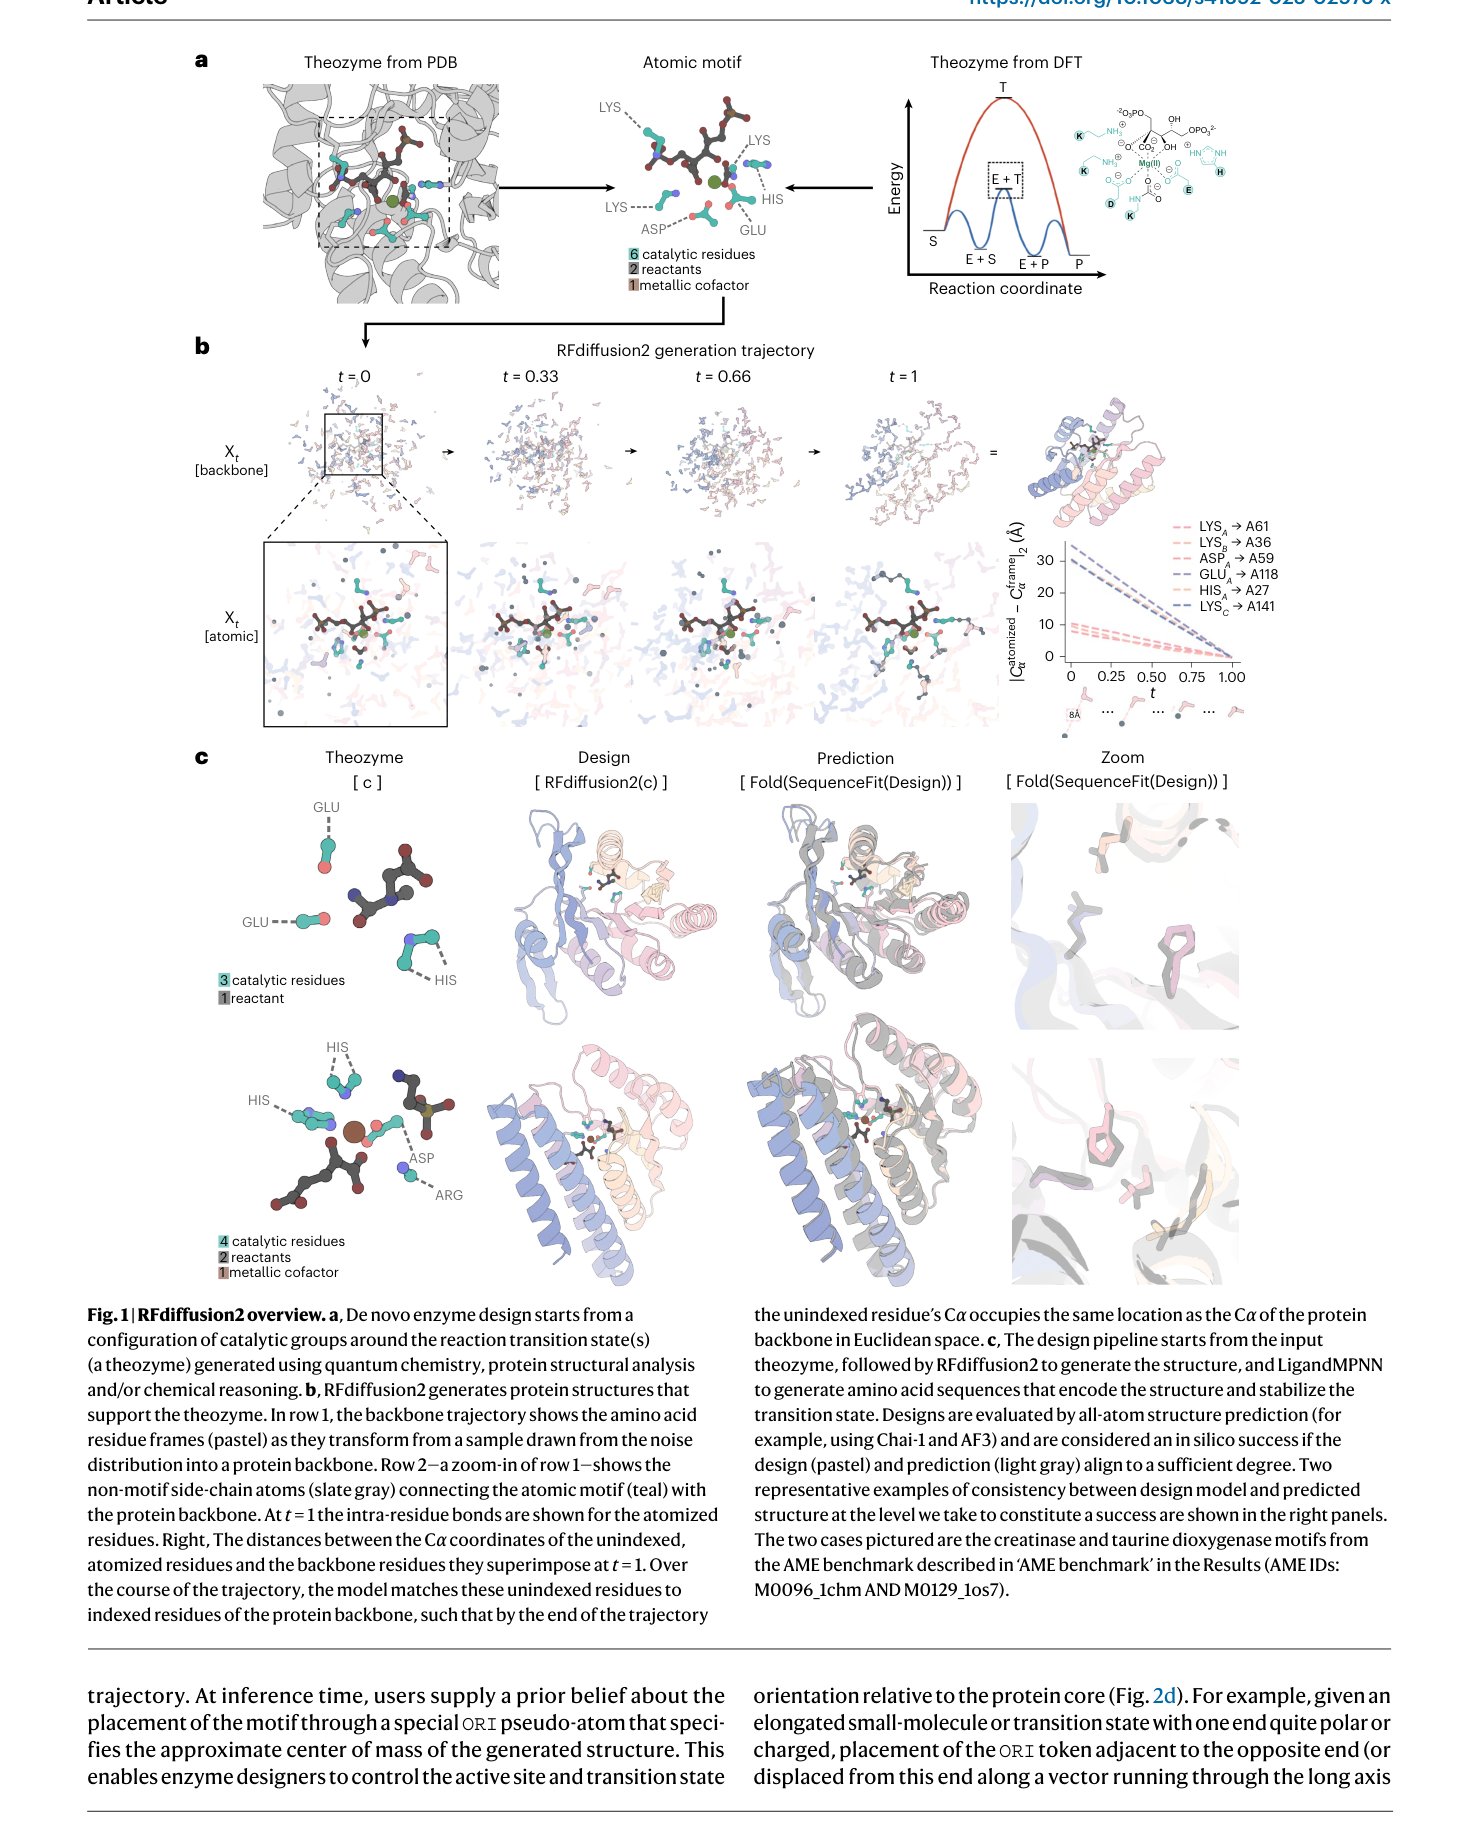
Fig 1 | RFdiffusion2 总览。(a) theozyme 概念:从 PDB/DFT 出发定义原子级 motif 和反应坐标;(b) 生成轨迹:骨架 frame 和原子级侧链同步扩散,unindexed 残基自动匹配到序列位置;(c) 两个设计示例(creatinase 和 taurine dioxygenase motif)。
升级 1:原子级 motif 表示——从”告诉模型答案”到”让模型自己推断”
RFD2 支持三种由粗到细的 motif 输入方式,灵活度逐级递增:
- Backbone motif(类似 RFD1):指定骨架 frame 位置 + 序列索引 + 旋转异构体 → 灵活度最低
- Atomic motif:只指定侧链功能基团原子的坐标,不指定骨架 → 模型自行推断 rotamer
- Unindexed atomic motif:只指定原子类型和坐标,连残基类型和序列位置都不指定 → 模型同时推断 rotamer 和 sequence index
最后一种是核心突破:模型同时生成蛋白质骨架、将催化残基分配到序列位置、并确定它们的旋转异构体——整个组合搜索问题被模型内化了。
升级 2:RoseTTAFold All-Atom 架构
RFD1 的底层网络是 RoseTTAFold,每个残基只有一种表示——刚体 frame。RFD2 采用 RoseTTAFoldAA,引入了扩展表示:
- 每个残基可以表示为 frame(骨架),也可以表示为全部重原子坐标(”atomized”)
- 训练时随机选择部分残基做 atomize,模型学会在 frame 和原子两种表示之间切换
- 小分子配体也用显式原子坐标表示,直接参与扩散过程
- “Unindexed residue”的实现方式:将催化残基复制并剥除身份信息,模型在扩散过程中学习将它们放到正确的序列位置
升级 3:Flow matching 替代 DDPM
RFD1 使用 DDPM(去噪扩散概率模型),需要辅助 loss 和 self-conditioning 才能稳定训练。RFD2 改用 flow matching:
- 对 SE(3) 上的 frame 使用黎曼 flow matching,对 R³ 中的原子坐标使用高斯 flow matching
- 关键技巧——“stochastic centering”:训练时不以 motif 为中心(会泄露位置信息),而是对居中后的结构加随机小平移
- 结果:从随机初始化直接稳定训练,不需要辅助 loss,不需要 self-conditioning
- 训练成本:24 块 A100 GPU 上仅训练 17 天
升级 4:精细条件控制——RASA、Partial ligand、ORI token
除了 motif 本身,RFD2 还支持三种额外的原子级条件输入,让设计者对活性位点的微环境拥有更精确的控制:
- Ligand atom RASA:为配体的每个原子标注期望的溶剂可及度(完全暴露 / 完全埋藏 / 中间态),控制底物嵌入活性口袋的深度
- Partial ligand:只提供配体或过渡态的部分原子坐标,模型推断其余构象——当只知道反应中心的局部几何时尤其有用
- ORI token:一个特殊的伪原子,指定 scaffold 质心相对于配体的大致方位,控制活性位点的朝向和结合口袋的空间分布
三、看图说话
为了系统评估酶活性位点 scaffolding 的能力,团队构建了 AME(atomic motif enzyme)benchmark:从 M-CSA(Mechanism and Catalytic Site Atlas)数据库手工筛选 958 个催化活性位点,精选出 41 个覆盖 EC 1-5 类的多样性活性位点。
这张图想回答:在 AME benchmark 的 41 个酶 motif 上,RFD2 比 RFD1 的成功率高多少?
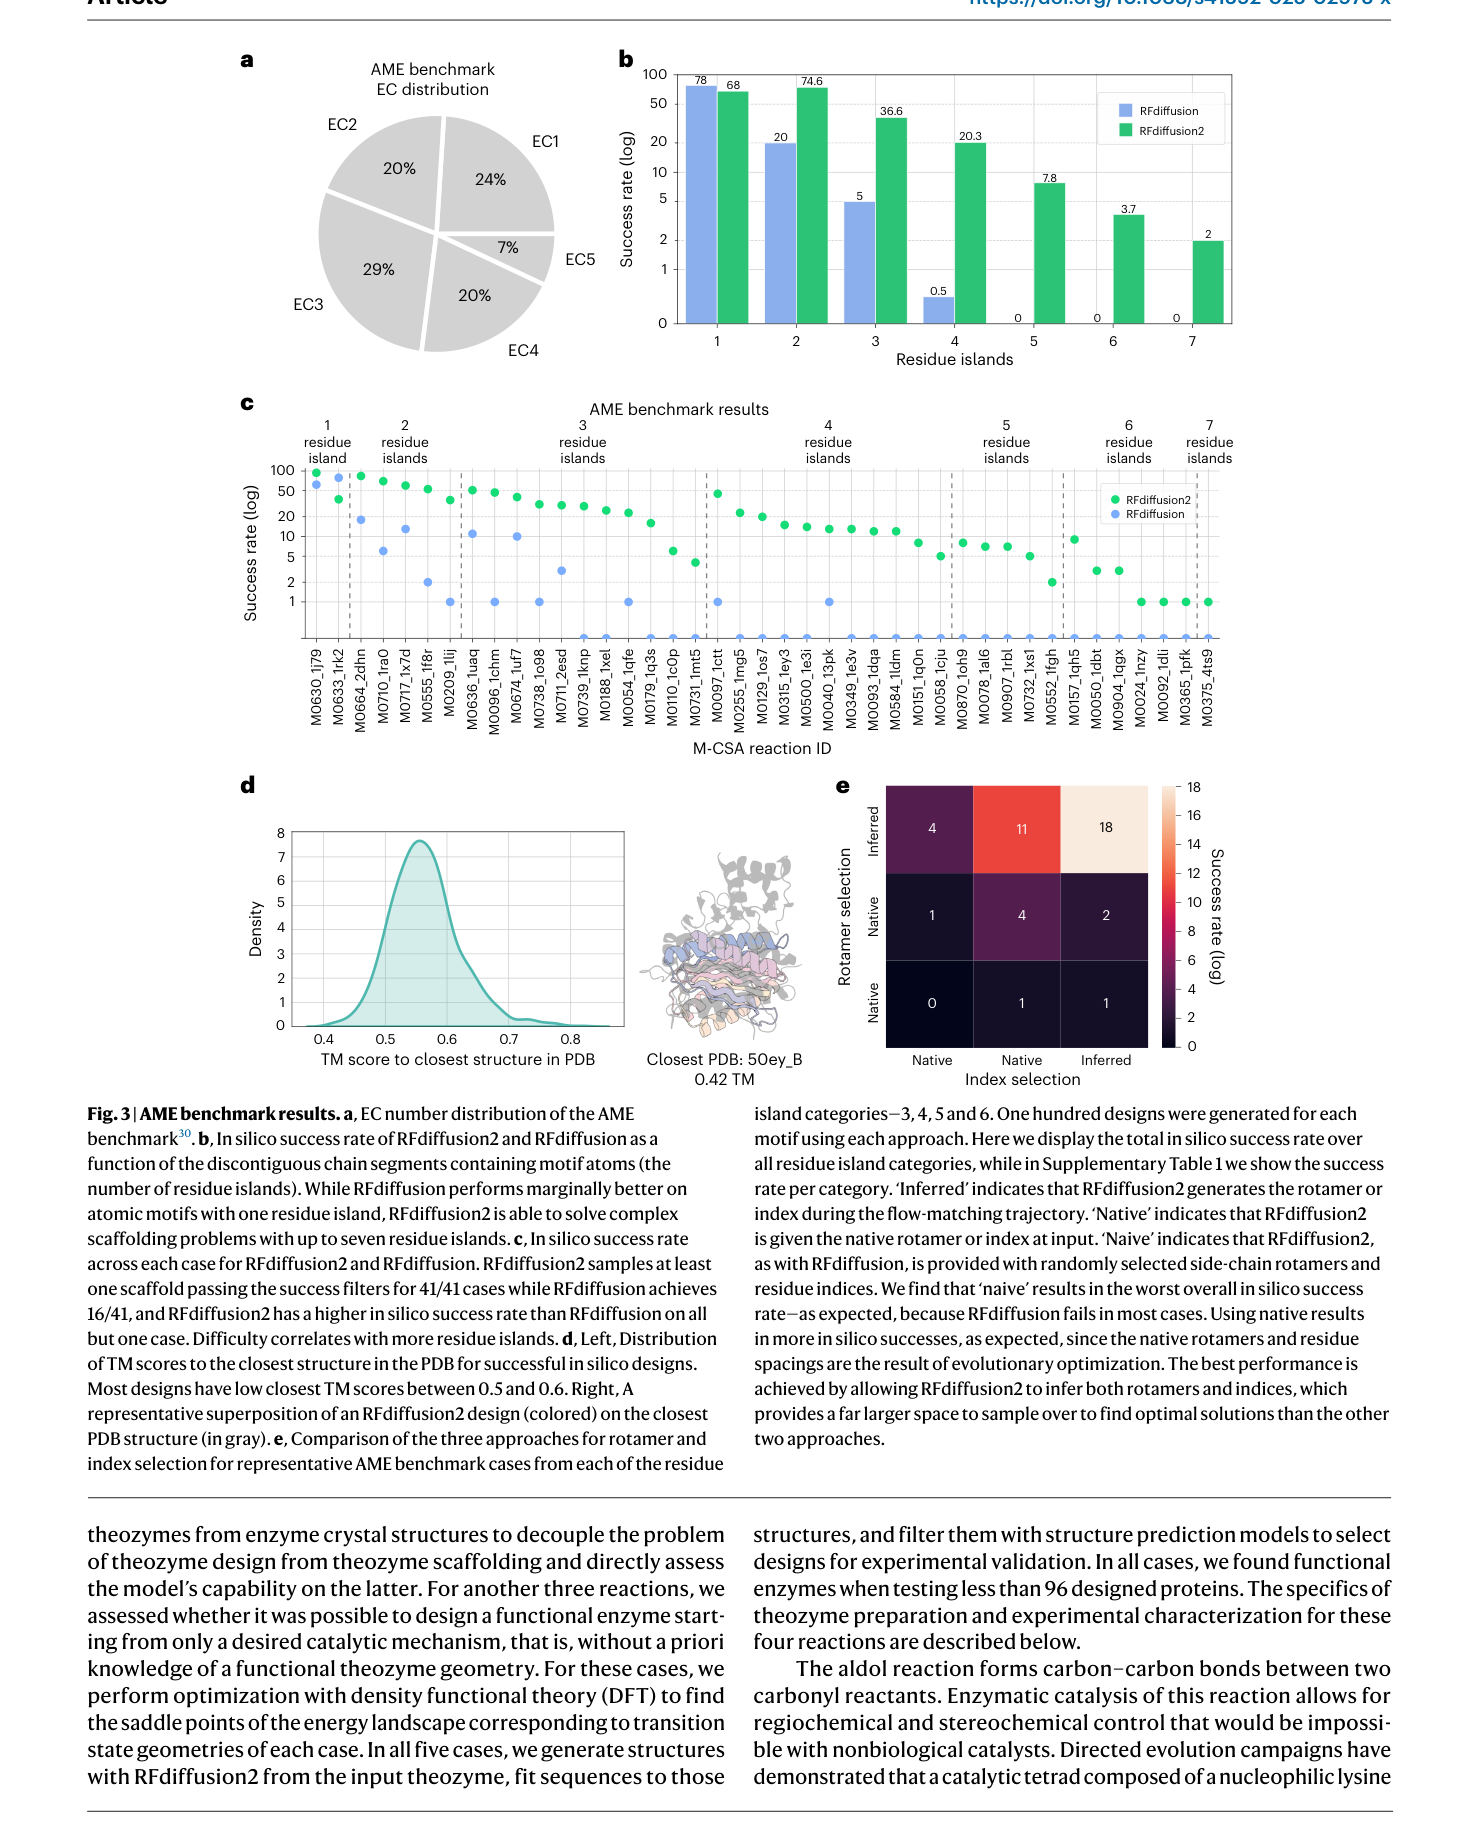
Fig 3 | AME benchmark 结果。(a) EC 分类分布;(b) 按 residue islands 数量的成功率对比——RFD2 在复杂 motif 上优势巨大;(c) 逐案例散点;(d) TM score 显示设计结构的新颖性;(e) rotamer/index 推断策略对比矩阵。
核心结果
- RFD2 解决了 41/41 个活性位点(每个至少 1 个通过 scaffold),RFD1 仅 16/41
- 在 40/41 个案例中 RFD2 的表现优于 RFD1
- 差距随复杂度扩大:当 residue islands ≥ 4 时,RFD1 几乎全部失败,RFD2 仍保持高成功率
- 模型推断优于人工指定:消融实验比较了三种策略——naive(随机采样 index + rotamer)、native(给真实结构的 index + rotamer)和 inferred(让模型自行推断)。结果 inferred 策略的成功率最高,甚至优于 native。这说明模型在更大的搜索空间中找到了比天然解更好的排布方案
- 在含 4 个以上 residue islands 的复杂案例上,naive 策略几乎全部失败——组合爆炸使随机采样无法奏效
- 设计结构具有结构新颖性:与 PDB 中最近结构的 TM score 多在 0.5-0.6,说明生成的是全新折叠
这组数据最重要的信息是:RFD2 把酶活性位点 scaffolding 从”只能处理简单 motif”推进到了”任意复杂度的活性位点都能处理”。16/41 和 41/41 的差距,本质上反映的是残基级表示和原子级表示的能力鸿沟。
四、核心贡献总结
计算 benchmark 证明了 RFD2 的 scaffolding 能力,但最终检验是实验室里的湿实验。团队测试了两条路线:从晶体结构提取的 theozyme 和从密度泛函理论(DFT)计算推导的 theozyme。
这张图想回答:从最小化学约束出发,RFD2 设计的五种功能酶是否在实验中检测到催化活性?
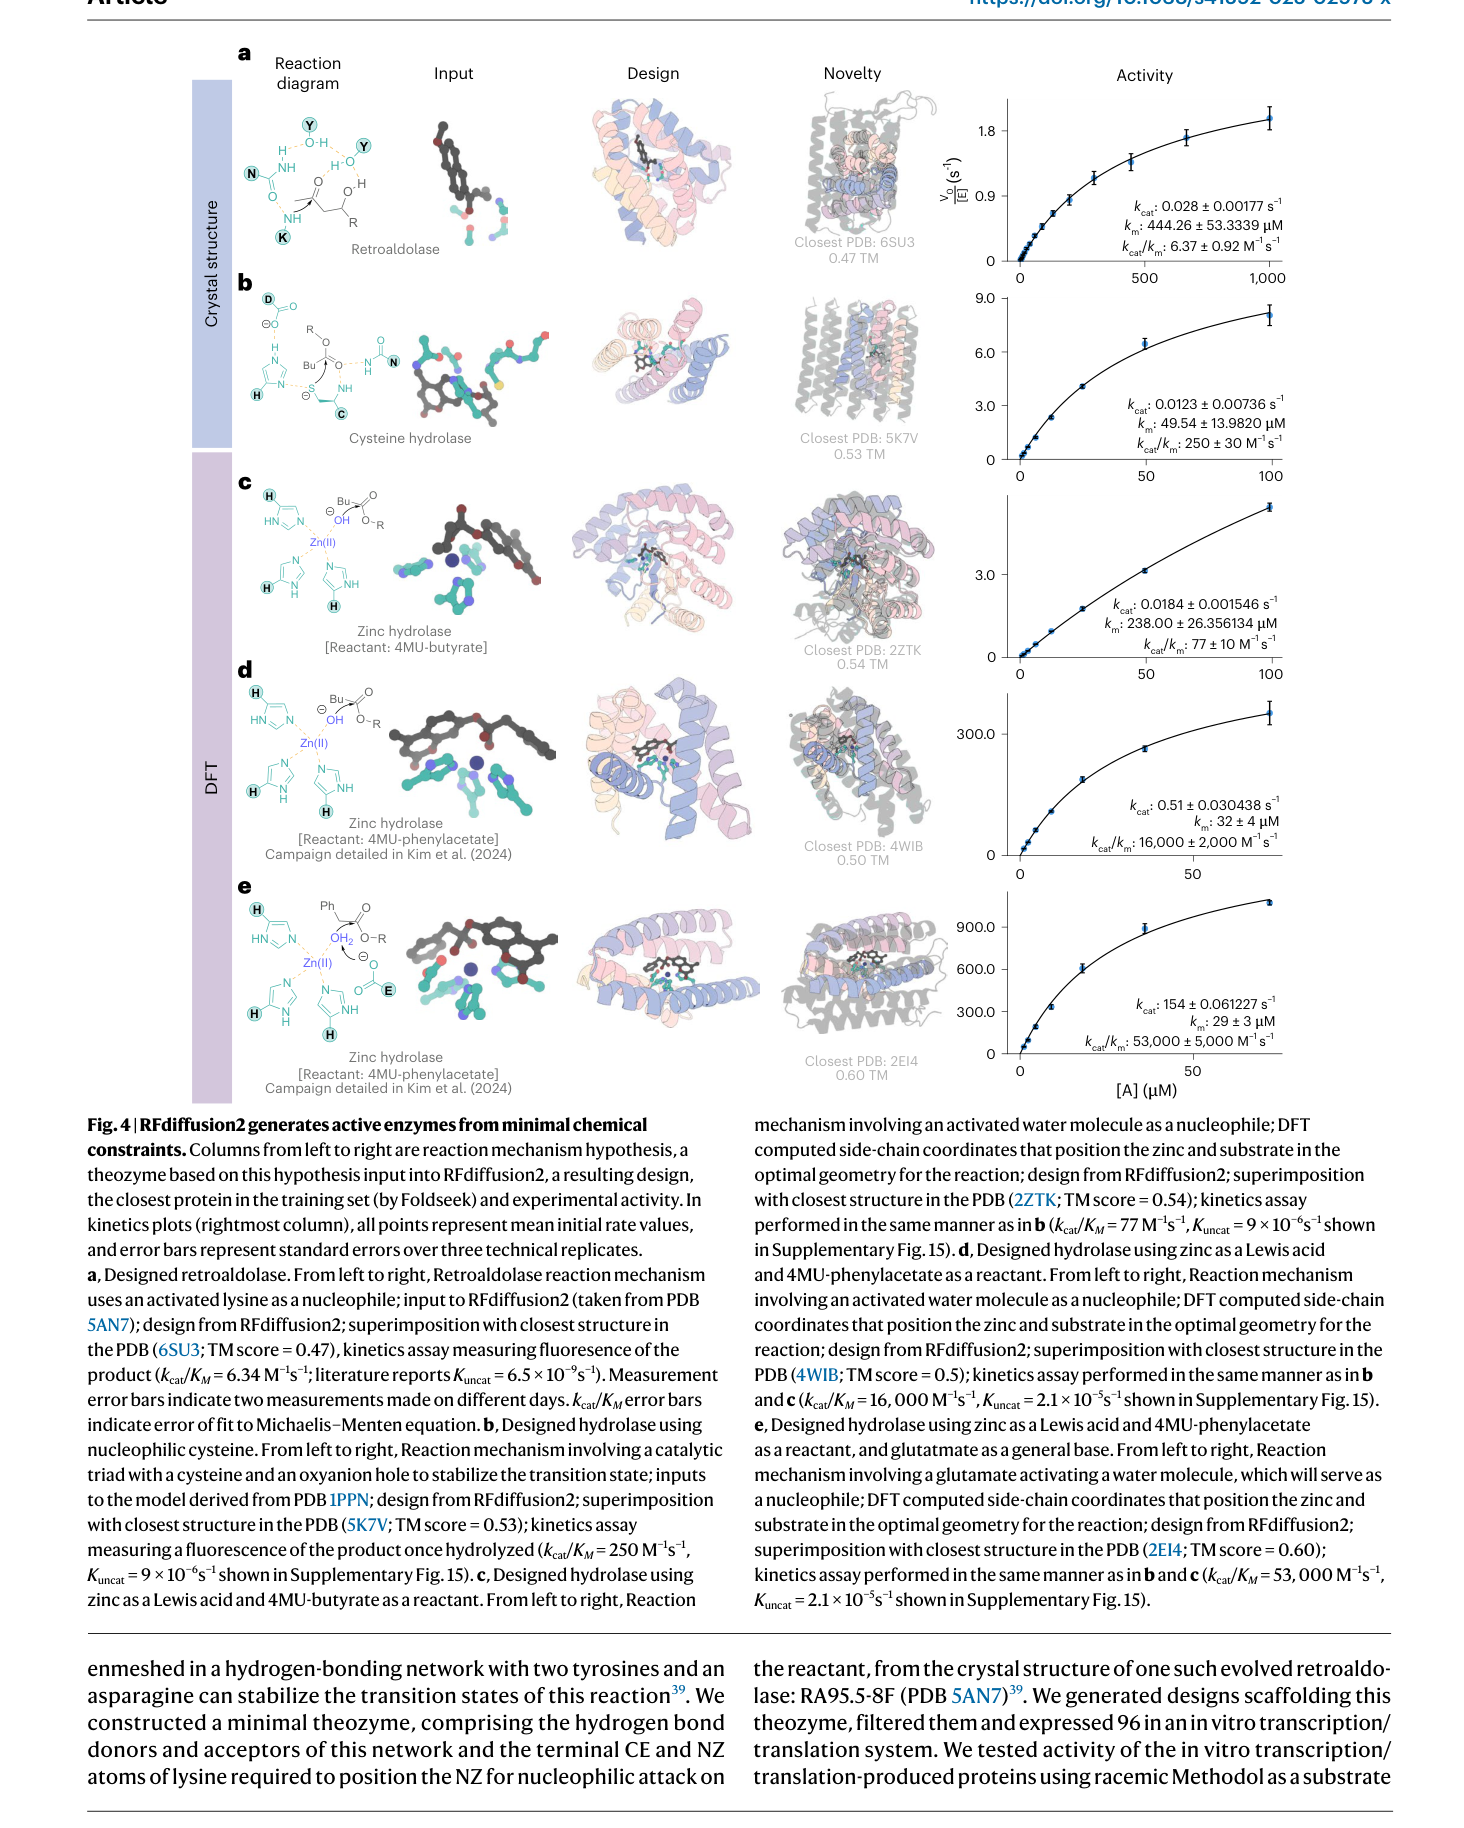
Fig 4 | 从最小化学约束设计功能酶。(a) 逆醛缩酶;(b) 半胱氨酸水解酶;(c-e) 三种锌水解酶。每列依次展示反应方程、DFT 输入、RFD2 设计、PDB 最近结构对比、Michaelis-Menten 动力学曲线。
路线 A:晶体结构来源的 theozyme
1. 逆醛缩酶(Retroaldolase)
Theozyme 来源:进化优化的 RA95.5-8F 晶体结构,包含 Lys 亲核催化中心 + Tyr/Asp/Asn 氢键网络。测试 96 个设计,4 个具有催化活性。
最优设计:kcat/KM = 6.34 ± 0.92 M-1s-1(论文给出的非催化速率为 6.5×10⁻⁹ s-1)。
2. 半胱氨酸水解酶(Cysteine hydrolase)
Theozyme:Cys-His-Asn 催化三联体,氧阴离子洞由半胱氨酸主链氮与一个谷氨酰胺共同稳定。测试 48 个设计,多个具有活性。
最优设计:kcat/KM = 248 M-1s-1,优于此前报道的所有计算设计的半胱氨酸酯酶。
路线 B:DFT 计算推导的 theozyme——最激进的测试
这条路线更具挑战性:输入不再来自已知酶的晶体结构,而是从反应机理出发,用量子化学计算(DFT)优化过渡态几何构型,提取金属配位和关键原子坐标作为 theozyme。
3. 锌水解酶-I(底物:4MU-butyrate)
DFT theozyme:Zn2+ + 咪唑配体 + 金属配位基团。96 个设计中 3 个具有功能。
最优设计:kcat/KM = 77 M-1s-1。
4. 锌水解酶-II(底物:4MU-phenylacetate)
同样基于 DFT theozyme 设计。
最优设计:kcat/KM = 16,000 M-1s-1——比此前报道的锌水解酶高出数个数量级。
5. 锌水解酶-III(谷氨酸广义碱)
采用 Glu 作为广义碱活化水分子。96 个设计中 11 个具有功能——命中率最高的一组。
最优设计:kcat/KM = 53,000 M-1s-1——五种酶中活性最高。
一个关键数字贯穿全部五组实验:每种酶测试的设计数量都不超过 96 个。这意味着 RFD2 的设计命中率已经足够高,使得从反应机理到功能酶的全流程在实际操作层面是可行的。
对比总结:RFD1 vs RFD2
从 RFD1 到 RFD2,本质上是蛋白质生成式设计从残基级拓扑设计迈向原子级功能设计的关键一步。
| RFD1 | RFD2 | |
|---|---|---|
| 表示粒度 | 残基级(Cα frame) | 原子级(所有重原子) |
| Motif 输入 | backbone position + rotamer + index | 只需功能基团原子坐标 |
| 序列索引 | 必须预先指定 | 可自动推断 |
| 旋转异构体 | 需预先枚举 | 可自动推断 |
| 训练框架 | DDPM + 辅助 loss | Flow matching,无辅助 loss |
| AME benchmark | 16 / 41 | 41 / 41 |
| 小分子建模 | 外部势函数(隐式) | 原子级配体坐标(显式) |
值得一提的是,RFD2 是 RFdiffusion 系列的第二代(RFD1 发表于 Nature 2023),而系列的第三代 RFD3(bioRxiv 2025)在此基础上进一步实现了全原子建模,将能力扩展到了 DNA 结合蛋白和小分子结合剂设计,性能再次提升。从 RFD1 到 RFD2 再到 RFD3,呈现的是蛋白质设计模型从”骨架拓扑”到”原子功能”的清晰演进路线。
五、局限与展望
设计酶的活性仍低于天然酶。五种设计酶中最优的 kcat/KM 为 53,000 M-1s-1,与天然酶动辄 106-108 M-1s-1 相比仍有差距。这部分源于 theozyme 本身的不完整——仅包含最关键的催化残基,没有建模完整的二级催化网络、水分子和完整过渡态动力学。
AME benchmark 受限于 PDB 来源。41 个测试案例全部来自 M-CSA 中的已知催化位点,本质上是对已知酶结构的”逆向工程”测试。对全新反应类型的 theozyme 设计能力还需要更多验证。
DFT theozyme 构建仍需专家知识。虽然 RFD2 极大降低了 scaffolding 这一步的门槛,但上游的 theozyme 设计——选择哪些催化残基、用什么金属配位几何、如何建模过渡态——仍然依赖深厚的酶学和量子化学经验。
未建模水分子和完整过渡态动力学。当前的 theozyme 输入只包含蛋白质侧链原子和配体原子,不包含结构水。对于许多水参与催化的酶(如锌水解酶中的水分子活化步骤),这是一个系统性的信息缺失。
通讯作者介绍
Rohith Krishna 是华盛顿大学蛋白质设计研究所(Institute for Protein Design, IPD)的研究科学家,博士毕业于华盛顿大学。他是 RoseTTAFold All-Atom 架构和 RFdiffusion 系列的核心开发者,参与了 RFD2 和 RFD3 的架构设计,在将蛋白质结构预测与生成模型从残基级推进到原子级的过程中发挥了关键作用。
David Baker 是华盛顿大学教授、霍华德·休斯医学研究所(HHMI)研究员、蛋白质设计研究所创始所长。他是计算蛋白质设计领域的开拓者,其团队开发的 Rosetta 软件套件和一系列深度学习方法(RFdiffusion、ProteinMPNN 等)奠定了现代蛋白质设计的技术基础。2024 年,Baker 与 Demis Hassabis、John Jumper 共同获得诺贝尔化学奖,以表彰他们在计算蛋白质设计和蛋白质结构预测领域的开创性贡献。
引用
Ahern, W., Yim, J., Tischer, D., Salike, S., Woodbury, S. M., Kim, D., … & Baker, D. (2026). Atom-level enzyme active site scaffolding using RFdiffusion2. Nature Methods, 23(1), 96-105. https://doi.org/10.1038/s41592-025-02975-x