
Boltz-2: Towards Accurate and Efficient Binding Affinity Prediction
原文链接:全文
作者:Saro Passaro, Gabriele Corso, Jeremy Wohlwend, …, Regina Barzilay
bioRxiv,2025 年 6 月 18 日
导读
Boltz-1 证明开源模型可以达到 AlphaFold3 级别的结构预测精度。但预测出三维结构只是药物发现的第一步——真正决定一个化合物能否成为药物候选分子的核心问题是:小分子与靶蛋白结合得有多紧?
目前最准确的结合亲和力计算方法是自由能微扰(FEP),但每个分子需要数小时到数天的分子动力学模拟,无法用于大规模筛选。Boltz-2 在 Boltz-1 的基础上新增亲和力预测模块,在 FEP+ 基准测试上达到与 FEP 方法相当的精度(Pearson r = 0.66 vs ABFE r = 0.75),而速度快了三个数量级。
除了亲和力预测,Boltz-2 在结构精度、可控性和动力学建模等方面也全面升级:RNA 预测 lDDT 从 0.45 跃升到 0.62,新增模板模块和多维度条件化系统,引入分子动力学数据实现柔性预测。本文将以 Boltz-1 为参照,逐项拆解 Boltz-2 从数据、架构、训练到应用的全部改进。
论文来自 MIT CSAIL、Jameel Clinic、Valence Labs、Recursion 和 ETH Zurich 的联合团队,模型代码和权重以宽松许可证完全开源。
一、研究问题
AlphaFold3 和 Boltz-1 解决的是”长什么样”的问题——给定蛋白质和配体的序列与结构,预测它们的三维复合物构象。但药物设计中更核心的问题是”结合多强”:一个化合物能否成为药物候选分子,取决于它对靶蛋白的结合亲和力(binding affinity)。
现有的亲和力计算方法形成两极分化的格局。一端是分子对接(如 Chemgauss4),速度快(秒级),但预测精度很低(Pearson r ≈ 0.26),只能做初步排序。另一端是自由能微扰(FEP),精度高(r ≈ 0.75),但每个分子需要数千到数万 CPU 小时的分子动力学模拟,对算力资源要求极高。在速度和精度之间的广大中间地带——既有合理精度又足够快——一直缺乏可靠工具。
这张图想回答:Boltz-2 在精度-速度权衡中占据什么位置——相比对接和 FEP 方法?
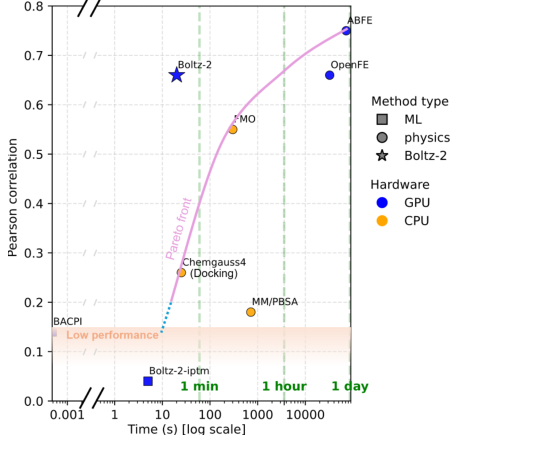
Figure 1|亲和力预测方法的精度-速度权衡:Boltz-2 在约 20 GPU 秒/分子的速度下达到 r ≈ 0.66,填补了对接与 FEP 之间的空白
Boltz-2 瞄准的正是这个空白。它的目标远不止加一个亲和力预测头这么简单——团队要构建的是一条从序列出发、经过结构预测、到亲和力评估、再到虚拟筛选和分子生成的完整 AI 药物发现流水线。在这条流水线中,Boltz-2 同时承担结构预测引擎和亲和力评估引擎的角色。
在 FEP+ 4-target 基准上,Boltz-2 达到 Pearson r = 0.66,接近 ABFE(r = 0.75)和 OpenFE(r = 0.65)的精度,但计算速度快了 1000 倍以上。在 CASP16 亲和力赛道上,Boltz-2 在零调优的情况下优于所有参赛选手。在虚拟筛选场景中,Boltz-2 的 enrichment factor 达到 18.4(0.5% 阈值),是传统对接方法的约 9 倍。
二、方法核心:训练数据升级:从静态结构到动态系综 + 亲和力标签
Boltz-1 的训练数据仅来自 PDB 中的静态晶体结构。Boltz-2 在结构数据、亲和力数据和合成阴性样本三个维度上进行了大幅扩展。
结构数据扩展
Boltz-2 在 PDB 实验结构的基础上,新增了三类重要数据来源:
分子动力学轨迹:纳入 MISATO(蛋白-配体 MD)、ATLAS(蛋白 MD)和 mdCATH(蛋白结构域 MD)三个数据集。这些轨迹让模型接触到蛋白质在溶液中的真实热运动——侧链摆动、loop 区涨落、结合口袋的呼吸运动。对于 MD 数据,Boltz-2 通过 B = (8π²/3) × RMSF² 公式将均方根涨落(RMSF)转化为 B-factor,作为局部柔性的监督信号。
NMR 系综结构:NMR 实验天然产生多个构象模型(通常 10–20 个),代表蛋白质在溶液中的构象分布。Boltz-1 未使用这类数据,Boltz-2 将其纳入训练,帮助模型学习构象多样性。
扩展蒸馏数据:使用 AlphaFold2 和 Boltz-1 本身的高置信度预测,覆盖更广泛的序列空间。相比 Boltz-1 仅使用 PDB 结构的蒸馏,Boltz-2 的蒸馏规模大幅扩展,尤其在 RNA 领域——这直接导致了 RNA 结构预测精度的显著提升。
亲和力数据策划
亲和力数据的收集和清洗是 Boltz-2 最繁重的数据工程之一。团队从多个公开数据库采集了数百万条结合测量数据,并进行了严格的质量控制:
数据来源:ChEMBL + BindingDB 提供 120 万条优化阶段测量值(Ki、Kd、IC50、EC50 等),PubChem HTS 提供约 20 万 binder 和 180 万 decoy 的高通量筛选数据,CeMM 片段筛选提供 11.5 万 decoy,MIDAS 代谢物数据集补充了 2 万 decoy。
统一标度:所有亲和力值统一转化为 log10(μM) 标度。Ki、Kd、IC50、EC50、AC50、XC50 等不同实验量度被映射到同一数轴上。
质量过滤:去除 PAINS(pan-assay interference compounds,泛测试假阳性化合物)和重原子数 > 50 的大分子;只保留单蛋白靶点的生化或功能测定数据;过滤低置信度 assay;按 90% 序列相似度做训练/测试集划分,避免数据泄露。
合成 decoy 生成
分类任务需要大量负样本(非结合分子),但实验数据中阴性结果的记录严重不足。Boltz-2 采用了一种巧妙的合成策略:将已知 binder 在不同靶点之间随机打乱配对——靶点 A 的已知 binder 被分配给靶点 B 作为 decoy。关键约束是确保每个 decoy 与该靶点所有已知 binder 的 Tanimoto 相似度低于 0.3,从而降低假阴性风险。这种方法生成了 120 万条合成 decoy,有效缓解了高通量筛选数据中的系统偏差。
训练数据总览
| 数据来源 | 类型 | 监督方式 | Binder 数 | Decoy 数 | 靶点数 | 化合物数 |
|---|---|---|---|---|---|---|
| ChEMBL + BindingDB | 先导优化 | 连续值 | 1.2M | 0 | 2k | 600k |
| PubChem 小 assay | 苗头发现 | 混合 | 10k | 50k | 250 | 20k |
| PubChem HTS | 苗头发现 | 二分类 | 200k | 1.8M | 300 | 400k |
| CeMM 片段 | 苗头发现 | 二分类 | 25k | 115k | 1.3k | 400 |
| MIDAS 代谢物 | 苗头发现 | 二分类 | 2k | 20k | 60 | 400 |
| 合成 decoy | 合成 | 二分类 | 0 | 1.2M | 2k | 600k |
三、看图说话
这张图想回答:Boltz-2 的架构如何在 Boltz-1 基础上新增模板模块、亲和力模块和可控性系统?
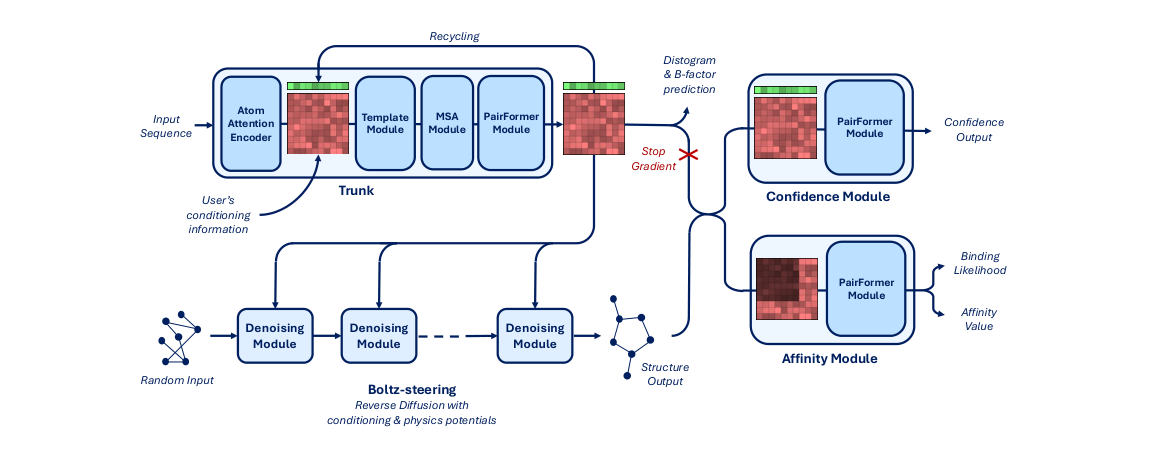
Figure 2|Boltz-2 模型架构:在 Boltz-1 的 Trunk + Confidence 基础上,新增 Template Module、Affinity Module 和增强的 Controllability 系统
Boltz-2 的架构在 Boltz-1 的 trunk + diffusion + confidence 三件套基础上做了四项重大改动。
Trunk 升级:更深、更大、更快
PairFormer 深度:从 Boltz-1 的 48 层增加到 64 层。更深的 PairFormer 让模型能够捕捉更复杂的残基间相互作用模式,尤其是跨链的远程联系。
Crop size:从 512 tokens 扩大到 768 tokens。更大的裁剪窗口意味着模型在训练时能”看到”更多的局部上下文,对大型复合物(如抗体-抗原、核糖体亚基)的覆盖显著改善。
混合精度训练:全面采用 bfloat16 混合精度,在保持数值稳定性的同时将显存占用和训练时间大幅压缩。
trifast 内核:继承并优化 Boltz-1 开发的 trifast 内核,加速 triangle attention 的计算——这是 PairFormer 中最耗时的操作。
Confidence Module 重设计
Boltz-1 的 Confidence Module 使用了与 trunk 同规模的完整 PairFormer(48 层),计算成本很高。Boltz-2 将其替换为一个轻量化的 8 层 PairFormer,大幅降低了置信度估计的计算开销。这一改动在不牺牲置信度预测质量的前提下,为亲和力模块腾出了算力预算。
Template Module(全新)
Boltz-1 完全不使用模板信息——这是它与 AlphaFold3 的一个重要差异。Boltz-2 新增了 Template Module,支持多链模板的整合。
用户可以提供已知的同源结构作为预测参考。模板信息以 token pair features 的形式注入模型,有两种使用模式:软引导(soft guidance)——模板作为先验信息影响预测但不强制;硬约束(template steering)——通过物理势函数在反向扩散过程中强制预测结构贴近模板。
多链模板支持意味着用户可以同时为复合物中的多条链提供参考结构——这在预测蛋白-蛋白相互作用时尤其有用,因为很多情况下我们知道单体结构但不确定复合物的界面取向。
Distogram 和 B-factor 预测头(全新)
Trunk 末端新增两个预测头:distogram 预测残基间距离分布(概率分布形式),B-factor 预测头预测每个原子的温度因子(B-factor),反映局部柔性。这些输出为下游的柔性分析和构象采样提供了结构级的先验信息。Boltz-1 缺乏这两项能力。
多维度可控性系统
Boltz-1 的可控性仅限于口袋条件化和基础的 Boltz-steering 物理约束。Boltz-2 构建了一个六维度的可控性框架,让用户可以从多个层面引导预测行为:
1. 实验方法条件化(Method Conditioning):指定预测模式为 X-ray、NMR 或 MD,模型会相应调整预测风格。例如,NMR 模式下模型倾向生成更多构象多样性;MD 模式下模型关注热涨落。这是 Boltz-1 完全不具备的能力。
2. 模板条件化(Template Conditioning):提供同源结构作为软参考,支持多链模板。模板信息编码为 token pair features 注入 trunk。
3. 模板引导(Template Steering):更强的硬约束版本——通过时间依赖的物理势函数,在反向扩散过程中持续将预测构象拉向模板。适合对结构有高置信度先验的场景。
4. 接触条件化(Contact Conditioning):用户指定特定残基或原子对之间的距离约束(4–20Å 范围),编码为 token pair features。适合整合交联质谱、FRET 等实验约束。
5. 口袋条件化(Pocket Conditioning):指定配体应结合的蛋白残基区域。Boltz-1 已有此功能,Boltz-2 做了增强。
6. 接触/口袋引导(Contact/Pocket Steering):与模板引导类似,通过时间依赖的势函数在扩散过程中硬性实施接触约束和口袋约束。
条件化和引导的区别在于:条件化通过模型内部的特征表示”建议”模型,模型最终综合所有信息做出决策;引导则通过外部势函数在扩散轨迹上直接施加力,更接近物理约束。用户可以根据对先验信息的确信程度选择合适的强度。
亲和力模块
亲和力模块是 Boltz-2 相对 Boltz-1 最核心的新增组件,也是整篇论文技术贡献的重心。它的设计思路是:直接从共折叠过程中学到的 pair representation 里提取结合强度信息,因为这些表示天然编码了蛋白-配体的空间接触模式和化学相互作用。
输入与架构
亲和力模块接收三类输入信号:
Trunk pair representation:包含残基-原子对之间通过 64 层 PairFormer 提炼出的全局相互作用信息。
3D 几何特征:从预测的三维坐标中提取蛋白-配体原子对的距离和方向信息,捕捉空间互补性。
配体内部几何特征:配体自身的构象信息(键角、扭转角等),反映配体在结合口袋中的适配状态。
这些信息经过一个专用 PairFormer 整合处理。这个 PairFormer 有一个关键的设计选择:它只关注蛋白-配体相互作用和配体内部相互作用,通过掩码(mask)屏蔽了蛋白内部的残基-残基交互——因为蛋白自身的折叠状态与配体的结合强度关系不大,去掉这些冗余信息可以让模型聚焦于真正相关的信号。
PairFormer 的输出经过 mean pooling 压缩为全局表示,再分别送入两个输出头:
Binding Likelihood 头:预测该配体是否为该蛋白的真实 binder(二分类任务)。这是一个”能结合吗?”的定性判断,主要用于虚拟筛选中的高通量过滤——在百万级化合物库中快速排除明显不结合的分子。
Affinity Value 头:预测连续的结合亲和力值(回归任务),输出可近似理解为 log10(μM) 标度的 IC50 值。这是一个”结合多强?”的定量预测,用于 hit-to-lead 和 lead optimization 阶段对同系列化合物进行精细排序。
一个重要的注意事项:由于训练数据混合了 Ki、Kd、IC50、EC50、XC50 等不同测量方式,affinity value 最好理解为一个近似的 IC50 级别的排序打分,在同一 assay 或化学系列内比较最有意义,跨 assay 直接比较绝对值需要谨慎。
亲和力训练方法论
亲和力模块的训练包含多项精心设计的策略,解决了跨 assay 偏差、稀疏标签和不确定限定符等生物实验数据的固有难题。
两阶段训练
训练严格分为两个阶段。第一阶段完成结构预测和置信度训练(与 Boltz-1 类似),确保 trunk 具备成熟的结构感知能力。第二阶段冻结 trunk 的梯度,只训练亲和力模块的参数。这种冻结策略至关重要——如果允许亲和力训练反传梯度到 trunk,结构预测精度会因为过度优化亲和力目标而退化。
口袋预计算与亲和力裁剪
完整的蛋白-配体 pair representation 可能有数万个 token 对,全部保留会导致显存爆炸。Boltz-2 采用了口袋预计算策略:
对每个靶蛋白,随机选取 10 个已知 binder,分别预测复合物结构,计算蛋白-配体原子距离,取共识口袋(consensus pocket)。然后进行亲和力裁剪:最多保留 256 个 token,其中蛋白 token 上限 200 个,围绕口袋中心做约 10 个 token 的局部邻域扩展。
这一策略将亲和力训练的显存消耗降低 5 倍,同时通过聚焦口袋区域的 pair features 过滤掉远端无关信息。
活性悬崖采样(Activity Cliff Sampling)
亲和力训练面临的最大挑战之一是:不同 assay 之间的绝对值存在系统偏差(IC50 在不同实验条件下可以差几个数量级),但同一 assay 内部化合物之间的相对排序是可靠的。
Boltz-2 的解决方案是活性悬崖采样:每个训练 batch 从同一 assay 中采样 5 个化合物。assay 的采样权重由其亲和力值的四分位距(IQR)决定——IQR 越大,说明该 assay 内化合物的活性变化越大,包含更多的”活性悬崖”信号(结构微小变化导致活性剧烈变化的样本对),对训练更有价值。分类任务则采样 1 个 binder + 4 个 decoy。
成对亲和力损失函数
损失函数设计是整个亲和力训练方案中最精巧的部分:
Ltotal = 0.9 × Ldif + 0.1 × Labs + Lbinary
Ldif(成对差异损失,权重 0.9):计算同一 assay 内两两化合物的亲和力差值的预测误差。这是最核心的信号——它利用差值运算天然消除了跨 assay 的系统偏差。如果 assay A 整体偏高 1 个对数单位,差值运算后这个偏差就被抵消了。
Labs(绝对值损失,权重 0.1):直接预测绝对亲和力值,使用 Huber 损失(对离群值更鲁棒)。权重较低,主要起锚定作用。
Lbinary(二分类损失):binder vs decoy 的分类,使用 focal loss(对难分样本给更高权重)。
审查感知处理(Censor-aware):实验数据中经常出现”>”或”<“限定符(如 IC50 > 10 μM,只知道活性低于某阈值但不知道具体值)。损失函数对这类截断值做了特殊处理,避免将下限当作精确值来训练。
这套方案的核心洞察是:在药化实践中,同一系列化合物之间的相对排序远比跨系列的绝对值更重要。成对差异损失的 0.9 权重体现了这一优先级。
结构预测精度
这张图想回答:在 2024-2025 年新发布的 PDB 结构上,Boltz-2 的结构预测指标比 AF3 和 Chai-1 强多少?
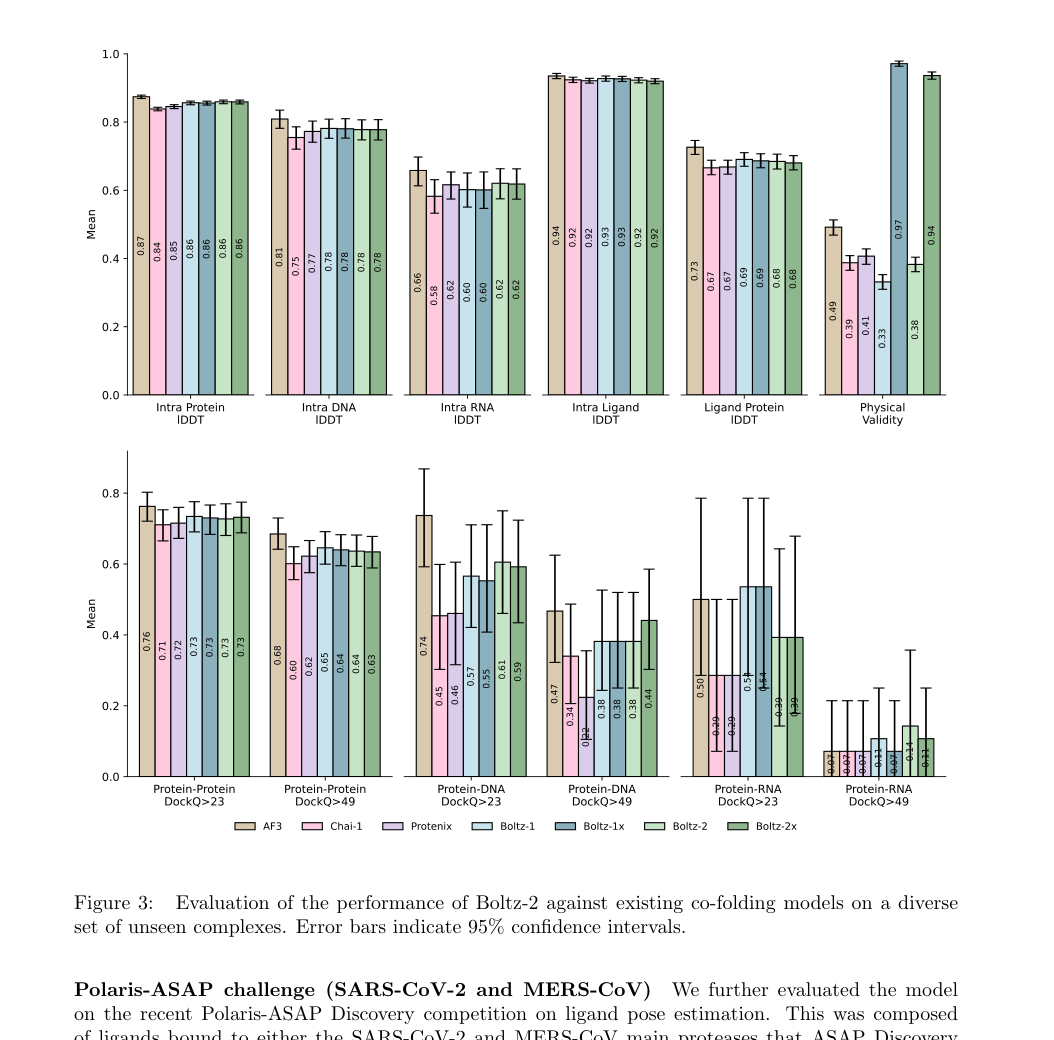
Figure 3|Boltz-2 与 AlphaFold3、Chai-1、Protenix、Boltz-1 在 12 项结构预测指标上的对比(2024–2025 年新发布 PDB 结构)
在 2024–2025 年新发布的 PDB 结构上,Boltz-2 相对 Boltz-1 的结构预测精度呈现清晰的提升模式:
RNA 结构预测:最大的突破。Boltz-2 的 Intra RNA lDDT 从 Boltz-1 的约 0.45 跃升到约 0.62,提升了近 40%。这一突破直接归因于大规模 RNA 蒸馏数据的引入——Boltz-1 在 RNA 方面的训练数据有限,而 Boltz-2 利用 AlphaFold2 和自身的 RNA 预测扩展了数据覆盖面。
DNA-蛋白复合物:另一个提升显著的模态。扩展训练数据和更深的 PairFormer 改善了模型对核酸-蛋白界面的建模能力。
蛋白内部结构(Intra Protein lDDT):Boltz-2 与 AlphaFold3 持平,略优于 Boltz-1。蛋白单体折叠已经相当成熟,提升空间有限。
蛋白-蛋白界面和蛋白-配体界面:与 Boltz-1 接近或略优。
抗体-抗原:相对 Boltz-1 有明显提升(DockQ > 0.49 的比例更高),但仍落后于 AlphaFold3。这仍是开源模型的待攻关方向。
Polaris-ASAP 药物发现挑战赛:84.8% 的成功率,无需微调直接提交。
物理合理性:Boltz-2x(加 steering)达到约 96% 的物理合理性(无键断裂、无原子碰撞),与 Boltz-1x(97%)持平。
总体而言,Boltz-2 在结构预测维度上做到了”全面不退步,重点有突破”——在大幅新增亲和力预测能力的同时,没有牺牲核心的结构预测质量。
动态构象与柔性预测
蛋白质在生理条件下是动态的——侧链不断摆动,loop 区反复开合,结合口袋在”开放”与”封闭”之间转换。Boltz-1 只能预测静态结构,Boltz-2 通过引入 MD 训练数据和实验方法条件化,迈出了构象系综建模的第一步。
RMSF 预测精度:在 mdCATH 数据集上,Boltz-2 的逐靶点 RMSF Pearson 相关系数达到 0.79;在 ATLAS 数据集上达到 0.85。这意味着模型能较准确地预测蛋白质各位点的柔性程度——哪些区域是刚性核心,哪些区域是柔性 loop。
与专用模型对比:Boltz-2 的 RMSF 预测精度与 BioEmu 和 AlphaFlow 等专门为构象系综设计的模型处于同一水平。这两个模型以再现 MD 轨迹的多样性为核心目标,而 Boltz-2 只是附带地学到了这一能力。
局限性:在构象多样性指标(diversity metrics)上,Boltz-2 仍然低于 BioEmu 和 AlphaFlow。模型更擅长预测”哪里柔性”,但在”生成多种不同构象”方面还有差距——它目前更像是预测动态的幅度,而非完整再现 MD 轨迹的构象分布。
MD 条件化开启时,模型生成的构象系综多样性会增加。这为药物设计中的”induced-fit”场景提供了初步支持——虽然大尺度构象变化仍然难以捕捉,但口袋区域的局部调整已经有所改善。
亲和力预测评测
这张图想回答:Boltz-2 在四组亲和力基准上的表现如何——相比 FEP+ 和其他打分函数?
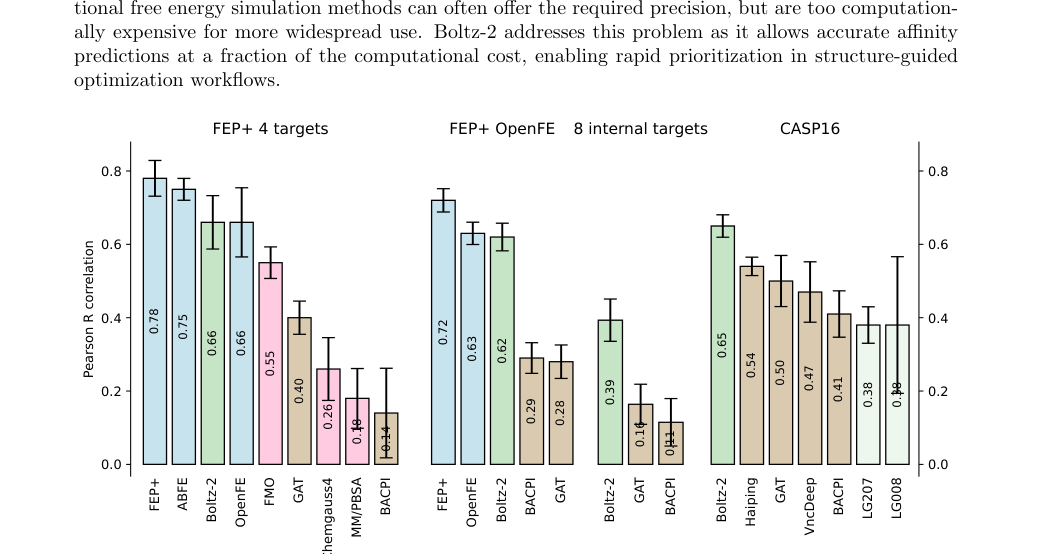
Figure 6|Boltz-2 在 FEP+ 4-target、OpenFE 全集、8 个内部 assay 和 CASP16 四组亲和力基准上的表现
论文在四个独立基准上全面验证了亲和力预测能力,每个基准代表不同的应用场景:
基准 1:FEP+ 4-target(CDK2、TYK2、JNK1、P38)
这是 FEP 领域最经典的基准集,四个激酶靶点各有数十个同源化合物的实验亲和力值。结果对比:
- Boltz-2:R = 0.66(约 20 GPU 秒/分子)
- FEP+:R = 0.78(数千 CPU 小时/分子)
- ABFE:R = 0.75(>20 GPU 小时/分子)
- OpenFE:R = 0.66(6–12 GPU 小时/分子)
- FMO:R = 0.55
- Chemgauss4(对接):R = 0.26
- MM/PBSA:R = 0.18
- BACPI(ML):R = 0.14
Boltz-2 与 OpenFE 精度相当(都是 0.66),但速度差距巨大:OpenFE 每个分子需要 6–12 GPU 小时,Boltz-2 只需约 20 GPU 秒——快了约 1000–2000 倍。
基准 2:OpenFE 全集(876 个复合物)
覆盖更多靶点和化学系列的大规模验证。Boltz-2 R = 0.62,OpenFE R = 0.63——精度基本持平。机器学习基线 GAT(R = 0.28)和 BACPI(R = 0.29)则远远落后。
基准 3:CASP16 亲和力赛道
CASP16 是结构预测领域的”奥林匹克”。在 140 个蛋白-配体对的亲和力预测赛道上,Boltz-2 达到 R = 0.65,优于所有参赛选手(最佳竞争者约 R = 0.54)。
值得强调的是,许多参赛团队使用了定制输入和专项微调,而 Boltz-2 是零调优直接提交——未针对 CASP16 的靶点做任何适配。
基准 4:Recursion 内部 8-target 药化评测
这是最接近真实药物发现场景的验证。8 个 assay 来自 Recursion 的在研项目,覆盖不同蛋白家族。Boltz-2 的平均 R = 0.39(范围 0.165–0.634),大幅超越 ML 基线 GAT(R = 0.16)和 BACPI(R = 0.11)。
坦诚的不稳定性:跨 assay 的 R 值波动很大(最低 0.165,最高 0.634),反映了模型在不同蛋白家族、不同化学空间上的泛化能力仍有差距。部分 GPCR 靶点上的表现有限——这也是 FEP 方法的已知弱项,可能与膜蛋白的特殊构象环境有关。
虚拟筛选
亲和力预测的终极应用场景之一是大规模虚拟筛选——从数十万到数百万化合物中筛选出可能的活性分子。Boltz-2 在 MF-PCBA 虚拟筛选基准上进行了全面评测:
平均精度(AP):Boltz-2 = 0.0248,GAT = 0.0133,BACPI = 0.0131,Chemgauss4 = 0.0051
富集因子(EF@0.5%):Boltz-2 = 18.39(在前 0.5% 预测中,活性分子的密度是随机的 18.39 倍)
富集因子(EF@1%):Boltz-2 = 13.95
AUROC:Boltz-2 = 0.812
一个特别有意义的发现是:Boltz-2 的亲和力模块远比结构置信度分数更适合做虚拟筛选。用 Boltz-2 的 ipTM(interface predicted TM-score,结构置信度指标)做筛选,AP 仅为 0.0046——只有亲和力模块的 1/5。这说明结构预测准确并不意味着模型能判断结合强度:一个分子可以在口袋里有合理的结合姿态(高 ipTM)但结合很弱,反之亦然。亲和力模块学到的是更深层的结合强度信号。
四、核心贡献总结
这张图想回答:在 TYK2 靶点的前瞻性虚拟筛选中,Boltz-2 打分与 ABFE 计算值的相关性有多高?
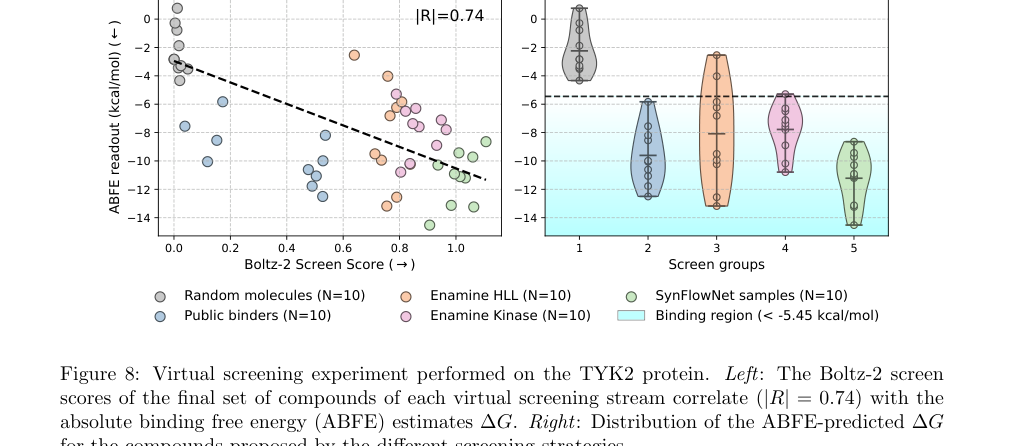
Figure 8|TYK2 靶点前瞻性虚拟筛选:Boltz-2 打分与 ABFE 计算值的相关性(左),以及不同来源候选分子的 ABFE 分布(右)
论文设计了一项完整的端到端药物发现工作流验证,以 TYK2 激酶为靶点,分两步展开:
第一步:固定化合物库筛选
从两个商业库中筛选:Enamine Hit-Likeness Library(HLL,约 46 万分子)和 Enamine Kinase Library(约 6.5 万分子)。Boltz-2 对每个分子预测亲和力打分,然后取各库的 Top-10 和 10 个随机分子,送 ABFE 做独立验证:
- HLL Top-10:8/10 被 ABFE 预测为 binder
- Kinase Library Top-10:10/10 被 ABFE 预测为 binder
- 随机 10 个分子:全部被 ABFE 预测为 non-binder
第二步:de novo 分子生成(SynFlowNet)
更有雄心的验证是将 Boltz-2 与 GFlowNet 生成模型 SynFlowNet 耦合,直接在化学空间中搜索新分子。SynFlowNet 从 Enamine 76B REAL 可合成化学空间中采样分子(760 亿可合成分子),Boltz-2 提供结合打分作为奖励信号。
- 采样约 40 万分子,11.7 万独特分子经 Boltz-2 评估
- 选出 10 个多样性候选分子,全部被 ABFE 预测为 binder
- 生成分子的平均亲和力高于固定商业库中的最佳候选
- Boltz-2 打分与 ABFE 的相关性:|R| = 0.74
- 与已知 TYK2 配体的最大 Tanimoto 相似度仅 0.396——这些是全新的化学骨架
这一结果展示了 Boltz-2 作为”AI 药物发现引擎”的潜力:从序列出发,预测结构,评估亲和力,引导生成模型在数百亿化学空间中定向搜索,最终产出新骨架、可合成的候选分子。
三个重要注意事项
论文诚实地指出了 TYK2 实验的三个局限:(1)ABFE 验证并非湿实验——最终候选分子尚未经过体外/体内实验确认;(2)TYK2 是亲和力预测的”有利”靶点(在基准测试中 R = 0.83,高于平均水平),结果可能不代表所有靶点的表现;(3)未评估候选分子的毒性、溶解度和选择性——这些在真实药化中同样关键。
五、局限与展望
Boltz-2 论文用了相当的篇幅坦诚讨论模型的局限。对于要在实际药物项目中使用 Boltz-2 的团队来说,理解这些边界条件至关重要:
1. 结构误差的级联传播:亲和力模块的输入是预测的 3D 结构——如果 binding pocket 预测不准确(错误的口袋、错误的配体姿态),亲和力预测会随之不可靠。结构预测和亲和力预测之间存在紧密耦合,上游误差会向下游放大。
2. 缺失的生物环境:当前模型不显式处理辅因子、结构水分子、金属离子等。这些在许多酶(如金属蛋白酶)和受体的结合机制中发挥关键作用。缺失这些元素可能导致对特定靶点的亲和力预测系统性偏低。
3. 固定 256-token 亲和力裁剪窗口:亲和力模块只”看到”口袋周围最多 256 个 token 的区域。这意味着变构效应(allosteric effects)——配体结合在一个位点影响远端位点的行为——完全无法被捕捉。对于变构药物设计,这是一个根本性的限制。
4. 大尺度构象变化:虽然引入了 MD 数据,模型仍然难以预测诱导契合(induced-fit)等大幅度构象重排。蛋白在结合配体后可能发生显著的结构域运动,目前的扩散模型架构和训练数据规模都不足以可靠捕捉这类变化。
5. 跨 assay 泛化的不稳定性:在 16-assay 验证集上,逐 assay 的 Pearson R 从 0.056 到 0.732 不等——变化幅度超过 10 倍。这说明模型在某些蛋白家族和化学空间上的泛化能力仍然有限。用户在新靶点上使用 Boltz-2 时,应先在已知活性化合物上校准预期。
6. 数据清洗的固有噪声:训练数据中 IC50 未转化为 Ki,细胞实验和生化实验数据混在一起,HTS 数据中估计有约 40% 的假阳性。这些噪声会成为亲和力预测精度的上限。
7. 缺乏完整消融实验:由于模型规模大(64 层 PairFormer + 扩展数据 + 亲和力模块),论文无法对每一项改进做独立的消融实验。我们无法确切知道精度提升中有多少归因于更深的网络、有多少归因于更多的数据、有多少归因于训练策略。
Boltz-1 → Boltz-2 升级一览
| 维度 | Boltz-1 | Boltz-2 |
|---|---|---|
| 结合亲和力 | 不支持 | 新增亲和力模块,逼近 FEP 精度(R = 0.66) |
| 虚拟筛选 | 仅可通过 ipTM(效果差) | 专用 binding likelihood 头(EF@0.5% = 18.4) |
| 模板 | 不使用 | 支持多链模板,软引导 + 硬约束 |
| 训练数据 | PDB 静态结构 | PDB + MD 轨迹 + NMR 系综 + 扩展蒸馏 + 亲和力数据 |
| 可控性 | 口袋条件化 + 基础 steering | 方法 + 模板 + 接触 + 口袋条件化,各有 steering 版 |
| PairFormer | 48 层 | 64 层 |
| Confidence Module | 完整 48 层 PairFormer(昂贵) | 轻量 8 层 PairFormer |
| Crop size | 512 tokens | 768 tokens |
| RNA 精度 | lDDT ≈ 0.45 | lDDT ≈ 0.62(+38%) |
| 动力学 | 不支持 | B-factor 预测 + MD 条件化 + RMSF 相关 0.79–0.85 |
| Distogram | 不支持 | Trunk 输出距离分布 |
| 精度(混合) | float32 | bfloat16 混合精度 |
通讯作者介绍
Saro Passaro、Gabriele Corso 和 Jeremy Wohlwend 为本文的共同通讯作者,三人均就职于 MIT CSAIL 和 MIT Jameel Clinic,也是 Boltz-1 的核心开发者。Boltz-2 的作者团队在 Boltz-1 基础上大幅扩展,新增了来自 Valence Labs、Recursion 和 ETH Zurich 的合作者,体现了模型从纯结构预测向药物发现应用的延伸。Stephan Thaler(Valence Labs / Recursion)是亲和力模块的核心贡献者,Vignesh Ram Somnath(ETH Zurich)负责生成模型(SynFlowNet)与 Boltz-2 的耦合设计。资深指导者 Regina Barzilay 教授(MIT CSAIL,School of Engineering Distinguished Professor)在 AI 药物发现领域深耕多年,她的系列工作为 Boltz 从学术原型走向实际应用提供了持续的推动力。
引用
Passaro, S., Corso, G., Wohlwend, J., Reveiz, M., Thaler, S., Somnath, V. R., … & Barzilay, R. (2025). Boltz-2: Towards Accurate and Efficient Binding Affinity Prediction. bioRxiv. https://doi.org/10.1101/2025.06.14.659707